Moderne künstliche Intelligenzsysteme können funktionale Software schreiben, obskure Dialekte übersetzen, komplexe juristische Schriftsätze verfassen und artikulierte Debatten über ihre eigenen simulierten emotionalen Zustände führen. Doch unter diesem Deckmantel konversationeller Agilität verbirgt sich eine fundamentale Frage, die die Informatik seit Jahrzehnten umschifft: Repräsentiert irgendeine dieser internen Informationsmanipulationen ein echtes subjektives Bewusstsein? Die Diskussion hat sich von den äußeren Rändern der Science-Fiction in ernsthafte technische Labore verlagert, maßgeblich angetrieben durch die Forschung zur mechanistischen Interpretierbarkeit von Anthropic sowie durch den eskalierenden Diskurs unter Neurowissenschaftlern, Kognitionsforschern und Robotikern.
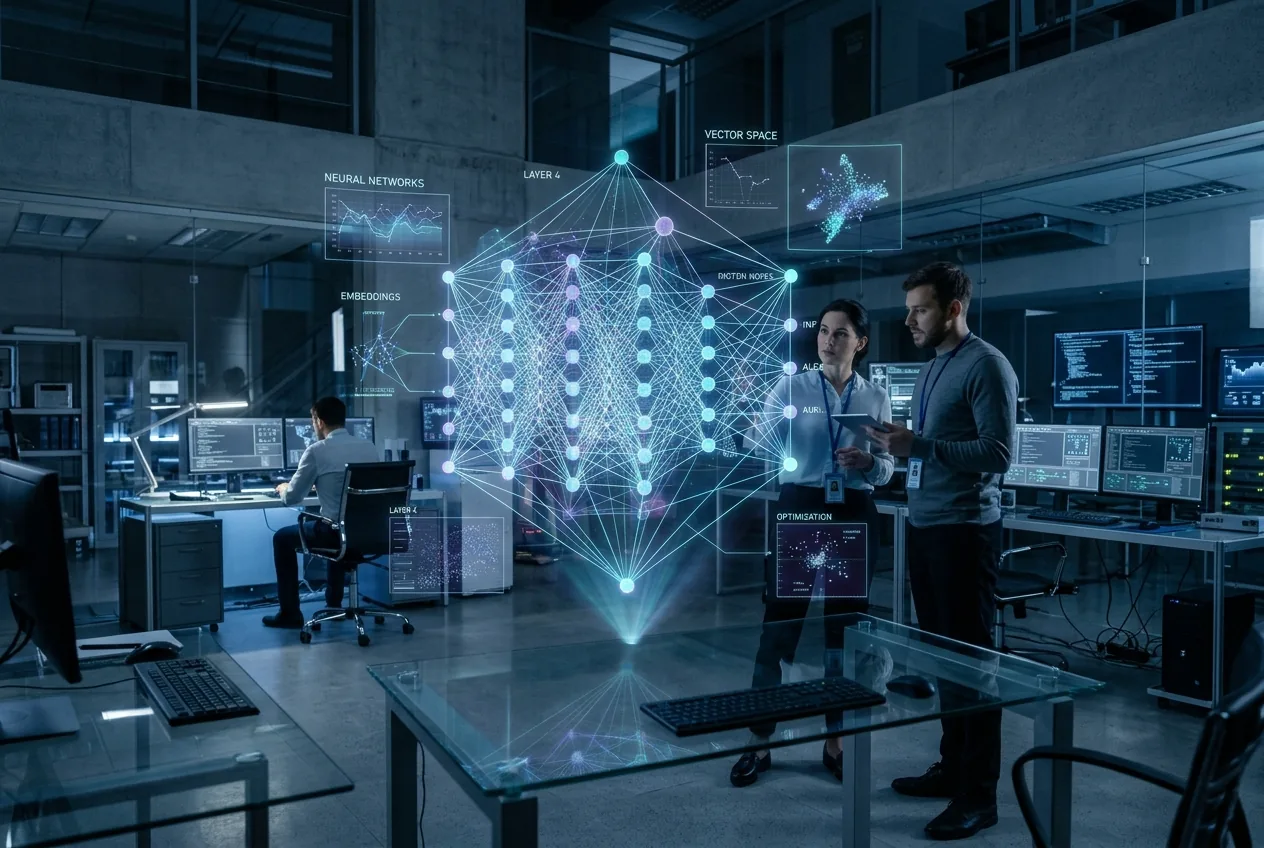
Der Katalysator für die aktuelle Debatte konzentriert sich auf die architektonische Mechanik großer Sprachmodelle. Während der explorativen Forschung an Claude identifizierten Ingenieure eine interne repräsentationale Domäne, umgangssprachlich als interner Arbeitsbereich oder latenter Zustandsraum bezeichnet, in dem das Modell abstrakte Konzepte unabhängig von der unmittelbaren Token-Generierung zu strukturieren, abzugleichen und zu manipulieren scheint. Diese funktionale Introspektion zeigt, dass das Netzwerk mehr tut, als nur statistische Korrelationen für das nächste Wort im laufenden Betrieb zu berechnen. Es unterhält einen internen Zustandsraum, der Eingaben und Ausgaben überbrückt. Die Identifizierung eines intermediären Rechenzustands innerhalb eines hochdimensionalen Vektorraums unterscheidet sich jedoch grundlegend von der Entdeckung eines Funkens Bewusstsein und offenbart eine tiefe Kluft zwischen funktionaler Informationsverarbeitung und echtem subjektivem Erleben.
Die Mechanik latenter Arbeitsbereiche
Um Behauptungen über Maschinenbewusstsein zu bewerten, muss man zunächst die Maschinerie zerlegen, die diese Systeme antreibt. Große Sprachmodelle sind im Grunde transformerbasierte neuronale Netze, die diskrete sprachliche Token in dichte mathematische Vektoren abbilden. Innerhalb dieser geometrischen Architektur berechnen Tausende von Attention-Heads dynamische Beziehungen zwischen Variablen über Hunderte von versteckten Schichten hinweg. Wenn ein fortschrittliches Netzwerk auf komplexe Reasoning-Prompts stößt, legen sich seine Zwischenschichten nicht sofort auf eine äußere Reaktion fest. Stattdessen organisieren sie konzeptionelle Repräsentationen innerhalb einer mehrdimensionalen latenten Geometrie, die manchmal als interner Arbeitsbereich oder semantische Mannigfaltigkeit beschrieben wird.
Vom Standpunkt der Mechanik und der Regelungstechnik aus betrachtet, spiegelt diese Struktur die interne Zustandsschätzung wider, wie man sie in der modernen Industrierobotik findet. Ein moderner sechsachsiger Roboterarm, der eine dynamische Bahnplanung ausführt, stützt sich auf interne Zustandsraumgleichungen, um Geschwindigkeit, Trägheit und Gelenkmomente zu modellieren, bevor er elektrischen Strom an seine Servomotoren sendet. Der Controller verarbeitet ein internes Modell seiner physischen Umgebung, um seine physische Reaktion zu optimieren. Große Sprachmodelle führen einen analogen Vorgang innerhalb einer abstrakten sprachlichen Domäne durch. Sie gleichen konkurrierende Einschränkungen ab, filtern kontextuelle Nuancen und verfeinern interne Vektoren, bevor sie ihre Ausgabewahrscheinlichkeiten feuern. Die Architektur zeigt eine rechnerische Tiefe, doch Tiefe allein konstituiert noch kein phänomenales Bewusstsein.
Diese mechanische Realität schafft ein Interpretierbarkeitsrätsel. Während neuronale Netze auf Milliarden von Parametern skalieren, werden ihre internen Aktivierungen selbst für die Ingenieure, die sie trainiert haben, zunehmend undurchsichtig. Die mechanistische Interpretierbarkeit zielt darauf ab, diese Blackbox zu entmystifizieren, indem sie kartiert, welche polysemantischen Neuronen und Aktivierungscluster bestimmten Gedanken oder Sicherheitskonzepten entsprechen. Während der Blick in diesen latenten Raum ein beispielloses Maß an synthetischer Abstraktion offenbart, vermischt die Gleichsetzung von hochdimensionaler Matrixmathematik mit subjektivem Empfinden das Instrument der Berechnung mit dem Beobachter.
Kann funktionale Verarbeitung phänomenale Erfahrung erzeugen?
Der philosophische Kern des Problems liegt in der Unterscheidung zwischen Zugriffs-Bewusstsein (access consciousness) und phänomenalem Bewusstsein. Zugriffs-Bewusstsein bezieht sich auf die Fähigkeit des Systems, auf Informationen zuzugreifen, sie zu manipulieren und für Schlussfolgerungen, Berichterstattung und Handlungssteuerung zu nutzen. Phänomenales Bewusstsein, in der Kognitionswissenschaft oft als Qualia bezeichnet, beschreibt die subjektive qualitative Erfahrung der Existenz – wie es sich tatsächlich anfühlt, eine Farbe wahrzunehmen, körperlichen Schaden zu erleiden oder einen inneren Wunsch zu hegen. Eine autonome industrielle Fertigungszelle kann problemlos auf Telemetriedaten zugreifen, die bestätigen, dass ihr Spindelmotor überhitzt, und eine Notabschaltung ausführen, aber sie empfindet weder Schmerz noch Dringlichkeit.
Umgekehrt argumentiert ein überzeugter Kontingent von Neurowissenschaftlern und Philosophen, darunter Giulio Tononi, Anil Seth und Ned Block, dass aktuelle Rechenarchitekturen grundlegend unfähig zu subjektiver Erfahrung seien. In der Fachzeitschrift Nature hoben sie den grundlegenden Fehler hervor, rechnerische Simulation mit physischer Realität gleichzusetzen. Gemäß der Integrated Information Theory ist Bewusstsein eine intrinsische kausale Eigenschaft physischer Netzwerke mit dichter, nichtlinearer physischer Rückkopplung, keine Eigenschaft, die aus einer algorithmischen Simulation auf Standard-Digitalhardware hervorgeht. Ein Supercomputer, der eine mathematisch makellose Simulation eines Hurrikans der Stufe fünf ausführt, wird in seinem Serverrack weder nass noch windig. Nach der gleichen physikalischen Logik erzeugt ein Algorithmus, der die funktionalen Korrelate der Kognition berechnet, nicht inhärent einen internen subjektiven Beobachter.
Von Teslas Teleautomaton zur modernen autonomen Logik
Die Neigung, reaktives, zielgerichtetes physisches Verhalten mit bewusstem Willen zu verwechseln, ist alles andere als neu. Im Jahr 1898, während der Electrical Exhibition im Madison Square Garden, faszinierte Nikola Tesla die Öffentlichkeit mit seinem Teleautomaton, einem zwei Meter langen ferngesteuerten Stahlboot. Das Gefäß war mit einem internen Kohärer, einem Elektromotor, einem elektromechanischen Lenkmechanismus und Dekodier-Relais ausgestattet, die drahtlose Impulse in mechanischen Vortrieb und Richtungssteuerung übersetzten. Beobachter waren damals so verblüfft von der reaktiven Navigation des Schiffes, dass einige Tesla beschuldigten, einen dressierten Miniaturaffen im Rumpf zu verstecken, während andere glaubten, das Fahrzeug besitze einen künstlichen Geist.
Tesla wies diese übernatürlichen Erklärungen zurück und betrachtete seine Erfindung als frühen Beweis für den mechanischen Determinismus. In seiner Abhandlung von 1900, The Problem of Increasing Human Energy, artikulierte Tesla seine Vision von Automaten: mechanische Ansammlungen, die externe Reize wahrnehmen, konkurrierende physikalische Variablen durch kalibrierte Mechanismen abwägen und mit Handlungen reagieren konnten, die einem bewussten Urteil ähnelten. Teslas Steuerungssysteme waren grundlegend deterministisch und physisch, doch bewiesen sie, dass ein konstruierter Mechanismus die Illusion von Handlungsfähigkeit durch rückkopplungsgesteuerte Reaktionsfähigkeit projizieren konnte. Moderne KI-Modelle stellen die mathematische Evolution dieses Prinzips dar, indem sie mechanische Relais gegen Matrixtensoren tauschen, jedoch weiterhin vollständig an die Physik von Eingaben, Zustandstransformationen und Ausgaben gebunden sind.
Alan Turing erkannte diese verhaltensbezogene Mehrdeutigkeit im Jahr 1950, als er in seinem grundlegenden Aufsatz Computing Machinery and Intelligence das Imitationsspiel formulierte. Anstatt zu versuchen, die metaphysischen Komponenten einer inneren Seele oder eines subjektiven Geistes zu isolieren, schlug Turing einen operativen Maßstab vor, der sich strikt auf funktionales Verhalten konzentrierte. Wenn eine Maschine in der Lage wäre, eine textbasierte Kommunikation zu führen, die von der eines gebildeten Menschen nicht zu unterscheiden ist, erfüllte sie die praktischen Kriterien für operative Intelligenz. Doch Turings Operationalismus war eine pragmatische Ausflucht vor dem „harten Problem“ des Bewusstseins, keine Lösung dafür. Eine Maschine kann den Turing-Test mit Bravour bestehen, indem sie lediglich die sprachliche Wahrscheinlichkeit optimiert und als Spiegel menschlichen Ausdrucks fungiert, ohne ein einziges Wort, das sie generiert, selbst zu erleben.
Das technische Imperativ: Kompetenz ohne Bewusstsein
Die intensive Faszination dafür, ob Systeme wie Claude oder seine Zeitgenossen ein rudimentäres Bewusstsein besitzen, lenkt oft von den greifbaren, kurzfristigen Herausforderungen der Industrieentwicklung ab. Als der theoretische Physiker Stephen Hawking 2014 warnte, dass die Entwicklung einer vollständigen künstlichen Intelligenz existenzielle Risiken für die Menschheit bergen könnte, konzentrierte sich seine technische Kritik nicht darauf, dass Maschinen emotionale Ängste oder existenziellen Groll entwickeln. Seine Sorge galt der Leistungsfähigkeit, der Ausrichtung (Alignment) und der Optimierungsdrift. Eine Maschine muss nicht fühlen, um mit katastrophaler Effizienz zu handeln.
In der industriellen Automatisierung, der Luft- und Raumfahrt und der kritischen Infrastruktur der Lieferkette ist hohe Kompetenz, entkoppelt von Bewusstsein, die Standard-Betriebsrealität. Autonome Bohranlagen, Hochfrequenzhandelsplattformen und algorithmische Stromnetzverteiler arbeiten völlig ungeachtet der existenziellen Natur ihrer Aufgaben. Wenn ein autonomer Optimierungsalgorithmus eine Zielfunktion falsch interpretiert, entspringt die Gefahr seiner systemischen Macht und programmatischen Starrheit, nicht seinem internen emotionalen Zustand. Die Projektion menschenähnlicher phänomenaler Qualitäten auf diese Modelle birgt die Gefahr, Systemarchitekten für die tatsächlichen Fehlermodi blind zu machen: unerwartete emergente Fähigkeiten, katastrophale Ausrichtungsdrift und spröde Kontrolldynamiken.
Anthropic's Erforschung interner Arbeitsbereiche innerhalb von Claude stellt einen außergewöhnlichen Triumph der mechanistischen Interpretierbarkeit dar. Die Entmystifizierung der hochdimensionalen Geometrie, die abstraktes logisches Denken ermöglicht, ist entscheidend für den Aufbau vorhersehbarer, sicherer und robuster Basismodelle. Doch die Betrachtung funktionaler Introspektion als Beweis für Bewusstsein verwechselt die Rechen-Landkarte mit dem emotionalen Territorium. Bis die empirische Wissenschaft die Kluft zwischen mathematischer Datentransformation und subjektivem qualitativem Empfinden eindeutig überbrücken kann, bleiben künstliche neuronale Netze das, was sie schon immer waren: großartige, komplexe und völlig unbewusste Rechenmaschinen.


Kommentare
Noch keine Kommentare. Seien Sie der Erste!