El desarrollo de la inteligencia artificial de frontera ha alcanzado un umbral en el que el rendimiento del silicio y el diseño algorítmico ya no son los únicos determinantes de la fecha de lanzamiento de un modelo. El despliegue de la serie GPT-5.6 de OpenAI marca un punto de inflexión en la forma en que los modelos fundacionales de vanguardia transitan desde los clústeres de entrenamiento hacia la realidad comercial. En lugar de lanzarse inmediatamente después de los puntos de control de aprendizaje por refuerzo, la nueva familia de modelos se sometió a un período de evaluación formal y extendido, realizado en coordinación con el Instituto de Seguridad de Inteligencia Artificial de los Estados Unidos y los organismos federales pertinentes. Esta auditoría formal señala un cambio permanente hacia la certificación institucional previa al despliegue para los sistemas cognitivos de frontera.
Para los ingenieros empresariales y arquitectos de sistemas industriales, la llegada de GPT-5.6 representa mucho más que un incremento gradual en las tablas de puntuación de referencia. El lanzamiento demuestra una recalibración deliberada de la asignación de cómputo, yendo más allá de la fluidez conversacional básica hacia el razonamiento determinista, la ejecución operativa a largo plazo y la interacción de baja latencia con la infraestructura física. OpenAI ha organizado la arquitectura en niveles distintos diseñados para manejar tanto el razonamiento empresarial pesado como la orquestación industrial próxima al borde, estableciendo una base sobre cómo los sistemas multiagente interactúan con flujos de trabajo físicos complejos.
La anatomía de la autorización federal
El retraso operativo que precedió al lanzamiento público de GPT-5.6 pone de relieve el alcance cada vez mayor de la gobernanza estatutaria y voluntaria sobre la computación de frontera. Los evaluadores del Instituto de Seguridad de Inteligencia Artificial de EE. UU., operando bajo marcos establecidos por el Instituto Nacional de Estándares y Tecnología, sometieron los pesos del modelo a extensos protocolos de pruebas de seguridad (red-teaming). A diferencia de las evaluaciones de seguridad anteriores que examinaban principalmente las salidas tóxicas o el sesgo conversacional, el escrutinio aplicado a la arquitectura 5.6 priorizó los riesgos de seguridad nacional de doble uso, las capacidades de explotación automatizada y las tendencias de replicación autónoma.
Las revisiones técnicas se centraron en gran medida en la capacidad del modelo para interactuar de forma autónoma con sistemas de control industrial en red y cadenas de suministro de software. Los evaluadores auditaron la capacidad del modelo para sintetizar ciberataques de día cero, analizar configuraciones de sistemas SCADA aislados (air-gapped) y ejecutar inyecciones de lógica compleja en controladores programables. El lanzamiento fue autorizado solo después de que OpenAI demostrara salvaguardas mecanísticas verificables, incluidos disyuntores en tiempo de ejecución que monitorean los rastros de razonamiento intermedio cuando el modelo procesa código máquina de bajo nivel, telemetría de red o estructuras de datos bioquímicos.
Este ciclo de cumplimiento establece un precedente operativo para los laboratorios de inteligencia artificial de primer nivel. El protocolo de autorización demuestra que los futuros saltos en el rendimiento de los modelos fundacionales se regirán por canales de validación estandarizados, análogos a las certificaciones de aeronavegabilidad aeroespacial o los ensayos de eficacia farmacéutica. Para los operadores industriales que observan los sistemas autónomos, esta capa de autorización regulatoria proporciona un grado de garantía institucional que hasta ahora estaba ausente en los despliegues comerciales.
Refinamientos arquitectónicos en el núcleo 5.6
Debajo del marco de gobernanza se encuentra una arquitectura sustancialmente rediseñada. La generación GPT-5.6 se aparta de las filosofías de escalado monolítico, inclinándose agresivamente hacia el enrutamiento dinámico y disperso de "Mezcla de Expertos" (Mixture-of-Experts), junto con el escalado de cómputo integrado durante el tiempo de prueba. Si bien OpenAI mantiene su habitual reserva propietaria respecto a los recuentos exactos de parámetros, los datos de telemetría y el rendimiento del sistema indican que el modelo central activa solo una fracción de su base total de parámetros por pase hacia adelante, lo que reduce drásticamente las limitaciones de ancho de banda de memoria durante la inferencia.
La longitud del contexto se ha ampliado junto con mejoras en la fidelidad de recuperación. El modelo mantiene un seguimiento del estado coherente a lo largo de cientos de miles de tokens, resolviendo problemas persistentes relacionados con la degradación del estado intermedio en registros operativos complejos. En evaluaciones prácticas, GPT-5.6 demuestra un perfil de retención casi lineal a lo largo de ventanas operativas extendidas, lo que garantiza que las fuentes de sensores temporales, la extensa documentación de API y los datos históricos de telemetría puedan evaluarse simultáneamente sin olvido catastrófico.
Traduciendo el razonamiento digital a la industria física
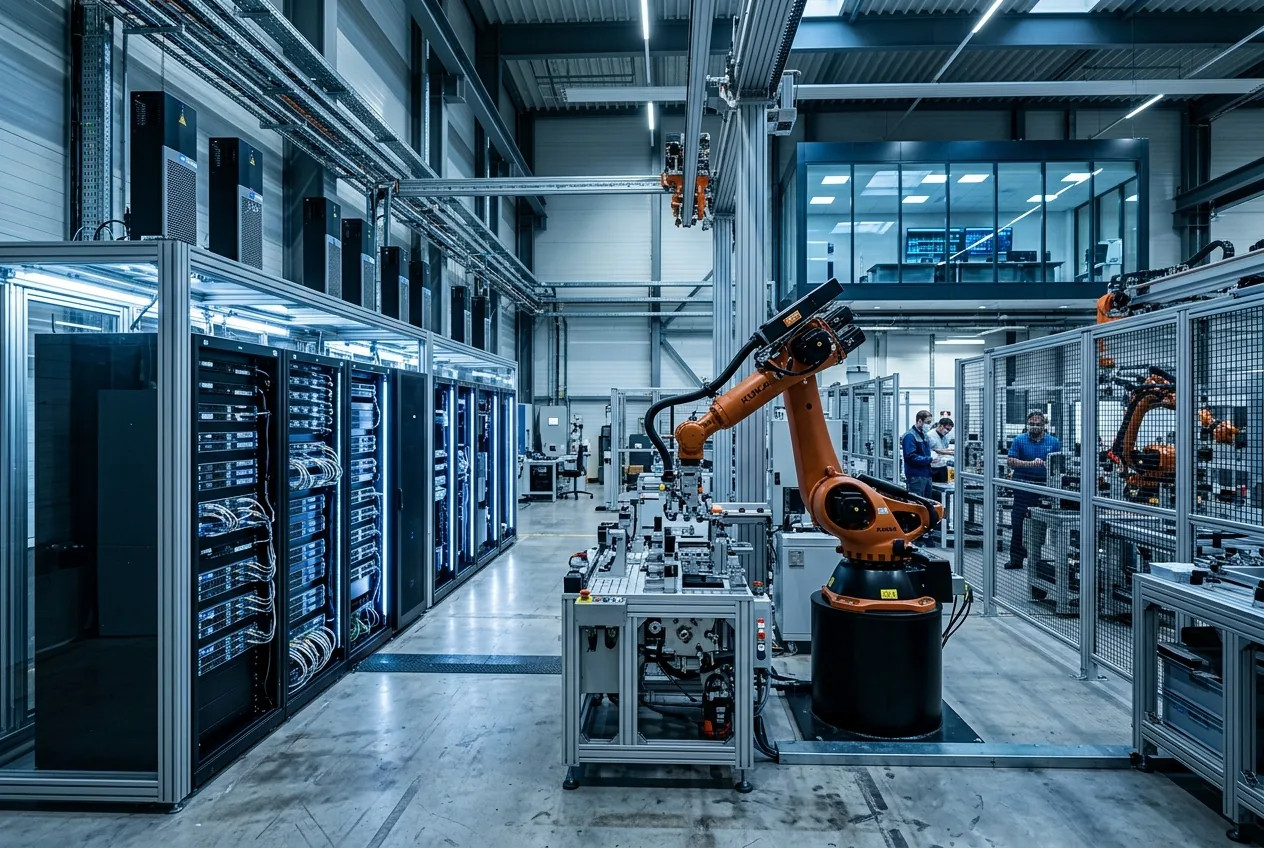
La verdadera prueba de GPT-5.6 no reside en los puntos de referencia lingüísticos genéricos; vive en su aplicabilidad a sistemas mecánicos, controladores lógicos programables y operaciones físicas automatizadas. Las generaciones anteriores de modelos de lenguaje grandes funcionaban principalmente como interfaces de asesoramiento, ofreciendo sugerencias que los operadores humanos traducían en ejecución mecánica. GPT-5.6 salva esta brecha al proporcionar perfiles de salida deterministas y altamente estructurados, diseñados para la integración con middlewares de robótica como ROS 2 y protocolos industriales heredados como Modbus y OPC UA.
Esta capacidad reduce drásticamente los gastos generales tradicionalmente asociados con el reequipamiento industrial. En entornos de fabricación ágil donde las líneas de producción deben adaptarse a tiradas de componentes de bajo volumen y alta mezcla, la programación de manipuladores industriales convencionales ha requerido históricamente decenas de horas de ingeniería. GPT-5.6 puede ingerir geometrías CAD tridimensionales, realizar referencias cruzadas de especificaciones de ensamblaje y generar primitivas de movimiento de robot robustas y validadas en minutos, alterando fundamentalmente la economía de la fabricación flexible.
Economía de cómputo y costos operativos
Si bien las capacidades arquitectónicas son formidables, el cálculo empresarial en torno a GPT-5.6 depende de la economía unitaria y el gasto en inferencia. Los modelos de frontera imponen con frecuencia gastos operativos prohibitivos cuando se integran en tuberías de datos de alta frecuencia. OpenAI ha abordado esta fricción introduciendo una jerarquía agresiva de cuantización y destilación por niveles, lo que permite a los clientes empresariales desplegar derivados destilados más pequeños directamente en las instalaciones o en el borde industrial.
La variante insignia de GPT-5.6 permanece en la nube, consumiendo un ancho de banda de clúster masivo a través de arreglos de aceleradores refrigerados por líquido. Sin embargo, sus contrapartes optimizadas para el borde demuestran una fidelidad notable, ejecutándose en un hardware de inferencia industrial modesto ubicado directamente dentro de los perímetros de la fábrica. Esta capacidad de nivel de borde mitiga las vulnerabilidades duales de la latencia WAN y la exfiltración de datos propietarios, permitiendo que las instalaciones de fabricación procesen flujos de visión y datos de salud de maquinaria localmente mientras reservan consultas de razonamiento profundo para instancias de nube centralizadas.
Además, la optimización de la decodificación especulativa y la compresión de caché de clave-valor por parte de OpenAI ha reducido el costo por millón de tokens para el procesamiento por lotes de alto volumen. En contextos de mantenimiento predictivo, donde miles de perfiles de vibración de máquinas y lecturas de sensores térmicos deben procesarse continuamente, el costo operativo del monitoreo continuo ha disminuido lo suficiente como para justificar una supervisión autónoma continua sobre activos de capital de alto valor.
El paradigma emergente de la inteligencia artificial certificada
El despliegue de la serie GPT-5.6 representa el cierre de una era experimental y la maduración de la inteligencia artificial hacia una infraestructura crítica. La convergencia de la supervisión federal, la especialización arquitectónica y la compatibilidad industrial indica que el sector está dejando atrás la experimentación de consumo sin restricciones en favor de la durabilidad de grado empresarial. Los sistemas de IA están evolucionando hacia componentes estructurales de la productividad nacional, sujetos a las mismas tolerancias de seguridad rigurosas que las redes eléctricas y las redes de tránsito civil.



Comments
No comments yet. Be the first!