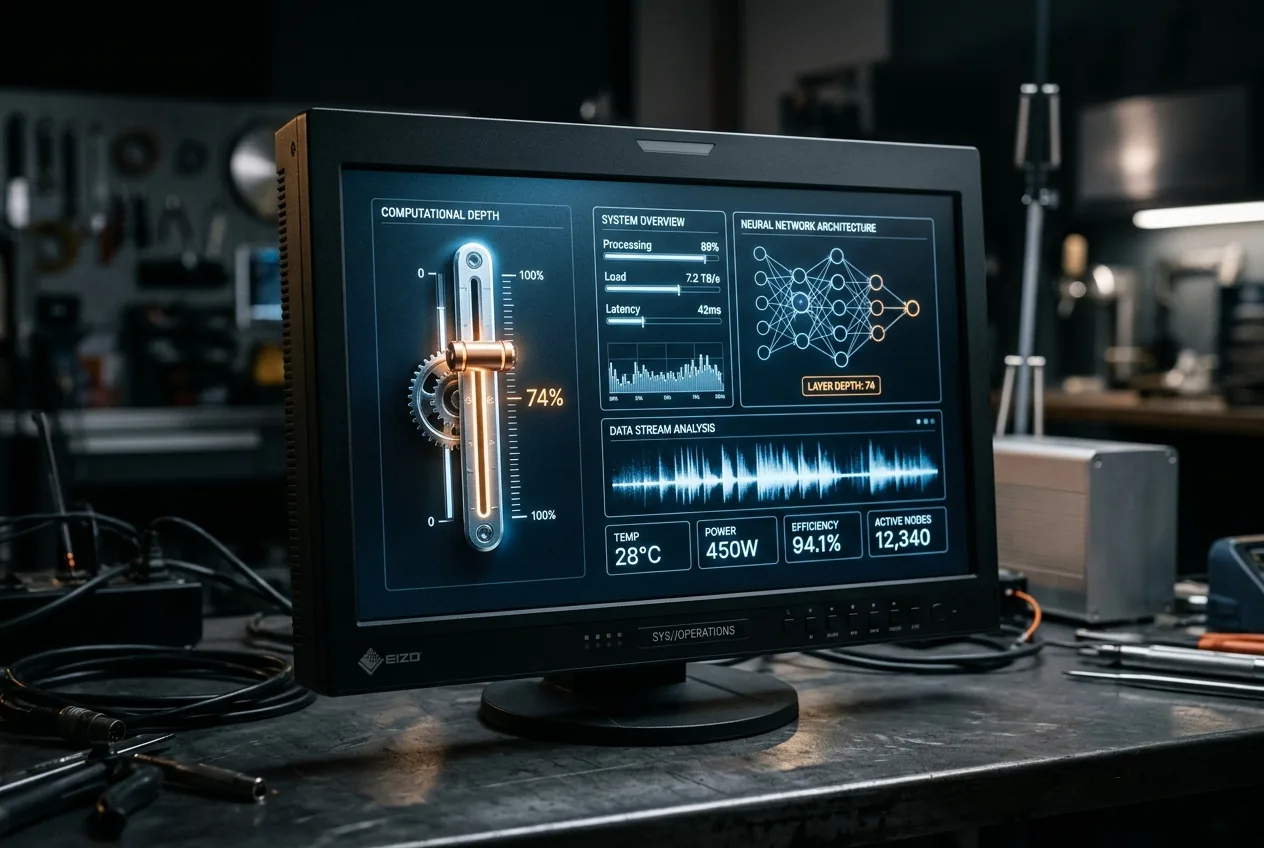
Une transformation silencieuse est en cours au sein de l'infrastructure qui alimente l'interaction numérique mondiale. OpenAI a lancé une refonte majeure de l'architecture des versions grand public et professionnelles de ChatGPT, réalignant fondamentalement la manière dont la puissance de calcul est distribuée parmi ses quelque un milliard d'utilisateurs actifs hebdomadaires. Les utilisateurs gratuits ont été migrés vers un nouveau modèle optimisé baptisé GPT-5.6 Luna, offrant des conversations textuelles illimitées sans bridage artificiel. Parallèlement, les abonnements payants Plus et Pro bénéficient de GPT-5.6 Sol, associé à une interface de type physique qui permet aux opérateurs de gérer directement la puissance de calcul allouée au raisonnement du modèle en temps réel.
Ce déploiement représente un pivot stratégique majeur : on passe d'un changement de modèle rigide et discret à une mise à l'échelle de l'inférence continue et axée sur la demande. Pendant des années, l'IA conversationnelle destinée au grand public imposait aux utilisateurs un choix binaire préalable : diriger une requête vers un modèle léger à faible latence conçu pour des questions simples, ou l'envoyer vers un moteur de raisonnement coûteux et multi-étapes capable de déductions complexes. Avec le déploiement de la famille GPT-5.6, OpenAI remplace cette approche fragmentée par des poids de paramètres unifiés et des allocations de calcul variables, modifiant fondamentalement l'économie de l'intelligence artificielle grand public.
L'architecture derrière l'accès gratuit illimité
Fournir un chat textuel illimité et sans entrave à une base d'utilisateurs se comptant par centaines de millions est avant tout un défi de matériel et d'efficacité, plutôt qu'une nouveauté mathématique. Les dépenses opérationnelles associées à la génération continue de jetons (tokens) à l'échelle mondiale ont historiquement imposé des limites de débit artificielles, des temps de refroidissement ou des déclassements obligatoires de modèles pendant les pics de charge des centres de données. Pour éliminer ces obstacles pour les utilisateurs gratuits, OpenAI a développé GPT-5.6 Luna, un moteur d'inférence ultra-efficace et hautement distillé, conçu explicitement pour maximiser le débit par watt.
Luna s'écarte de l'expansion brute des paramètres pour s'appuyer sur l'élagage architectural dense, des pipelines de décodage spéculatif spécialisés et une mise en cache clé-valeur fortement optimisée sur l'ensemble du cluster d'hébergement. Bien que Luna supprime totalement les limites des conversations textuelles, le système global maintient des garde-fous sur les charges de travail multimodales gourmandes en bande passante. L'ingestion de fichiers, l'analyse de données structurées et les routines de génération d'images restent soumises à des plafonds de consommation stricts. Pour le texte, cependant, Luna fonctionne comme une couche utilitaire persistante à faible latence.
Pour éviter que Luna ne trébuche face à des requêtes ambiguës ou fortement imbriquées, l'interface introduit un commutateur de traitement dédié. Comme Luna n'est pas un modèle de fondation massif fonctionnant par force brute, ce mécanisme permet à l'utilisateur de commander explicitement au réseau d'exécuter des étapes de vérification secondaires. Lors de tests internes effectués dans des domaines fortement réglementés tels que la finance, la santé et le droit administratif, GPT-5.6 Luna a démontré une réduction de 62 % des taux d'erreur factuelle par rapport à la base de référence GPT-5.5 Instant, illustrant à quel point une stabilité structurelle peut être intégrée dans une empreinte d'exécution réduite.
La mécanique de l'inférence en temps réel et le curseur de réflexion
Alors que la version gratuite bénéficie d'une distillation poussée, la version par abonnement payant introduit un mécanisme plus granulaire pour les opérateurs techniques : le curseur de raisonnement dynamique. Emprunté à l'environnement d'ingénierie spécialisé Codex, ce contrôle d'interface accorde aux utilisateurs Plus et Pro une gouvernance directe sur la profondeur de recherche interne de GPT-5.6 Sol. Plutôt que d'interagir avec le modèle comme une boîte noire statique produisant un flux de jetons immuable, les utilisateurs peuvent adapter mécaniquement le budget de calcul alloué à la réflexion avant même de générer le moindre caractère visible.
Dans les modèles de texte auto-régressifs standard, le coût d'inférence est essentiellement fixe par jeton de sortie. Le réseau prédit le jeton suivant dans la séquence en se basant uniquement sur la fenêtre de contexte précédente, laissant peu d'espace pour évaluer des chemins alternatifs ou corriger des hypothèses erronées en cours de route. À l'inverse, les architectures de raisonnement s'appuient sur le calcul en temps réel, générant en coulisses des graphes de recherche cachés, des boucles d'auto-critique et des chemins de vérification basés sur la chaîne de pensée. Le nouveau curseur traduit l'intention de haut niveau de l'utilisateur en budgets de jetons de bas niveau, modifiant dynamiquement le facteur de branchement de l'arbre de recherche.
- Position basse (Réponse directe) : Le modèle supprime les jetons de recherche cachés, privilégiant des réponses rapides pour les recherches de syntaxe programmatique, les traductions rapides et les récupérations factuelles basiques.
- Position équilibrée (Planification contextuelle) : Le modèle initie des contrôles de cohérence modérés, filtrant le bruit conversationnel, identifiant les objectifs implicites de l'utilisateur et structurant des plans complexes sans latence cognitive inutile.
- Position haute (Inférence profonde) : Le système alloue un budget de raisonnement étendu, explorant des pistes analytiques concurrentes, menant des analyses contrefactuelles en plusieurs passes et testant rigoureusement la logique technique ou juridique complexe avant de fournir une sortie synthétisée.
Cet ajustement dynamique résout une frustration persistante chez les utilisateurs techniques : la surcharge cognitive. Auparavant, les modèles de raisonnement avancés réfléchissaient souvent trop aux requêtes transactionnelles simples, enveloppant des réponses directes dans des préambules alambiqués et des justifications imbriquées. Avec la nouvelle implémentation de GPT-5.6 Sol, une demande concernant les variables atmosphériques locales pour faire du vélo ne génère plus un déversement indiscriminé de mesures de pression barométrique et de précipitations. Le modèle évalue l'objectif fonctionnel, isole le cisaillement du vent et la vitesse convective comme principales contraintes de performance, et supprime les variables non pertinentes pour fournir une évaluation exploitable et spécifique à la mission.
Lutter contre le déficit d'hallucination en production
Au-delà des améliorations ergonomiques, la principale mesure de performance régissant la génération 5.6 est la fiabilité factuelle empirique. Dans les applications d'entreprise à forts enjeux, l'appel d'outils robotiques et les pipelines opérationnels automatisés, la génération de langage statistique a historiquement été entravée par des hallucinations subtiles — des affirmations plausibles sans fondement factuel. Les audits internes d'OpenAI indiquent que GPT-5.6 Sol réduit ces incidents d'environ 68 % par rapport à GPT-5.5 Instant sur des jeux d'évaluation rigoureux multi-domaines.
Cette réduction n'est pas simplement le produit d'un corpus d'entraînement plus vaste. Le bond en avant des performances découle de l'apprentissage par renforcement affiné à partir des retours des vérificateurs, où des modèles d'évaluation auxiliaires notent les étapes de raisonnement intermédiaires en se basant sur des preuves algorithmiques véridiques plutôt que sur des préférences humaines subjectives. En sanctionnant les étapes de déduction incorrectes tôt dans la phase de génération de jetons cachés, Sol élague les chemins logiques corrompus avant qu'ils ne se propagent dans le texte de réponse final. Le modèle affiche également une propension accrue à la réfutation active ; plutôt que d'accepter passivement les prémisses erronées posées par l'opérateur, Sol est entraîné à émettre des corrections techniques lorsque les paramètres de base entrent en conflit avec les réalités physiques ou mathématiques empiriques.
Il est important de souligner que cette implémentation de GPT-5.6 Sol est actuellement limitée à l'interface conversationnelle native de ChatGPT. Les plateformes de travail en entreprise et les points de terminaison programmatiques dédiés gérant Codex conservent leurs configurations de pipeline sur mesure afin d'éviter des changements structurels perturbateurs dans les environnements d'automatisation industrielle et de génération de code existants. Maintenir cette séparation garantit que les clients API critiques restent isolés des réglages destinés au front-end grand public.
Volants de croissance grand public et realpolitik de la distribution du calcul
La logique stratégique derrière la fourniture d'un accès gratuit et illimité à Luna tout en affinant l'économie de l'inférence de Sol souligne la réalité concurrentielle évolutive de l'intelligence artificielle. Alors que l'intérêt des développeurs de pointe s'est fortement tourné vers le développement logiciel automatisé et la génération de code, les plateformes de dialogue grand public restent le volant de données ultime. En offrant des interactions textuelles illimitées et très précises à un milliard d'utilisateurs, OpenAI capture un flux sans précédent d'intentions humaines en temps réel, de retours correctifs et de cas limites opérationnels.
De plus, l'exécution de Luna à grande échelle fournit des tests de résistance cruciaux pour le silicium de nouvelle génération et l'infrastructure de refroidissement au sein des centres de données d'IA modernes. Amortir ces énormes dépenses en capital nécessite des opérations de charge de base continues et à haute efficacité. La distillation de paramètres performants dans Luna permet au fournisseur de maintenir une saturation optimale des clusters pendant les heures creuses, transformant l'engagement des consommateurs en un actif de télémétrie opérationnelle.
Pour l'écosystème technologique au sens large, ce déploiement à deux niveaux marque une phase de maturation de l'informatique générative. L'ère des chatbots indifférenciés rivalisant uniquement sur l'échelle brute des paramètres touche à sa fin. À sa place émerge une ère définie par l'ingénierie système : une distillation rigoureuse pour les services publics à haut débit et une profondeur d'inférence finement réglée et contrôlée par l'opérateur pour la résolution de problèmes critiques.




Comments
No comments yet. Be the first!