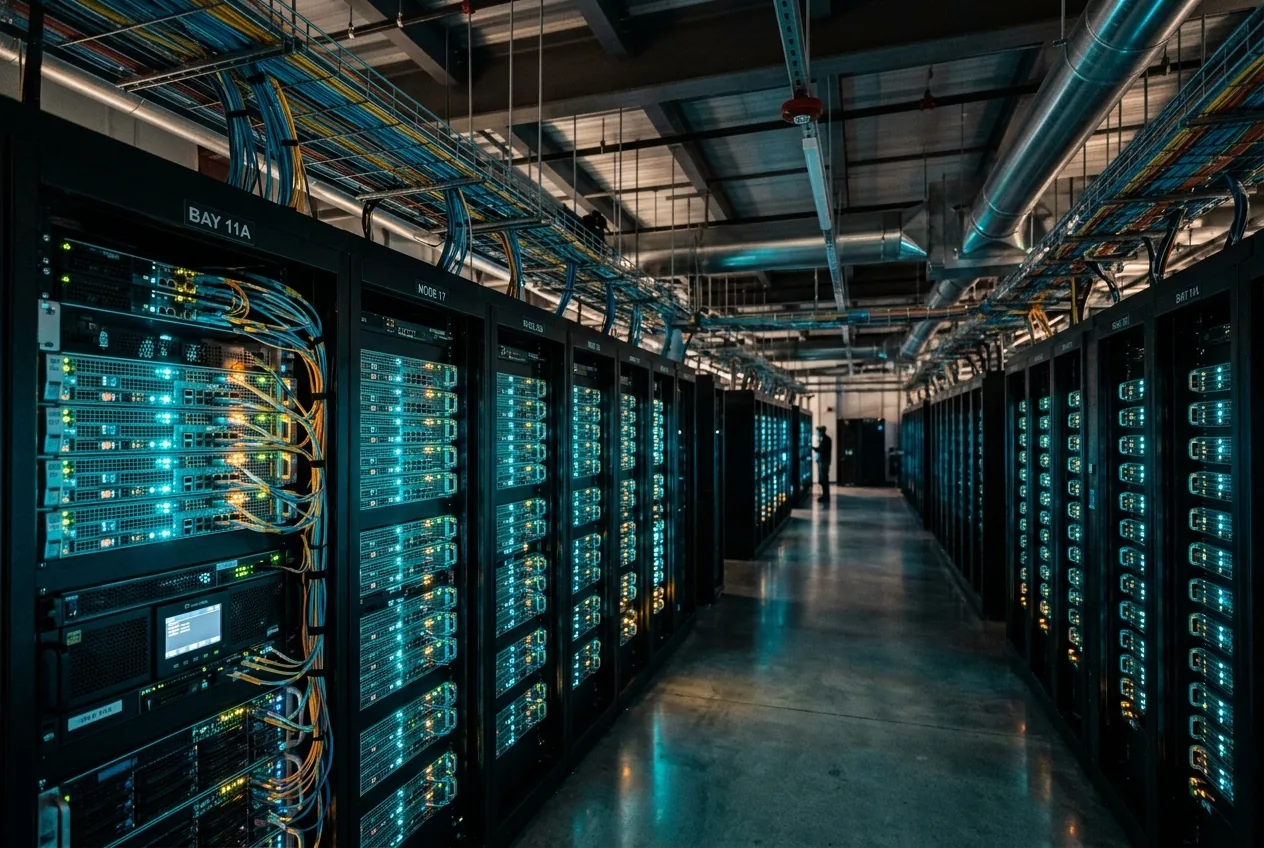
Nel palcoscenico ad alta posta in gioco dell'intelligenza artificiale di frontiera, il costo di generazione di un singolo token ha dettato a lungo i confini dell'accesso pubblico. Negli ultimi due anni, gli hyperscaler e i laboratori di frontiera hanno camminato sul filo del rasoio tra l'acquisizione di utenti e le pesanti spese in conto capitale necessarie per far girare decine di migliaia di GPU energivore. Quell'equazione è cambiata radicalmente. Il rilascio di GPT-5.6 Luna — un'iterazione snella e ultra-efficiente all'interno dell'albero genealogico di GPT-5 — agli utenti gratuiti di ChatGPT senza limitazioni di velocità standard segna un punto di svolta fondamentale nella fisica dell'economia dei data center.
Mentre i titoli di consumo si concentrano sulla democratizzazione delle interfacce conversazionali, la vera narrazione si trova sotto i rack dei server. Fornire inferenza illimitata e a bassa latenza a centinaia di milioni di utenti non monetizzati non è un atto di carità tecnologica; è un traguardo ingegneristico reso possibile da un'aggressiva distillazione del modello, dal routing mixture-of-experts (MoE) e da ottimizzazioni dell'esecuzione a livello hardware. Allo stesso tempo, OpenAI sta deliberatamente biforcando la sua piattaforma, riservando budget di calcolo a forza bruta, ragionamento prolungato durante il tempo di test e autonomia agentica agli abbonati paganti.
L'ingegneria dietro il token a margine zero
Per comprendere come un modello che porta il moniker generazionale GPT-5.6 possa essere distribuito senza rigidi limiti di velocità, è necessario esaminare il costo operativo dell'inferenza. Storicamente, gestire un modello transformer denso all'avanguardia richiedeva il clustering di sistemi di memoria a larghezza di banda elevata (HBM) che consumavano centinaia di watt per query. Se un fornitore avesse aperto i cancelli senza misurazione, le spese operative del data center sarebbero aumentate in modo incontrollabile.
GPT-5.6 Luna aggira questi colli di bottiglia finanziari attraverso l'attivazione dei parametri iper-ottimizzata. Invece di eseguire una matrice di parametri densa per ogni query, Luna sfrutta un'architettura Mixture of Experts avanzata che attiva solo una modesta frazione del numero totale di parametri per ogni passaggio in avanti. Quando abbinato alla quantizzazione a 4 e 8 bit in virgola mobile (FP4/FP8) eseguita nativamente sui moderni tensor core, i requisiti di larghezza di banda della memoria scendono di un ordine di grandezza. Ciò consente a OpenAI di inserire un numero significativamente maggiore di flussi di inferenza simultanei in un singolo nodo HGX senza incorrere in stalli legati alla memoria.
Profilo architettonico della variante Luna
La designazione Luna indica un profilo di distillazione specializzato ottimizzato per un throughput elevato, un'eccezionale capacità di seguire le istruzioni e un overhead di memoria minimo. Nei test di benchmark, i sistemi di frontiera ad alto numero di parametri soffrono spesso di una latenza significativa durante i calcoli iniziali del tempo al primo token (TTFT) a causa dei lunghi meccanismi di attenzione che elaborano ampie finestre di contesto. Luna contrasta questo fenomeno attraverso il pruning architettonico, utilizzando l'attenzione a query raggruppate (GQA) e meccanismi ottimizzati di conservazione dello stato che eliminano i pesi della cache storica estranei.
Il risultato è un modello che dimostra un'eccezionale coerenza conversazionale e utilità quotidiana — gestendo il refactoring del codice, la sintesi di documenti e le query generali — pur bypassando intenzionalmente i cicli di ragionamento a percorso multiplo computazionalmente rovinosi presenti nei modelli di ragionamento specializzati di OpenAI. Luna non esegue esaustive ricerche ad albero Monte Carlo o ramificazioni di complessi scratchpad interni prima di generare una risposta. Si affida invece a un'intuizione parametrica raffinata, dando priorità all'esecuzione immediata rispetto alla verifica profonda in più fasi.
Questo rende Luna il cavallo di battaglia ideale per il throughput di livello consumer. Evita i catastrofici colli di bottiglia computazionali che si verificano quando centinaia di migliaia di utenti richiedono simultaneamente un'elaborazione della catena di pensiero di diversi minuti. Limitando la profondità computazionale pur mantenendo un'elevata capacità superficiale, OpenAI mantiene uno stretto controllo sui suoi inviluppi termici del data center senza diminuire la qualità del servizio percepita per gli utenti generalisti.
Il fossato computazionale: perché i livelli a pagamento si stanno spostando verso il calcolo in fase di test
Con un'intelligenza ad alta velocità e per scopi generali effettivamente mercificata e consegnata al livello pubblico, la proposta di valore per i livelli ChatGPT Plus e Pro ha subito una necessaria migrazione architettonica. Gli abbonati paganti non stanno più acquistando semplicemente finestre di contesto più ampie o l'accesso prioritario alla coda per la generazione di testo conversazionale; stanno acquistando calcolo grezzo in fase di test.
Mentre Luna gestisce l'estremità dello spettro ad alto volume e bassa complessità, i livelli premium di OpenAI mantengono il dominio esclusivo sui sistemi che allocano dinamicamente il pensiero durante il tempo di inferenza. Queste configurazioni avanzate scalano i loro alberi di ricerca interni in base alla difficoltà del prompt, bruciando cicli significativi di GPU per verificare la logica intermedia, eseguire subroutine di autocorrezzione e interrogare sandbox simulate prima di fornire un payload finale. Per la modellazione matematica complessa, l'analisi del codice zero-day e le attività di automazione industriale, questa deliberazione ad alta intensità di calcolo è indispensabile.
Inoltre, i livelli Plus e Pro si stanno spostando verso livelli di esecuzione agentica che richiedono una gestione dello stato persistente, streaming multimodale a bassa latenza e orchestrazione asincrona degli strumenti. Gestire un agente autonomo che si interfaccia con API esterne, legge la telemetria in tempo reale e rifattorizza basi di codice locali richiede riserve di calcolo sostenute che non possono essere sovvenzionate attraverso ecosistemi supportati da annunci o livelli gratuiti. OpenAI sta tracciando una linea netta tra l'intelligenza come utility — veloce, onnipresente e leggera — e l'intelligenza come motore ingegneristico, che richiede un'infrastruttura dedicata ad alto capitale.
Automazione industriale e realtà edge
Dal punto di vista dell'ingegneria applicata e della robotica, gli sviluppi tecnici alla base di Luna hanno ramificazioni che vanno ben oltre la finestra del browser. I principi architettonici che rendono un modello basato sul web abbastanza economico da funzionare a scala infinita sono esattamente i principi necessari per distribuire l'intelligenza artificiale in ambienti industriali edge.
Nelle moderne fabbriche e negli hub logistici automatizzati, distribuire modelli giganti dipendenti dal cloud è fondamentalmente non praticabile a causa dei vincoli di larghezza di banda, dei requisiti di latenza deterministica e degli inviluppi di sicurezza fisica. Le tecniche di compressione del modello, la quantizzazione aggressiva e il routing sparso mostrati nella build Luna dimostrano come l'intelligenza di alto livello possa essere eventualmente compressa in apparecchiature di calcolo edge, come architetture SoC (System-on-Chip) integrate che operano all'interno di controller di bracci robotici o veicoli a guida automatica (AGV).
Quando la generazione di token diventa così efficiente, la barriera all'integrazione della comprensione del linguaggio naturale in tempo reale e del ragionamento spaziale visivo nei sistemi di controllo di supervisione e acquisizione dati (SCADA) industriali crolla. Gli operatori non richiedono più connessioni cloud dirette round-trip per regolazioni operative di base. La distribuzione di Luna dimostra che il divario tra la scala dei parametri di laboratorio e l'efficienza robusta e pronta per l'edge si sta chiudendo più velocemente di quanto il settore manifatturiero avesse previsto.
La pressione competitiva sulle alternative a pesi aperti
La decisione di OpenAI di aprire l'accesso senza limitazioni a un modello di classe GPT-5 è anche una controffensiva calcolata contro l'ascesa aggressiva delle architetture a pesi aperti. Nell'ultimo anno, modelli di fornitori come Meta, Mistral e DeepSeek hanno eroso il vantaggio proprietario delle API commerciali offrendo un'inferenza locale a basso costo che le aziende e gli sviluppatori possono ospitare in modo indipendente.
Questa dinamica costringe il più ampio settore dell'intelligenza artificiale a un'era di spietata specializzazione. I fornitori non possono più richiedere un sovrapprezzo per una competenza conversazionale di base. Per generare entrate, gli sviluppatori di IA commerciale devono dimostrare che le loro architetture proprietarie offrono una supremazia di ragionamento tangibile e misurabile che migliori direttamente i rendimenti operativi, automatizzi complessi flussi di lavoro aziendali o esegua attività di ingegneria di precisione che modelli distillati come Luna non possono toccare. Man mano che la base di calcolo gratuito si sposta verso l'alto, il settore deve ricalibrare ciò che costituisce un vero valore proprietario.




Comments
No comments yet. Be the first!