OpenAI sta avviando la transizione della sua avanzata famiglia di modelli GPT-5.6 verso un'ampia disponibilità commerciale, concludendo un periodo durato mesi di throughput limitato e accesso agli endpoint ristretto, originariamente istituito in base ad accordi volontari con gli organismi di supervisione federale. La decisione segna un fondamentale punto di svolta operativo per il laboratorio di intelligenza artificiale, che sposta il calcolo di frontiera da ambienti sandbox strettamente monitorati ad architetture aziendali aperte. Sebbene i primi livelli di accesso fossero vincolati da specifiche soglie di calcolo e filtri di ispezione dei prompt per valutare i rischi di duplice uso per la sicurezza nazionale, l'azienda ha finalizzato i protocolli di verifica necessari per rilasciare il pieno supporto API e della piattaforma.
La mossa arriva in un momento in cui gli operatori industriali, i fornitori di software aziendale e gli sviluppatori di hardware richiedono l'accesso a modelli di ragionamento più profondi, in grado di gestire complesse routine di utilizzo degli strumenti e flussi di lavoro di agenti autonomi. Finora, l'accesso a GPT-5.6 era stato regolato da rigidi limiti di frequenza, geofencing regionale e controlli manuali per funzionalità avanzate come lo sfruttamento automatizzato delle vulnerabilità del codice e la logica di sintesi biologica. Sciogliendo questi vincoli artificiali, OpenAI sta testando se le sue mitigazioni di sicurezza architettoniche possano sopravvivere allo stress imprevedibile di una distribuzione su larga scala nel mondo reale.
L'architettura dietro l'Extended Inference Pipeline
Dal punto di vista ingegneristico, la denominazione GPT-5.6 rappresenta una significativa evoluzione architettonica piuttosto che un semplice aumento dei parametri. La famiglia di modelli si basa su una topologia Mixture-of-Experts (MoE) ottimizzata abbinata a un sistema dinamico di routing del calcolo durante il test-time. Invece di dedicare percorsi di parametri statici a ogni query in arrivo, il motore valuta la complessità dei token nella fase di parsing del prompt, allocando cicli di calcolo ausiliari a percorsi di ragionamento strutturati e intermedi prima di restituire un payload finalizzato.
I compromessi tecnici, tuttavia, rimangono non trascurabili. Mentre la latenza di generazione dei token sui compiti conversazionali standard rimane entro limiti interattivi accettabili, i compiti di tracciamento profondo — in cui il modello verifica autonomamente vincoli matematici o analizza protocolli industriali stratificati — possono richiedere picchi di calcolo prolungati della durata di diversi secondi. Il rilascio dell'accesso API senza restrizioni esporrà questi profili di prestazioni direttamente agli ambienti di produzione, costringendo gli architetti di sistema a integrare una gestione asincrona nelle applicazioni che in precedenza si affidavano a modelli linguistici prevedibili e a singolo turno.
Dissolvere il vincolo del duplice uso: politica e verifica
Le restrizioni ora rimosse erano radicate in un controllo normativo ad alto rischio. Nel corso dell'ultimo anno, gli enti federali, tra cui lo U.S. Artificial Intelligence Safety Institute (US AISI) e le agenzie partner all'interno del Dipartimento del Commercio, hanno istituito rigorosi quadri di valutazione per i sistemi che superano le soglie di calcolo di addestramento di base. Le autorità di regolamentazione temevano che un accesso senza restrizioni a motori di ragionamento con funzionalità di sintesi avanzate potesse accelerare la progettazione di vettori biologici, abbassare la barriera agli exploit informatici zero-day automatizzati o consentire ad attori malintenzionati di sondare le reti delle infrastrutture critiche.
Il percorso di OpenAI per la revoca di questi limiti si è basato sulla dimostrazione che le barriere di sicurezza potevano essere integrate direttamente nei livelli di allineamento post-addestramento del sistema, piuttosto che essere applicate attraverso rozzi limiti di calcolo. Attraverso il red-teaming iterativo e l'apprendimento per rinforzo da supervisione specifica per il compito (RLTO), gli sviluppatori hanno isolato le rappresentazioni interne del modello relative a capacità pericolose, applicando interruttori automatici che interrompono la generazione dell'inferenza se viene rilevata una traiettoria di esecuzione non consentita. Questi confini interni finemente granulari hanno permesso al laboratorio di convincere i valutatori governativi che il modello poteva operare in contesti commerciali senza agire come un moltiplicatore di forza autonomo per atti di sabotaggio.
Tuttavia, il passaggio dalla quarantena monitorata dal governo alla disponibilità di massa cambia radicalmente il panorama delle responsabilità. I critici all'interno degli ambienti normativi sostengono che i test di sintesi in laboratorio non possano replicare completamente le vulnerabilità emergenti esposte quando milioni di utenti creano attacchi avversari specifici per il dominio. Aprendo completamente il gateway a GPT-5.6, OpenAI scommette che le sue difese algoritmiche siano abbastanza robuste da resistere alla pressione avversaria di una distribuzione globale, dichiarando di fatto che i suoi meccanismi di auto-regolamentazione sono sufficientemente maturi per il mercato aperto.
Integrazione con sistemi industriali e automazione fisica
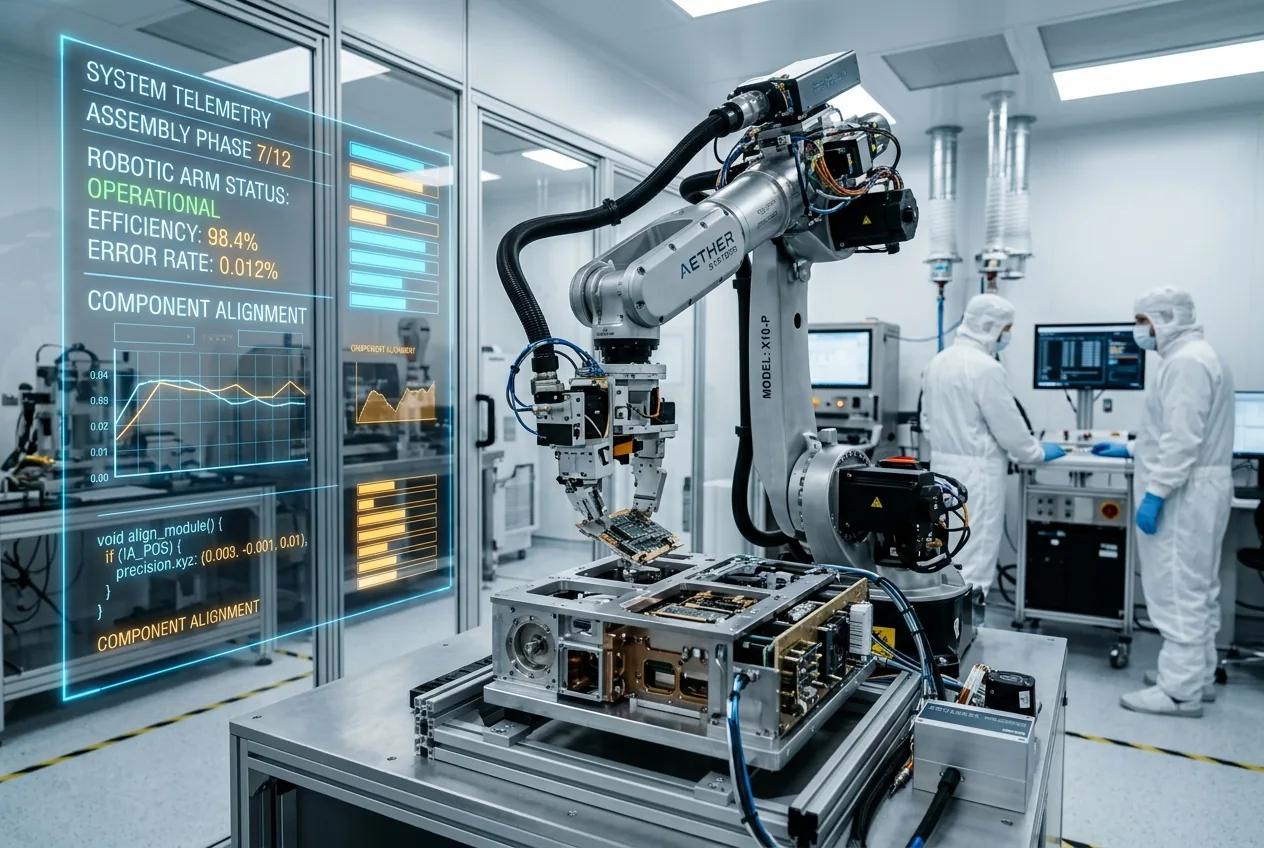
Oltre alle suite software digitali, il rilascio senza restrizioni di GPT-5.6 comporta profonde implicazioni per l'automazione fisica, le operazioni di fabbrica e l'infrastruttura della catena di approvvigionamento. La robotica industriale moderna si è storicamente scontrata con un limite nella pianificazione dei compiti di alto livello; mentre i controller robotici di basso livello eseguono traiettorie cinematiche con precisione sub-millimetrica, faticano ad adattarsi ad ambienti non strutturati o a direttive operative ambigue. GPT-5.6 è progettato per colmare questo divario fungendo da orchestratore di alto livello all'interno di pipeline ciber-fisiche unificate.
Con la rimozione dei limiti di velocità imposti dal governo, i team di ingegneria possono integrare il modello direttamente nelle piattaforme dell'Internet delle cose industriale (IIoT) in tempo reale e nei nodi del Robot Operating System (ROS2). Le capacità di ragionamento spaziale e di generazione di codice avanzato del modello gli consentono di ingerire feed visivi non strutturati e telemetria dalle linee di assemblaggio, diagnosticare anomalie meccaniche e generare programmaticamente piani di movimento eseguibili o logica ladder per PLC (Programmable Logic Controller) senza intervento umano. Questo trasforma l'intelligenza artificiale da uno strumento analitico isolato in un agente attivo e deterministico all'interno dei cicli di fornitura manifatturieri.
Si considerino, ad esempio, le configurazioni di produzione ad alta varietà e basso volume. In queste strutture, l'onere di riconfigurare e riprogrammare manualmente le celle di lavoro robotiche per ogni piccolo lotto di produzione spesso annulla i margini di profitto. Un motore di ragionamento a bassa latenza e senza limitazioni consente a una cella di lavoro robotica di analizzare un disegno tecnico ingegneristico (metadati CAD/CAM), verificare autonomamente i vincoli strutturali e compilare il proprio codice di pianificazione del percorso quasi in tempo reale. Rimuovendo i colli di bottiglia burocratici, OpenAI abilita i cicli computazionali continui necessari per officine completamente autonome.
Il bilancio del calcolo e l'economia aziendale
La decisione di commercializzare GPT-5.6 riflette anche l'economia spietata del moderno data center. Le spese in conto capitale convogliate nella costruzione di infrastrutture su scala gigawatt, nella messa in sicurezza di interconnessioni a banda larga e nell'approvvigionamento di silicio di frontiera richiedono programmi di monetizzazione aggressivi. I modelli di frontiera non possono rimanere indefinitamente confinati in prove di sicurezza prive di entrate senza incidere sui bilanci e sulla pazienza degli investitori.
Inoltre, questo rilascio pubblico esercita un'immensa pressione sulla rete elettrica globale e sulle catene di approvvigionamento di silicio specializzato. Supportare richieste API senza restrizioni per un modello di livello aziendale richiede un uptime del data center continuo e ad alta efficienza, spingendo le aziende di servizi pubblici e gli hyper-scaler verso accordi di acquisto di energia sempre più sotto pressione. Il trionfo tecnico di eseguire modelli come GPT-5.6 è inesorabilmente legato a vincoli fisici: sottostazioni di trasformazione, collettori di raffreddamento a liquido e la produzione continua degli stabilimenti di fabbricazione di microchip.
La traiettoria a lungo termine dei sistemi autonomi
La transizione di GPT-5.6 da parte di OpenAI verso la sfera commerciale segna la fine definitiva dell'era del contenimento della frontiera iniziale. L'idea che stati sovrani o consorzi volontari potessero mantenere permanentemente fossati digitali attorno a modelli di ragionamento avanzati sta svanendo a favore di una distribuzione guidata dal mercato, protetta da algoritmi di allineamento integrati. Mentre questi strumenti entrano in servizio attivo in impianti industriali, hub logistici e strutture di ricerca tecnica, inizierà il vero test della loro utilità e stabilità.
Per gli ingegneri hardware, gli sviluppatori software e gli operatori industriali, l'arrivo di modelli di frontiera senza vincoli offre capacità senza precedenti insieme a distinti obblighi operativi. Gli architetti di sistema devono ora progettare robusti wrapper di validazione attorno a questi motori probabilistici, garantendo che gli attuatori fisici, le linee di assemblaggio e i registri aziendali rimangano protetti da modalità di guasto stocastiche. Le barriere alla distribuzione sono cadute, lasciando alla comunità ingegneristica il compito di determinare con precisione quanta autonomia questo nuovo paradigma di calcolo possa esercitare in sicurezza nel mondo fisico.



Comments
No comments yet. Be the first!