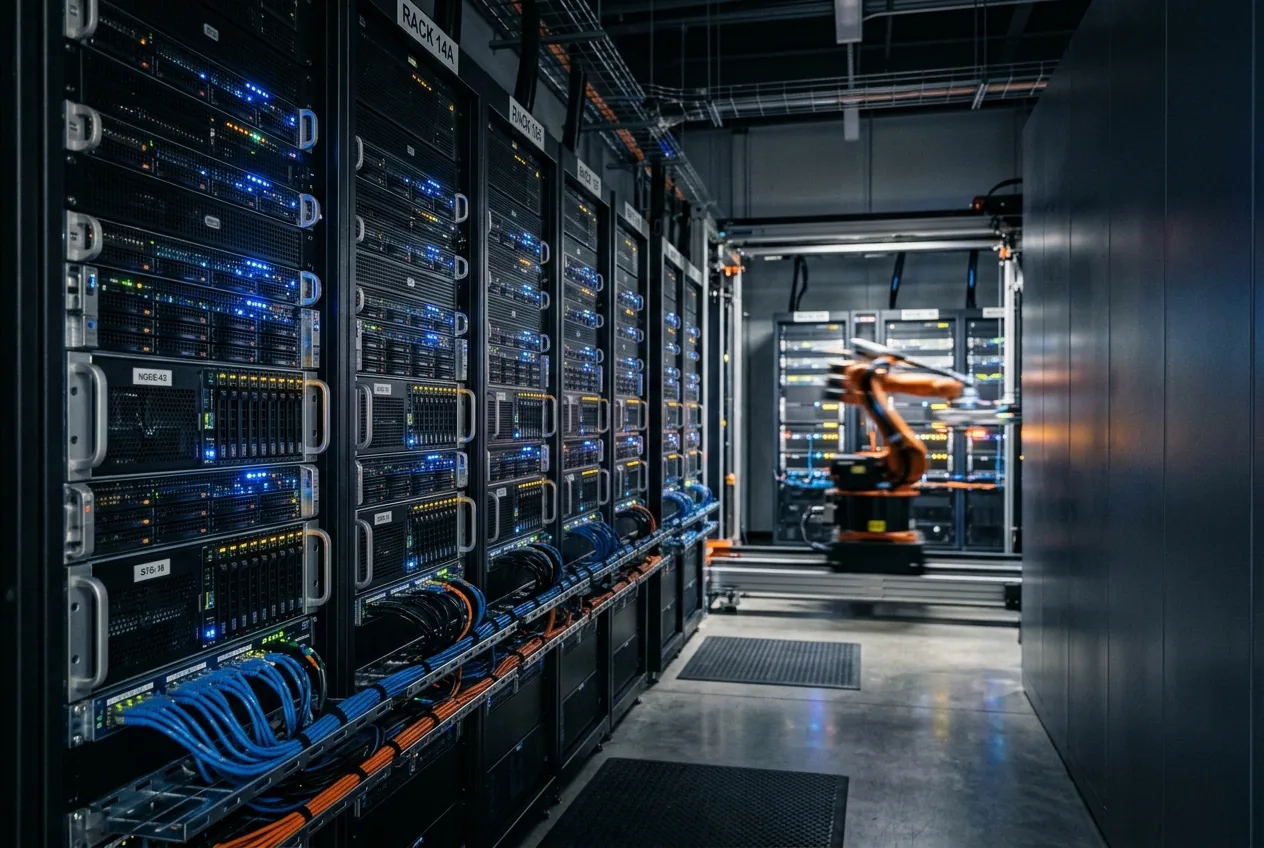
长期以来,企业云基础设施的运作一直受到模型访问碎片化的困扰。尽管开发人员和系统架构师花费多年时间在 Amazon Web Services (AWS) 上实现了计算堆栈的标准化,但部署 OpenAI 的旗舰前沿模型历来需要跨越不同的 API 边界、孤立的数据治理协议以及多云网络开销。OpenAI GPT-5.6 系列——分为 Sol、Terra 和 Luna 三个模型层级——直接部署于 Amazon Bedrock,标志着运营层面的一个转折点。这些系统在 AWS 托管的基础模型服务中原生运行,使基础设施工程师能够在不将关键运营数据路由至其既定虚拟私有云(VPC)之外的情况下,部署尖端的前沿智能。
此举解决了企业领导者在持续集成流水线中一直面临的工程现实:当原始参数规模被普遍应用时,其效率是低下的。随着 GPT-5.6 的推出,OpenAI 摒弃了“单一模型适配一切”的范式,转而采用一种明确的、围绕计算与任务优化设计的“三元架构”。将这一三元架构集成到 Amazon Bedrock 中,弥合了高端生成式功能与工业设施、高吞吐量供应链及复杂自动化软件环境所需的严格治理、低延迟和确定性执行之间的差距。
Sol、Terra 和 Luna 的三元架构
了解如何在 Amazon Bedrock 上实施 GPT-5.6 系列,需要理解支撑每一层级的计算分配。这三层级并非仅仅是单一庞大模型的量化迭代,而是代表了上下文窗口深度、推理密度和单 Token 执行成本之间明确的架构平衡。
GPT-5.6 Sol 代表了该系列中不受约束的层级。Sol 主要为深度结构推理、大规模系统设计和多模态遥测分析而构建,旨在处理海量上下文输入以及复杂的跨域依赖关系。在工业或高科技制造环境中,Sol 承担的任务是摄取数 GB 的工厂车间事件轨迹、运动传感器阵列和 CAD 装配图,以诊断机械故障或预测自动化生产线上的良率损失。由于 Sol 优先考虑递归验证和先进的推理路径,其推理延迟故意被设定得更高,因此最适合非阻塞式异步分析、自主根本原因诊断和任务关键型规划。
GPT-5.6 Terra 是该阵容中的运营主力。它在推理吞吐量与财务成本之间提供了平衡的比例,专门针对确定性智能体流水线、结构化代码生成和复杂的中间件编排进行了优化。Terra 针对需要语义理解但无需深度启发式搜索所带来的计算负担的高容量企业工作负载进行了调整。在编排自动化采购系统、解析企业资源规划 (ERP) 更新或管理程序化机器人拣选计划时,Terra 能够在严格的运营容差内提供稳定、可靠的输出。
GPT-5.6 Luna 位于光谱的另一端,去除了冗余的推理开销,以最大限度地缩短首 Token 时间。Luna 专为高吞吐量、对延迟敏感的推理循环而构建,在这种场景下,决策必须在几分之一秒内完成。在 Bedrock 上运行的 Luna 充当了一个本地化的分类层——处理传感器流过滤、现场机器人的即时自然语言调度、API 载荷的程序化验证以及快速的情感或安全评分。凭借针对快速部署和边缘缓存而优化的内存占用,Luna 消除了曾经导致实时智能体监控成本过高的计算瓶颈。
企业安全与 Bedrock 的控制平面
对于在高度监管行业中操作的系统工程师而言,模型能力次于数据边界的强制执行。通过 Amazon Bedrock 部署 GPT-5.6 系列从根本上改变了生成式模型消费的风险状况。对 Sol、Terra 或 Luna 的调用不会通过公共互联网传输;相反,推理请求通过 AWS PrivateLink 终端节点隔离在消费者专用的 AWS 虚拟私有云内。
这种隔离确保了专有的运营遥测数据、代码库中的知识产权以及工厂网络拓扑结构保持严格受限。通过 Bedrock 接口处理的数据在传输过程中通过 TLS 1.3 进行加密,在静态存储时则通过在 AWS Key Management Service (KMS) 中配置的客户托管密钥进行加密。此外,Bedrock 保证模型提供商不会为了模型微调或二次训练而保留任何数据,这解决了一个长期存在的合规性障碍,该障碍此前曾阻碍航空航天、国防和医疗保健工程部门使用前沿级别的 OpenAI 模型。
通过分层路由优化自动化流水线
企业实施的机械效率完全取决于在 Sol、Terra 和 Luna 之间分配工作负载的路由结构。利用 Amazon Bedrock 的原生智能体框架和编排原语,工程师可以构建分层调度架构,在大幅降低持续推理成本的同时提高整体系统准确性。
例如,在一个自动化供应链配送中心,高速分拣机制每秒产生数千条遥测更新。如果将这些海量的传感器数据交给像 Sol 这样的模型处理,会瞬间使网络饱和并耗尽计算预算。相反,由 Amazon Kinesis 驱动的摄取流水线会将低级事件流直接路由至 Luna。这个轻量级模型将传入的时间序列遥测数据与预期的运营限制进行对比,丢弃常规数据并在几十毫秒内标记出局部异常。
当 Luna 标记出真正的机械瓶颈(例如分拣导流器上的异常电机电流波动)时,它会将结构化的异常载荷交给 Terra。Terra 根据维护历史和自动诊断树解析该事件,尝试生成程序化修复程序或派遣自动导引车 (AGV) 来重新规划库存路线。如果 Terra 检测到涉及网络不稳定和机械故障的系统性复合故障,工作流程会将整个上下文事件日志升级给 Sol。随后,Sol 会根据设施的历史原理图和结构日志执行深度的根本原因综合分析,为人工维修团队制定全面的修复策略。
计算经济学与实际落地实施
将大规模模型部署到持续运营的堆栈中,很快就会变成一项财务遥测任务。Amazon Bedrock 上 GPT-5.6 层级的定价机制鼓励积极使用动态路由。通过将计算负担分散到 Sol、Terra 和 Luna 上,工程团队与单一重型模型的静态部署相比,可以在任务成本上实现数量级的降低。
Bedrock 上的预置吞吐量 (Provisioned Throughput) 选项进一步允许企业在高峰运营时段为 Luna 和 Terra 保留专用的计算块。对于周期固定且必须保证确定性响应窗口的工业应用,预留模型单元可以防止由多租户需求激增引起的推理延迟。相反,异步调用模式可以映射到 Sol 进行批量分析处理,使团队能够在不影响日常运行时系统的情况下利用非高峰期的计算经济性。
工业机器智能的务实进化
OpenAI 的模型工程与 Amazon 云分发架构的融合,标志着一个人工智能部署被视为与数据库、消息队列和计算集群同等务实严谨的时代。企业团队不再需要追逐理论上的对话基准,现在可以将模型层级视为工业流水线中的独立机械组件。
在 Sol、Terra 和 Luna 之间进行选择并非地位之争,而是一项基于带宽、推理预算和实时执行限制的结构性计算。随着工业机器人、自动化供应网络和分布式物理系统要求更高程度的自主性,这种能够将原始计算能力精确应用到所需之处的能力,将把稳健的技术架构与昂贵的数字实验区分开来。




Comments
No comments yet. Be the first!