In einem Ökosystem, in dem die Rechenleistung für Inferenz historisch gesehen harte Ratenbegrenzungen und einen kontingentierten Zugriff diktierte, unterliegen die operativen Mechanismen der künstlichen Intelligenz für Verbraucher einer grundlegenden Neukalibrierung. OpenAI hat seine langjährigen Text-Chat-Limits für Nutzer des kostenlosen Tarifs aufgehoben und gleichzeitig seine GPT-5.6-Modellfamilie auf Verbraucher- und Unternehmensschnittstellen ausgeweitet. Die Einführung umfasst zwei unterschiedliche Systemebenen: GPT-5.6 Luna, ein schlankes Modell, das für den massentauglichen öffentlichen Einsatz konzipiert ist, und GPT-5.6 Sol, eine konsolidierte Reasoning-Engine für kostenpflichtige Abonnements.
Diese strukturelle Änderung ist signifikant. Nutzer des kostenlosen Tarifs – eine Zielgruppe, die OpenAI mittlerweile auf etwa eine Milliarde wöchentlich aktive Personen schätzt – werden auf GPT-5.6 Luna umgestellt, wodurch die restriktiven Ratenquoten entfallen, die zuvor lange Konversationen unterbrachen. Gleichzeitig stellen die kostenpflichtigen Plus- und Pro-Tarife von getrennten Konversations- und Reasoning-Engines auf eine einzige, vereinheitlichte Pipeline um. Indem die sofortige Generierung und das logische Schlussfolgern (Chain-of-Thought) in einem dynamisch skalierbaren System zusammengeführt werden, verdeutlicht diese Veröffentlichung, wie Fortschritte bei der Skalierung der Rechenleistung zur Laufzeit (Test-Time Compute) und der architektonischen Destillation die Ökonomie des Betriebs großer Sprachmodelle im globalen Maßstab verändern.
Die Ökonomie der Abschaffung von Inferenz-Limits
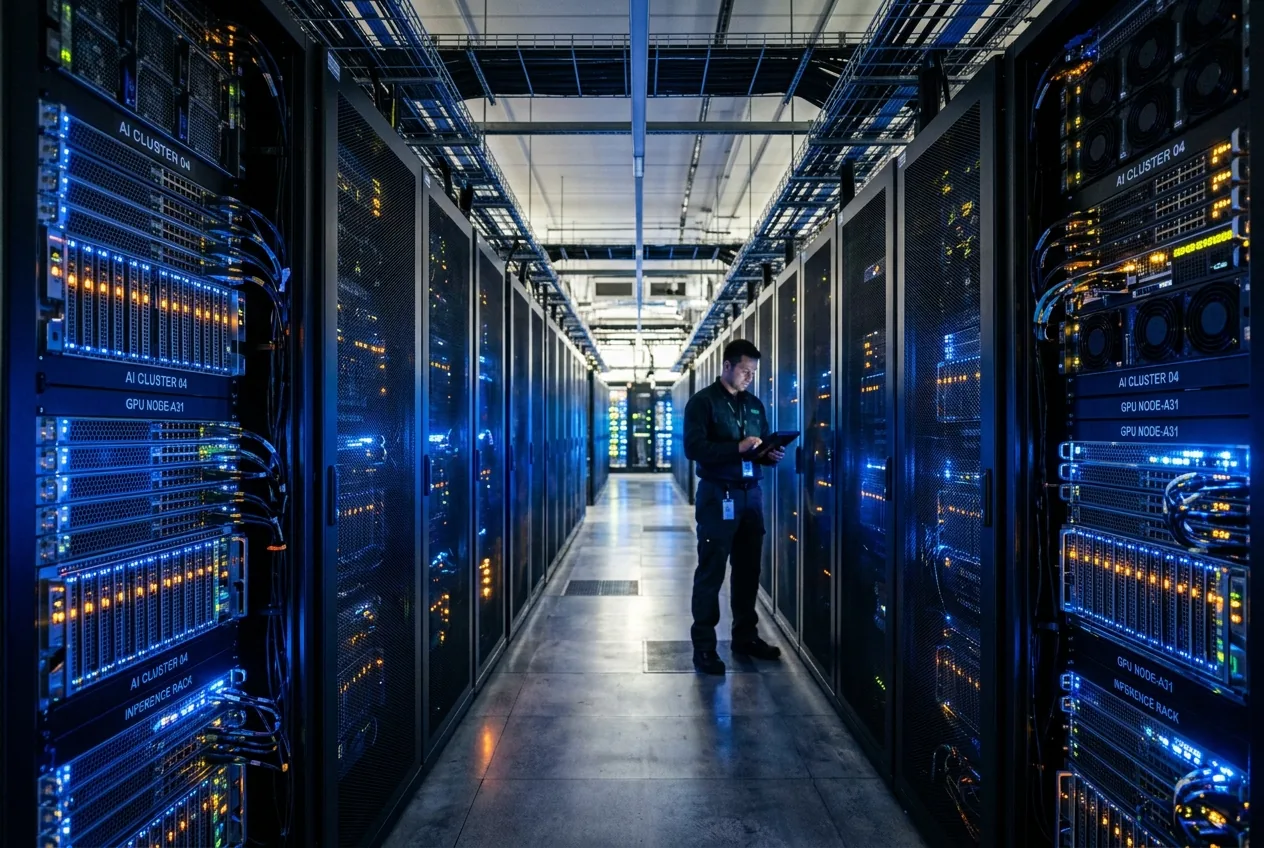
Für Rechenzentrumsbetreiber und Ingenieure der Machine-Learning-Infrastruktur ist die Aufhebung der Ratenbegrenzungen für eine Nutzerbasis von einer Milliarde wöchentlicher Besucher nicht nur eine Produktentscheidung, sondern ein gewaltiges logistisches Unterfangen. Die Generierung von Tokens in dieser Größenordnung erfordert astronomische Gleitkommaoperationen pro Sekunde (FLOPs). Bis zu dieser Veröffentlichung fungierten strenge Nutzungsdrosselungen als Mechanismen zur Laststeuerung, um die zugrunde liegenden GPU- und Accelerator-Cluster vor Spitzenbelastungen in Zeiten hoher Nachfrage zu schützen.
Entscheidend ist, dass die operativen Grenzen streng abgegrenzt bleiben. Während die grundlegende alphanumerische Konversationsbandbreite nun unbegrenzt ist, hat OpenAI die strikte Drosselung für ressourcenintensive Modalitäten beibehalten. Funktionen mit hohem Overhead, einschließlich Bildsynthese, Dateiverarbeitung, automatisierter Codeausführung und bidirektionaler Echtzeit-Sprachstreams, bleiben weiterhin durch Quoten und Abonnement-Schranken begrenzt. Aus Infrastruktursicht bewahrt dies wertvollen High-Bandwidth-Speicher und heterogene Rechenressourcen für margenstärkere Operationen, während für die reine Textgenerierung hochoptimierte Matrix-Multiplikatoren eingesetzt werden.
Zusammenführung von Überlegung und Geschwindigkeit in GPT-5.6 Sol
Während Luna den volumetrischen Anforderungen der öffentlichen Verbraucherebene gerecht wird, führt GPT-5.6 Sol einen entscheidenden technischen Wandel in der Handhabung von Reasoning-Aufgaben durch Systeme mit hohen Parameterzahlen ein. Historisch gesehen erforderten Plattformen der Frontier-KI, dass Benutzer ihr Betriebsparadigma manuell wählen: ein optimiertes „Instant“-Modell für schnellen Dialog mit niedriger Latenz oder eine dedizierte „Reasoning“-Engine, die längere Rechenzyklen für die Synthese schrittweiser Begründungen aufwendete, bevor eine endgültige Antwort ausgegeben wurde.
Sol löst diese operative Dichotomie in einem einzigen Modell auf. Anstatt parallele Modell-Checkpoints zu erfordern oder Anfragen über unterschiedliche neuronale Netzwerkgewichte zu routen, integriert Sol variable Rechenkapazitäten zur Laufzeit direkt in seine interne Dekodierungsstrategie. Diese einheitliche Architektur ermöglicht es dem Modell, seine latente Verarbeitungstiefe basierend auf der Aufgabenkomplexität oder expliziten Nutzersteuerung anzupassen. Nutzer können nun einen integrierten Reasoning-Schieberegler nutzen, um die Rechenzuweisung dynamisch anzupassen – von flacher Token-Exploration für Routineentwürfe bis hin zu tiefen, iterativen Selbstkorrekturpfaden für komplexe Logiksynthese, Finanzanalysen oder Softwarearchitektur.
Diese Konsolidierung führt zu greifbaren Effizienzvorteilen in Unternehmens-Workflows. Bei komplexen Interaktionen mit mehreren Gesprächsrunden verursachte die Aufrechterhaltung separater Kontext-Caches für unterschiedliche Reasoning- und Instant-Modelle erhebliche Latenz-Einbußen und Speicherfragmentierung. Durch die Verwendung eines einzigen Satzes von Gewichten, der sein eigenes Rechenbudget bei Bedarf modulieren kann, bleiben Kontextzustände im Key-Value-Cache (KV-Cache) persistent, was den Overhead durch Neuberechnungen und systemweites Kontext-Switching minimiert.
Benchmarking der Zuverlässigkeit in kritischen Bereichen
In der Vergangenheit hatten aggressive Destillation und Modell-Pruning einen unerwünschten Nebeneffekt: verschlechterte Fakten-Treue und erhöhte Halluzinationsraten. Da Konversationsmodelle auf den nächsten wahrscheinlichsten Token und nicht auf eine verifizierte externe Realität optimiert sind, verschärfte die Reduzierung der Rechenlast oft die epistemische Unzuverlässigkeit. Interne Benchmark-Daten, die zusammen mit GPT-5.6 veröffentlicht wurden, zeigen, dass OpenAI diese Schwachstelle durch verbessertes Alignment und strukturierte Reasoning-Verifizierung direkt angegangen ist.
Über strenge Evaluationssuiten hinweg, die Medizin, Finanz-Compliance und juristische Gesetzesauslegung abdecken, zeigt die GPT-5.6-Familie deutliche Verbesserungen in der faktischen Konsistenz. Im Vergleich zu GPT-5.5 Instant reduzierte GPT-5.6 Sol die faktischen Fehler um 68 Prozent, während die leichtgewichtige Luna-Architektur eine Reduktion ungenauer Ausgaben um 62 Prozent verzeichnete. Diese Verringerungen spiegeln ein strengeres Reinforcement Learning aus menschlichem und automatisiertem Feedback (RLHF/RLAIF) wider, gepaart mit automatisierten Prüfroutinen, die Zwischenschritte der Deduktion vor der Token-Ausgabe bewerten.
Die strategische Divergenz zwischen Unternehmens- und öffentlichen Systemen
Der strategische Einsatz von GPT-5.6 beleuchtet auch die zunehmend zweigeteilte Entwicklungs-Roadmap von OpenAI. Während Luna und Sol plattformübergreifend in Verbraucherumgebungen im Web, auf dem Desktop und auf Mobilgeräten eingeführt werden, stellte OpenAI ausdrücklich klar, dass Unternehmensumgebungen – insbesondere ChatGPT Work und Codex – unter isolierten Wartungslinien betrieben werden, die von diesem sofortigen Verbraucher-Update entkoppelt sind.
Diese Trennung unterstreicht die unterschiedlichen technischen Anforderungen für Verbraucherplattformen im Vergleich zu industriellen Tools mit hoher Sicherheit. In der Softwareentwicklung und industriellen Automatisierung sind deterministisches Verhalten, unveränderliche API-Verträge und konsistente Latenz von größter Bedeutung. Die Einführung architektonischer Überarbeitungen mit dynamischen Reasoning-Schiebereglern kann unbeabsichtigt automatisierte Pipelines, Continuous-Integration-Testsuiten (CI) und strikte Service-Level-Agreements (SLAs) stören. Verbraucherschnittstellen hingegen profitieren unmittelbar von adaptiver Latenz und Crowd-Sourced-Stresstests.
Die langfristige Entwicklung der Skalierung zur Laufzeit
Die Ankunft der GPT-5.6-Generation weist auf einen breiteren Wandel in der Branche hin, weg von reinem Pre-Training-Skalierungsgesetzen hin zur Optimierung der Rechenleistung während der Inferenz. Da physische Rechenzentren auf thermische, elektrische und fertigungstechnische Grenzen stoßen, bringt die bloße Skalierung der Parameteranzahl monolithischer Modelle einen abnehmenden Grenznutzen. Der primäre Hebel für Leistungssteigerungen hat sich auf die intelligente Verteilung von Zyklen während der Inferenzphase verlagert.
Während sich diese Modelle auf alltäglicher Verbraucherhardware und in industriellen Workflows verbreiten, verlagert sich der technische Fokus auf die Perfektionierung der Laufzeit-Kontrollsysteme, die sie verwalten. Die Ausbalancierung von dynamischer Latenz und faktischer Strenge bleibt die zentrale operative Herausforderung des aktuellen generativen Zeitalters. Mit GPT-5.6 erhält die Industrie einen Einblick in eine operative Zukunft, in der Systeme nicht nur Vorhersagen mit konstanter Rate ausgeben, sondern ihre eigene kognitive Latenz gezielt an die ingenieurstechnische Komplexität der anstehenden Aufgabe anpassen.




Kommentare
Noch keine Kommentare. Seien Sie der Erste!