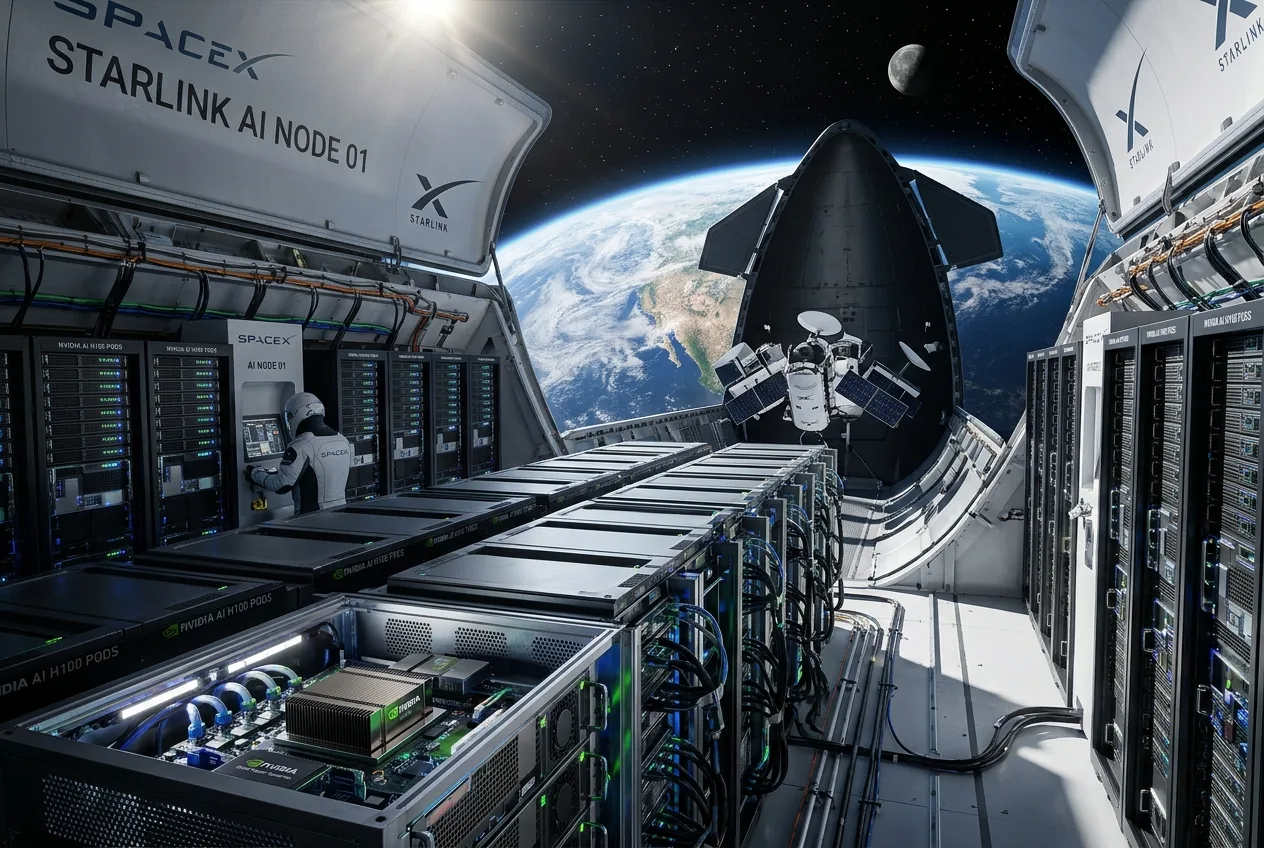
Die physischen Einschränkungen terrestrischer Rechenzentren – die Sättigung der Stromnetze, die Verfügbarkeit von Kühlwasser und begrenzter lokaler Platz – drängen Hochleistungsrechner zunehmend in unkonventionelle Umgebungen. In einem Vorhaben, das Deep Compute mit Orbitalmechanik verbindet, ist SpaceX eine architektonische Partnerschaft mit NVIDIA eingegangen, um Vera-Rubin-Silizium in einer geplanten Megakonstellation namens Starmind einzusetzen. Der bei der Federal Communications Commission eingereichte Antrag auf Zulassung von bis zu einer Million Satelliten im niedrigen Erdorbit umreißt eine beispiellose Vision: Die Verlagerung verteilter KI-Verarbeitungsprozesse von terrestrischen Hyperscale-Anlagen direkt in das Vakuum des Weltraums.
Für Systemingenieure und Hardware-Architekten stellt die Ankündigung eine radikale Abkehr vom konventionellen Luft- und Raumfahrt-Computing dar. Traditionell basiert die Raumfahrt-Rechentechnik auf gehärteten, bewährten Silizium-Komponenten, die auf älteren, strahlungstoleranten Knoten gefertigt werden, um Single-Event-Upsets auf Kosten der Verarbeitungsgeschwindigkeit zu überstehen. Der Starmind-Einsatz setzt jedoch auf die kommende Vera-Rubin-Architektur von NVIDIA, verpackt in die Space-1-Plattform des Chipherstellers. Der Versuch, hochmoderne, leistungsintensive Beschleuniger-Cluster im Orbit zu betreiben, bringt gravierende mechanische, thermodynamische und logistische Hürden mit sich, die die Grenzen moderner Industrie-Ingenieurkunst austesten werden.
Das thermische Dilemma der Strahlungskühlung im Vakuum
Terrestrische Rechenzentren leiten Wärme primär durch Konvektion und Phasenwechselsysteme ab, bei denen gekühlte Flüssigkeiten oder Umgebungsluft über berippte Kupferkühlkörper zirkulieren, bevor die thermische Energie an die Atmosphäre abgegeben wird. Im niedrigen Erdorbit existiert keine Konvektion. Der Weltraum ist ein isolierendes Vakuum, was bedeutet, dass jegliche thermische Energie, die von Silizium-Chips mit hunderten Watt Leistungsaufnahme erzeugt wird, zu Oberflächenstrahlern geleitet und ausschließlich durch Wärmestrahlung abgeführt werden muss.
Die Strahlungsdissipation folgt dem Stefan-Boltzmann-Gesetz und skaliert mit der vierten Potenz der absoluten Temperatur. Da das Silizium unter seinem maximalen Sperrschicht-Schwellenwert bleiben muss – üblicherweise zwischen 85 und 105 Grad Celsius, um thermisches Durchgehen und Elektromigration zu verhindern –, ist das Delta zwischen der Strahleroberfläche und dem tiefen Weltraum begrenzt. Um die zig Kilowatt abzuführen, die ein hochdichtes Compute-Rack wie eine Orbit-Variante der NVL72-Architektur von NVIDIA erfordert, muss jeder Starmind-Bus massive ausfahrbare Wärmerohre, Loop Heat Pipes (LHPs) und großflächige Strahlungsbleche einsetzen, die vor direkter Sonneneinstrahlung geschützt sind. Die mechanische Komplexität dieser Thermomanagementsysteme birgt zahlreiche potenzielle mechanische Fehlerquellen, von Entfaltungsmechanismen bis hin zur Materialermüdung an Flüssigkeitsverbindungen.
Silizium-Architektur und das Space-1-Modul
NVIDIA’s Space-1-Plattform integriert Vera-CPUs und Rubin-GPUs über ein fortschrittliches Packaging, das darauf ausgelegt ist, die spezifischen Gefahren der Weltraumumgebung zu mindern. Während terrestrische Varianten auf rohe FLOP-Dichte und ultra-breite Speicherbusse optimiert sind, muss eine Orbit-Recheneinheit kosmische Strahlung, solare energetische Teilchen und die eingefangene Strahlung in den Van-Allen-Gürteln ohne katastrophale Latch-up-Effekte überstehen.
Anstatt sich ausschließlich auf physische Abschirmung zu verlassen, was die Startmasse prohibitiv erhöhen würde, nutzt modernes Space-Edge-Computing einen hybriden Ansatz. Dieser kombiniert eine lokalisierte Abschirmung aus Tantal oder Wolfram um die Logik-Dies mit architektonischer Strahlungsminderung, wie etwa dreifacher modularer Redundanz auf Registerebene, fehlerkorrigierendem Code für High-Bandwidth-Memory-Stacks und aggressiver Echtzeit-Telemetrieüberwachung. NVIDIA gibt an, dass die Space-1-Rubin-Plattform bis zu 25-mal die Rechenleistung früherer Hopper-Architekturen pro Nutzlast-Einheit liefert – eine Kennzahl, die entscheidend ist, um innerhalb der strukturellen Massenvorgaben kleiner bis mittelgroßer Satelliten-Chassis zu bleiben.
Das strategische Ziel hinter Starmind ist nicht nur allgemeine Cloud-Inferenz für terrestrische Nutzer, sondern die Reduzierung von Daten am "Edge" im Orbit. Die im Orbit generierten Daten – aus Synthetic Aperture Radar, hyperspektraler Bildgebung und Multisensor-Verteidigungsarrays – produzieren derzeit weitaus mehr Rohdaten, als bestehende HF- und optische Downlinks zu Bodenstationen übertragen können. Durch das Verarbeiten, Tokenisieren und Synthetisieren von Rohdaten im Orbit mittels On-Board-Sprach- und Bildmodellen können Starmind-Satelliten beobachtungsbasierte Rohdatenfeeds um Größenordnungen komprimieren, bevor sie wertvolle, handlungsorientierte Informationen nach unten senden.
Lasernetze und die Physik des verteilten Rechnens
Die Vernetzung eines verteilten Systems aus bis zu einer Million Satelliten erfordert eine Kommunikationsstruktur, die mit der internen Latenz eines lokalisierten Rechenzentrums mithalten kann. SpaceX beabsichtigt, die Starmind-Konstellation über optische Hochgeschwindigkeits-Inter-Satelliten-Verbindungen zu koppeln. Während optische Freiraumkommunikation einen Durchsatz im Multi-Gigabit-Bereich bietet und mit Lichtgeschwindigkeit arbeitet – etwa 30 Prozent schneller im Vakuum als in terrestrischen Glasfaserkabeln –, bringt sie komplexe Herausforderungen bei Ausrichtung, Erfassung und Nachführung mit sich.
Ein verteilter KI-Cluster ist bei Modeltrainings und der Orchestrierung agentischer Arbeitsabläufe stark auf latenzarme All-to-All-Kommunikationsprimitive angewiesen. Die Synchronisierung von Speicherzuständen über Satelliten hinweg, die sich mit 7,5 Kilometern pro Sekunde bewegen, erfordert strahllenkende Spiegel, die eine Sub-Mikroradian-Präzision inmitten der Schwingungen interner Reaktionsräder erreichen können. Wenn eine Verbindung mitten in einer Tensor-Reduktion abbricht, bricht der verteilte Compute-Graph zusammen. Folglich muss die Netzwerktopologie von Starmind eher auf lose gekoppelte, asynchrone agentische Arbeitsabläufe oder föderierte Verarbeitungsmodelle setzen als auf monolithische, synchron trainierte große Sprachmodelle.
Orbitale Überlastung und die Wirtschaftlichkeit der Starship-Skalierung
Selbst wenn die thermischen und architektonischen Hürden überwunden werden, stellt der industrielle Maßstab des Starts von Hunderttausenden – geschweige denn einer Million – Rechensatelliten eine beispiellose logistische Belastung dar. Die vorgeschlagenen Einsatzorbits zwischen 500 und 2.000 Kilometern sind bereits dicht besiedelte Zonen. Die Aufnahme einer um eine Größenordnung größeren Anzahl aktiver Plattformen in den niedrigen Erdorbit erhöht die Wahrscheinlichkeit orbitaler Konjunktionen signifikant und steigert den betrieblichen Aufwand für automatisierte Kollisionsvermeidung.
Auf operativer Ebene ist Starmind vollständig auf die Frequenz und Nutzlastkapazität der SpaceX-Trägerrakete Starship angewiesen. Die Falcon 9 ist zwar zuverlässig, ihr fehlt jedoch das Verkleidungsvolumen und die Massen-zu-Orbit-Wirtschaftlichkeit, die für den Einsatz orbitaler Rechenzentren in diesem Maßstab erforderlich sind. Jeder Satellit benötigt beträchtliche Flächen zur Energiegewinnung: Hocheffiziente Solarpaneele, die Dutzende Quadratmeter umspannen, um während des Tagesbetriebs kontinuierlich Strom zu liefern, gekoppelt mit hochdichten Batteriespeichern für die Schattenphasen. Nur ein System mit extrem hoher Traglast, das mit hoher Frequenz operiert, kann die Kosten-Nutzen-Rechnung für die Masse in den Orbit tragfähig machen.
Der finanzielle Maßstab ist ebenso gewaltig. Die rapide Beschleunigung der Investitionsausgaben von SpaceX – das in jüngsten Zyklen die 15-Milliarden-Dollar-Schwelle überschritten hat, bei Berichten über den Wunsch nach zweistelligen Milliardenbeträgen für dedizierte Silizium-Beschaffungen – signalisiert ein massives Glücksspiel auf die Zukunft der Infrastruktur. Die Entwicklung terrestrischer Rechenzentren wird derzeit durch 5- bis 7-jährige Zeitpläne für die Anbindung an die Stromnetze im Versorgungsmaßstab ausgebremst. Wenn die Bauzeit für terrestrische Stromerzeugung die Kosten- und Frequenzkurve der Starts übersteigt, hört das Orbit-Computing auf, ein exzentrisches Konzept zu sein, und wird stattdessen zu einem wirtschaftlich tragfähigen Umweg für die Stagnation der globalen Stromnetze.
Die langfristige Entwicklung der Automatisierung im Orbit
Die Konvergenz der Silizium-Roadmap von NVIDIA und der Heavy-Lift-Frequenz von SpaceX deutet darauf hin, dass die Orbit-Infrastruktur den Übergang von statischen Kommunikationsrelais zu dynamischen, rekonfigurierbaren Roboterknoten vollzieht. Ein mit Hochleistungsrechentechnik ausgestatteter Satellit ist kein Gerät mit festem Funktionsumfang mehr; er ist ein autonomer Roboteragent, der in der Lage ist, Sensoren neu auszurichten, Flugbahnen zur Optimierung der Sonneneinstrahlung neu zu berechnen und On-Board-Inferenz ohne menschliches Eingreifen auszuführen.




Kommentare
Noch keine Kommentare. Seien Sie der Erste!