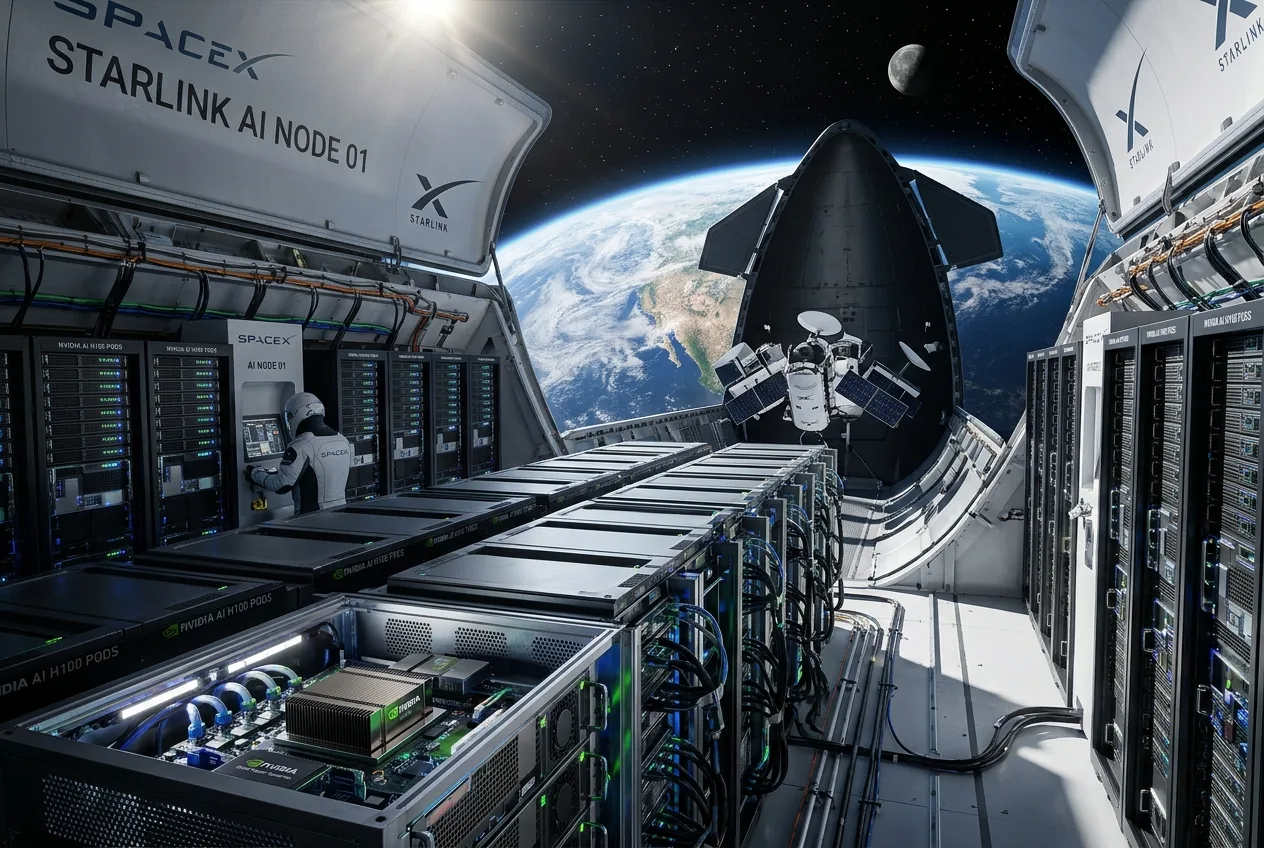
地球计算所面临的物理限制——如电网饱和、用于冷却的水资源可用性以及当地土地供应的短缺——正推动高性能计算向日益非常规的环境转移。在一项旨在将深度计算与轨道力学相结合的举措中,SpaceX 与 NVIDIA 达成了一项架构合作伙伴关系,计划在一项名为 Starmind 的超大规模卫星星座中部署 Vera Rubin 级芯片。这项提交给联邦通信委员会(FCC)的备案申请寻求批准部署多达 100 万颗近地轨道卫星,勾勒出了一个前所未有的愿景:将分布式人工智能处理工作从地球上的超大规模设施直接转移到太空真空中。
对于系统工程师和硬件架构师而言,这一公告标志着对传统航空航天计算的根本性背离。传统上,太空级计算依赖于在较老、抗辐射工艺节点上制造的加固型传统芯片,这些芯片以牺牲处理速度为代价来确保在单粒子翻转(SEU)中幸存。然而,Starmind 的部署致力于采用 NVIDIA 即将推出的 Vera Rubin 架构,并将其封装在芯片制造商的 Space-1 平台内。尝试在轨道上运行前沿、高功率的加速器集群,引入了严峻的机械、热力学和后勤障碍,这将考验现代工业工程的极限。
真空环境辐射冷却的热力学困境
陆地数据中心主要通过对流和相变系统散热,使冷却液或环境空气流经带翅片的铜制散热器,然后将热能排放到大气中。在近地轨道上,不存在对流现象。太空是一个隔热真空环境,这意味着由每颗芯片数百瓦功率运行产生的任何热能,都必须传导至表面散热器,并完全通过热辐射来散发。
辐射散热遵循斯蒂芬-玻尔兹曼定律,与绝对温度的四次方成正比。由于硅芯片必须保持在其最高结温阈值以下(通常在 85 摄氏度至 105 摄氏度之间,以防止热失控和电迁移),因此散热器表面与深空之间的温差受到限制。为了散发如 NVIDIA NVL72 架构轨道变体等高密度计算货架所需的数千瓦热量,每颗 Starmind 卫星总线都必须部署大型可展开热管、环路热管(LHP)以及避开太阳直射的大面积辐射板。这些热管理系统的机械复杂性带来了大量的机械故障点,从展开执行器到流体接头疲劳均包含在内。
芯片架构与 Space-1 模块
NVIDIA 的 Space-1 平台将 Vera CPU 和 Rubin GPU 集成在先进封装上,旨在减轻太空环境的特定危害。虽然地面变体优先考虑原始 FLOP 密度和超宽存储器总线,但轨道计算单元必须在不发生灾难性闩锁的情况下,在范艾伦辐射带中经受住宇宙射线、太阳高能粒子和俘获辐射的考验。
现代空间边缘计算不再仅仅依赖增加发射质量的物理屏蔽,而是采用混合方法。这种方法将局部钽或钨屏蔽层围绕在核心逻辑芯片周围,并结合架构层面的抗辐射措施,例如寄存器级别的三模冗余、跨高带宽内存堆栈的纠错码(ECC),以及积极的实时遥测监控。NVIDIA 声称,Space-1 Rubin 平台每单位载荷的计算性能可达上一代 Hopper 架构的 25 倍,这一指标对于保持在中小型卫星底盘的结构质量范围内至关重要。
Starmind 的战略意图不仅是为地球用户提供通用云推理,而是实现轨道边缘减量。目前,在轨数据生成——来自合成孔径雷达、高光谱成像和多传感器防御阵列——产生的原始遥测数据远远超过了现有射频和光学下行链路回传至地面站的能力。通过在轨利用机载语言和视觉模型对原始数据进行处理、标记化和合成,Starmind 卫星可以在下传高价值的可操作情报之前,将原始观测信息流压缩数个数量级。
激光网格与分布式计算的物理学
连接一个多达 100 万颗卫星的分布式网络,需要一种能够匹配本地数据中心内部延迟的通信架构。SpaceX 计划通过高吞吐量光卫星间链路连接 Starmind 星座。虽然自由空间光通信提供多千兆位吞吐量并以光速运行——在真空中比在地面玻璃光纤电缆中快约 30%——但它们带来了复杂的对准、捕获和跟踪挑战。
分布式 AI 集群在模型训练和代理工作流编排过程中,极大地依赖低延迟、全对全的通信原语。要在以每秒 7.5 公里速度移动的卫星之间同步内存状态,需要能够在内部动量轮振动中实现亚微弧度精度的光束控制反射镜。如果在张量归约过程中链路断开,分布式计算图就会断裂。因此,Starmind 的网络拓扑结构必须优先考虑松耦合的异步代理工作流或联邦处理模型,而不是单体式、同步训练的大语言模型。
轨道拥挤与星舰规模的经济学
即使克服了热力学和架构方面的障碍,发射数十万甚至 100 万颗计算卫星的工业规模也会带来前所未有的后勤压力。拟议部署的轨道(位于 500 到 2,000 公里之间)已经是人口稠密的区域。在近地轨道上增加一个数量级的活跃平台,会显著提高轨道交汇的概率,并增加自动防撞的运营成本。
在运营层面,Starmind 完全依赖于 SpaceX“星舰”(Starship)运载火箭的频率和载荷能力。虽然“猎鹰 9 号”(Falcon 9)运行可靠,但缺乏大规模部署轨道数据中心所需的整流罩容积和入轨质量经济性。每颗卫星都需要巨大的功率捕获表面:面积达数十平方米的高效太阳能电池阵列以提供白天运行的连续电力,并辅以用于日食阶段的高密度电池存储。只有高频运行的超重型运载系统,才能使入轨质量成本公式具有可行性。
财政规模同样令人望而生畏。SpaceX 资本支出的快速增长——在近期的周期中已突破 150 亿美元大关,据报道其有意投入数百亿美元进行专门的芯片采购——标志着对基础设施未来的大规模豪赌。目前,地面数据中心的开发正因公用事业级电网互联需要 5 到 7 年的审批周期而受阻。如果地面发电的建设时间超过了发射成本和频率曲线,轨道计算将不再是一个离奇的概念,而将成为绕过全球电网停滞、具有经济可行性的替代方案。
在轨自动化的长期轨道
NVIDIA 的芯片路线图与 SpaceX 重型运载频率的融合表明,轨道基础设施正从静态通信中继点转型为动态、可重配置的机器人节点。配备高性能计算的卫星不再是功能固定的设备;它是一个自主的机器人代理,能够重新分配传感器、重新计算轨道以优化太阳能获取,并在无需人工干预的情况下执行在轨推理。




Comments
No comments yet. Be the first!