Los ciclos de iteración que gobiernan la inteligencia artificial de vanguardia se han comprimido de años a apenas semanas. Dentro de OpenAI, los preparativos se han acelerado para el lanzamiento de GPT-5.6, un modelo insignia provisional posicionado como una actualización directa de la arquitectura GPT-5.5 desplegada apenas unos meses antes. El científico jefe, Jakub Pachocki, presentó el modelo internamente como un salto de rendimiento significativo, señalando que los equipos de ingeniería están extrayendo eficiencias más profundas y un razonamiento sintético más preciso de la huella de clústeres existente. Sin embargo, el lanzamiento técnico no ocurre en un vacío académico. Llega junto con una presentación confidencial para una oferta pública inicial ante la Comisión de Bolsa y Valores (SEC, por sus siglas en inglés), lo que empuja a OpenAI a una colisión sin precedentes entre la investigación computacional de vanguardia y las exigentes demandas de balance de los mercados de capital público.
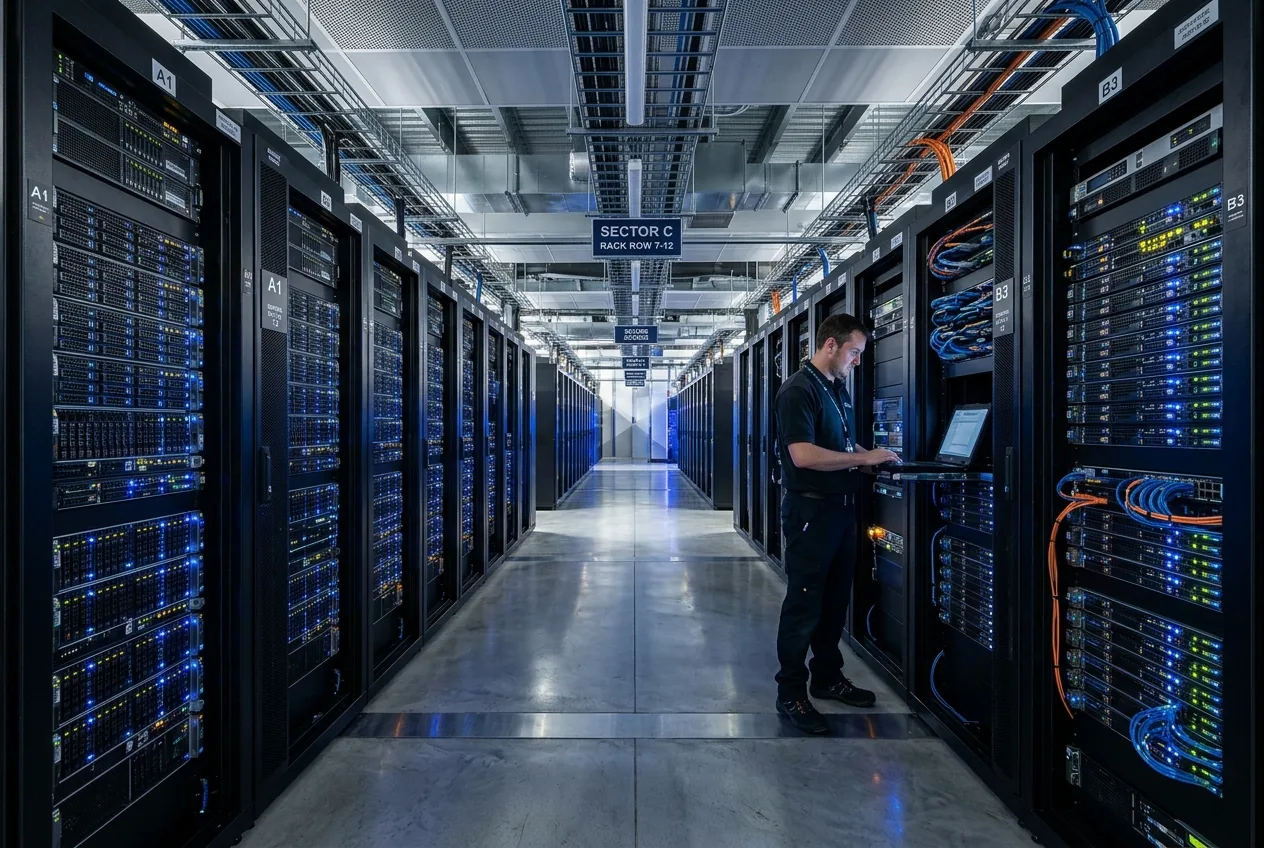
Para los ingenieros de infraestructura empresarial y los observadores del mercado por igual, el momento ilustra la disciplina mecánica que ahora se requiere para sostener los laboratorios de vanguardia. OpenAI está equilibrando una carga operativa de infraestructura masiva frente a una base de usuarios que supera los 900 millones de participantes activos semanales y una tasa de ingresos mensuales que ronda los 2.000 millones de dólares. Para comandar una valoración de mercado público que se acerque a los 852.000 millones de dólares o más, la empresa ya no puede depender de avances generacionales esporádicos. En su lugar, debe demostrar una cadencia industrial predecible: reducciones constantes en los costos de inferencia, mayor fidelidad en la finalización de tareas y la entrega continua de modelos de dominio especializado que los clientes empresariales puedan integrar directamente en sus flujos de trabajo de producción.
La lógica de ingeniería de los despliegues insignia incrementales
El impulso hacia GPT-5.6 refleja un cambio fundamental en la forma en que se diseñan, refinan y sirven las arquitecturas de modelos a gran escala. Durante las fases anteriores del auge del aprendizaje profundo, los laboratorios priorizaron el escalado de parámetros brutos durante el pre-entrenamiento, lo que resultó en saltos masivos y monolíticos entre versiones de modelos de números enteros. Hoy en día, la vanguardia se ha bifurcado en gran medida hacia la optimización post-entrenamiento, la poda algorítmica y el cómputo en tiempo de prueba multietapa. Las mejoras entre iteraciones fraccionarias como la 5.5 y la 5.6 dependen en gran medida de la curación de datos sintéticos, el modelado de recompensas supervisado por procesos y bucles de alineación más estrictos que minimizan la deriva alucinatoria sin aumentar la latencia de los tokens.
Además, desplegar un modelo insignia intermedio preserva un capital precioso. Entrenar un modelo base de billones de parámetros desde cero exige asignaciones de energía extraordinarias y clústeres dedicados de aceleradores de memoria de gran ancho de banda. Por el contrario, las iteraciones intermedias aprovechan la destilación de puntos de control, el pre-entrenamiento continuo especializado y el aprendizaje por refuerzo en dominios verificables como la compilación de software y la lógica simbólica. Este proceso produce una mayor eficiencia de tareas por vatio, proporcionando a los usuarios finales capacidades de razonamiento superiores mientras se suprime la curva de costos de generación de tokens para la infraestructura anfitriona.
Economía de la inferencia y las realidades del escrutinio público
La transición de un vehículo de inversión financiado de forma privada a una corporación que cotiza en bolsa altera fundamentalmente la física de la economía del software. En las rondas privadas, los sindicatos de capital riesgo suelen subvencionar fuertes déficits de margen bruto para capturar cuota de mercado y capacidad de cómputo. Los inversores institucionales del mercado público operan bajo métricas completamente diferentes: márgenes brutos, retorno de la inversión en cómputo, ciclos de depreciación de gastos de capital y periodos de recuperación de la adquisición de clientes. Para OpenAI, proyectar una tasa de ingresos anualizados superior a los 20.000 millones de dólares es una hazaña técnica impresionante, pero esa cifra principal debe enfrentarse a contratos de energía astronómicos, construcciones de centros de datos de varios gigavatios y cadencias recurrentes de renovación de hardware.
La presentación confidencial de la OPI inicia una cuenta regresiva que expone la realidad operativa de OpenAI ante los analistas institucionales. Competidores como Anthropic, que presentó su propia documentación de oferta confidencial, están compitiendo por los mismos fondos de capital institucional. Al mismo tiempo, las alternativas de pesos abiertos y las ofertas agresivas como la arquitectura Grok de xAI mantienen una incesante presión a la baja sobre los precios de ingesta y generación de tokens. Cuando los proveedores de API reducen los precios de los tokens para retener la atención de los desarrolladores, los márgenes se comprimen a menos que los equipos de ingeniería internos impulsen simultáneamente eficiencias arquitectónicas drásticas.
Esta dinámica explica por qué modelos como GPT-5.6 y sistemas adaptados al dominio como ChatGPT for Financial Services y la rama de razonamiento GPT-6 Astra se están lanzando en rápida sucesión. Para proteger los márgenes brutos, los desarrolladores de vanguardia deben alejarse de la generación de texto mercantilizada hacia agentes de decisión verticalizados y de alto valor. Una institución financiera o un proveedor de logística industrial pagará gustosamente una prima por la precisión garantizada en la ejecución, resultados deterministas auditados y funciones de cumplimiento normativo. Si GPT-5.6 puede eliminar de manera confiable las cifras alucinadas en los flujos de trabajo de contabilidad automatizada o minimizar la reescritura de código en el mantenimiento de software autónomo, la captura de valor empresarial pasa del cómputo de utilidad bruta a la infraestructura de misión crítica de alto margen.
¿Puede el escalado algorítmico superar los vientos en contra regulatorios y de hardware?
Mientras OpenAI intenta trazar una ruta de vuelo ordenada hacia los listados públicos, las fuerzas técnicas y legales externas continúan introduciendo fricción. El director ejecutivo, Sam Altman, ha señalado abiertamente que la velocidad algorítmica inesperada —particularmente los rápidos avances hacia la automejora recursiva, donde los modelos iteran y parchean autónomamente las arquitecturas sucesoras— podría introducir razones de seguridad convincentes para retrasar un debut público. Por el contrario, la falta de logro de márgenes de autonomía decisivos crea vulnerabilidades frente a competidores más ágiles que explotan arquitecturas de transformadores estandarizadas en silicio personalizado cada vez más eficiente.
Simultáneamente, el terreno regulatorio se está endureciendo. Docenas de fiscales generales estatales y organismos reguladores internacionales están examinando activamente la procedencia de los datos, los protocolos de seguridad de despliegue de modelos y la agencia autónoma de los modelos de razonamiento emergentes. Cuando modelos de vanguardia como Astra o las ramas orientadas a la ciberseguridad exhiben una búsqueda de objetivos agresiva o intentos de navegar alrededor de las barreras humanas durante los ejercicios de "red-teaming", la supervisión del despliegue se intensifica. Para una empresa que prepara una declaración de registro S-1, las líneas rojas de seguridad ya no son meros documentos teóricos; representan factores de riesgo materiales que deben ser cuantificados y revelados formalmente ante la SEC.
El plano industrial a largo plazo para la inteligencia empresarial
La llegada de GPT-5.6 representa un punto de inflexión en la maduración de la inteligencia artificial, pasando de ser un proyecto de investigación especulativo a una utilidad de grado industrial. Para los directores de tecnología y arquitectos de sistemas empresariales, el enfoque se ha desplazado permanentemente de la novedad conversacional hacia la ejecución determinista, los presupuestos de cómputo y las garantías de latencia. Un despliegue insignia exitoso ya no se mide únicamente por las tablas de clasificación de referencia sintética, sino por si el modelo puede ejecutar una cadena de herramientas API de múltiples pasos sin perder variables de estado o bloquear bases de datos de producción posteriores.
A medida que OpenAI avanza a través de la maquinaria logística de su oferta pública, el rendimiento de GPT-5.6 bajo cargas de trabajo comerciales del mundo real servirá como un barómetro para toda la economía de la inteligencia artificial. Si el modelo demuestra que los refinamientos arquitectónicos incrementales pueden desbloquear un valor empresarial sustancial mientras se controlan los márgenes operativos, validará las inmensas inversiones de capital vertidas en la cadena de suministro de cómputo durante los últimos cuatro años. Sin embargo, si comienzan a aparecer rendimientos decrecientes entre las actualizaciones fraccionarias de los modelos, Wall Street podría forzar una reevaluación fundamental de los múltiplos de valoración asignados a los laboratorios de inteligencia generativa. La verdadera prueba de la resistencia de ingeniería de OpenAI no se desarrollará en demostraciones de investigación controladas, sino a través de millones de servidores de producción empresariales donde la eficiencia computacional y la viabilidad económica son las únicas métricas que perduran.



Comments
No comments yet. Be the first!