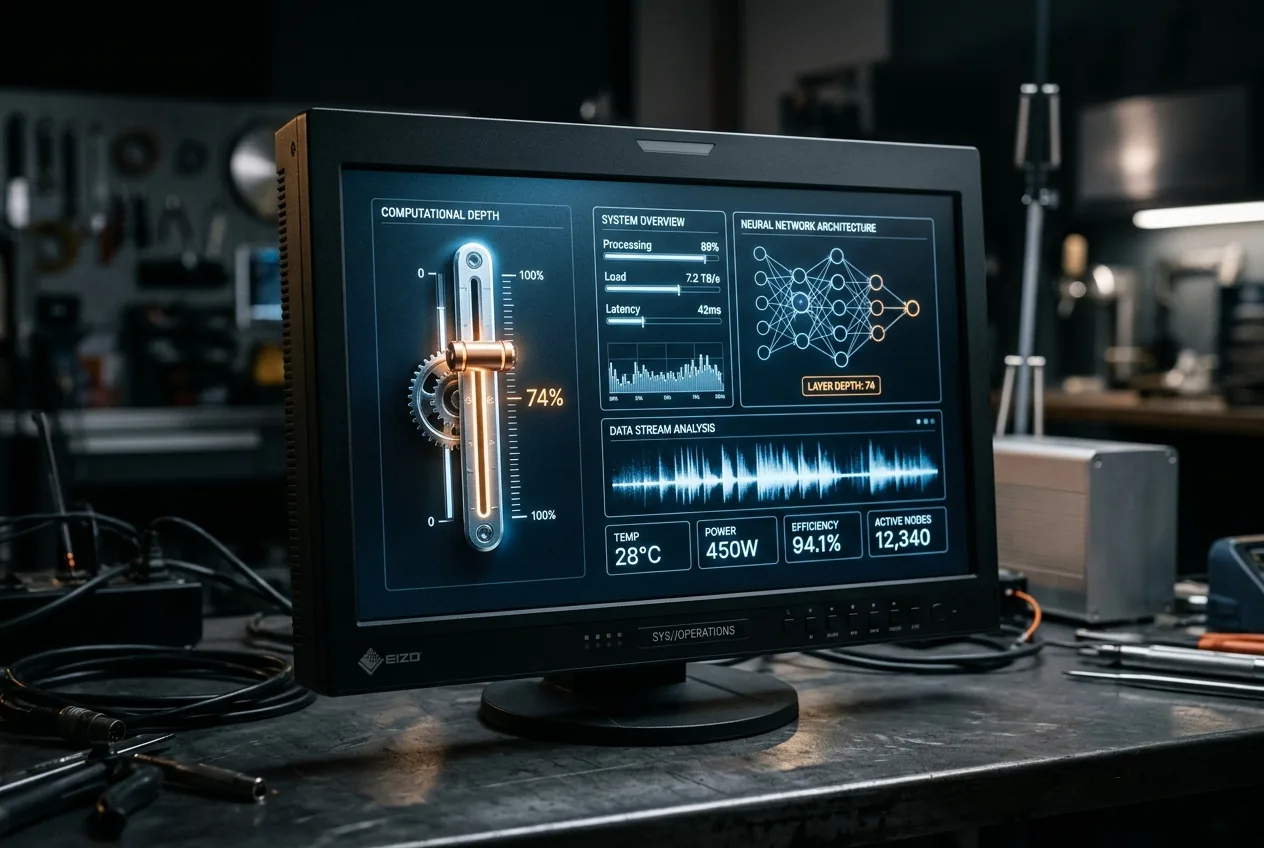
Una transformación silenciosa se está produciendo en la infraestructura que impulsa la interacción digital global. OpenAI ha iniciado una revisión exhaustiva de la arquitectura en todos los niveles de consumo y profesionales de ChatGPT, realineando fundamentalmente cómo se distribuye el cómputo entre sus aproximadamente mil millones de usuarios activos semanales. Los usuarios gratuitos han sido migrados a un nuevo modelo optimizado llamado GPT-5.6 Luna, que permite conversaciones de texto sin límites y sin estrangulamiento artificial. Simultáneamente, los niveles de pago Plus y Pro están recibiendo GPT-5.6 Sol, junto con un mecanismo de interfaz de estilo físico que permite a los operadores gobernar directamente el cómputo de razonamiento del modelo durante el tiempo de ejecución.
El despliegue representa un cambio estratégico importante desde el cambio de modelo rígido y discreto hacia un escalado de inferencia continuo y basado en la demanda. Durante años, la IA conversacional orientada al consumidor obligó a los usuarios a tomar una decisión binaria inicial: dirigir una consulta a un modelo ligero de baja latencia diseñado para preguntas sencillas, o enviarla a un motor de razonamiento costoso y multietapa capaz de realizar deducciones complejas. Con el lanzamiento de la familia GPT-5.6, OpenAI reemplaza ese enfoque fragmentado por pesos de parámetros unificados y asignaciones de cómputo variables, alterando fundamentalmente la economía de la inteligencia artificial orientada al consumidor.
La arquitectura detrás del acceso gratuito ilimitado
Proporcionar chat de texto sin restricciones ni límites a una base de usuarios que cuenta por cientos de millones es principalmente un desafío de hardware y eficiencia, más que una novedad matemática. Los gastos operativos asociados con la generación continua de tokens a escala global han requerido históricamente límites de velocidad artificiales, temporizadores de enfriamiento o degradaciones obligatorias del modelo durante la carga máxima del centro de datos. Para eliminar estas barreras para los usuarios gratuitos, OpenAI desarrolló GPT-5.6 Luna como un motor de inferencia ultraeficiente y altamente destilado, construido explícitamente para maximizar el rendimiento por vatio.
Luna se aleja de la expansión bruta de parámetros, apoyándose en cambio en la poda arquitectónica densa, tuberías de decodificación especulativa especializadas y un almacenamiento en caché de clave-valor fuertemente optimizado en todo el clúster de alojamiento. Si bien Luna elimina por completo los límites de conversación de texto, el sistema más amplio mantiene protecciones en cargas de trabajo multimodales que consumen mucho ancho de banda. Las ingestas de archivos, el análisis de datos estructurados y las rutinas de generación de imágenes siguen sujetos a límites estrictos de consumo. Sin embargo, para el texto, Luna opera como una capa de utilidad persistente y de baja latencia.
Para evitar que Luna tropiece cuando se enfrenta a consultas ambiguas o altamente anidadas, la interfaz introduce un interruptor de procesamiento dedicado. Debido a que Luna no es un modelo base expansivo de fuerza bruta, este mecanismo permite al usuario ordenar explícitamente a la red que ejecute pasos de verificación secundarios. En pruebas internas evaluadas en dominios fuertemente regulados como las finanzas, la salud y el derecho administrativo, GPT-5.6 Luna demostró una reducción del 62 por ciento en las tasas de error factual en comparación con la línea base GPT-5.5 Instant, lo que ilustra cuánta estabilidad estructural se puede diseñar en una huella de ejecución más pequeña.
La mecánica de la inferencia en tiempo de ejecución y el control deslizante de pensamiento
Mientras que el nivel gratuito se beneficia de una destilación de modelo implacable, el nivel de suscripción de pago introduce un mecanismo más granular para los operadores técnicos: el control deslizante de razonamiento dinámico. Tomado del entorno de ingeniería especializado de Codex, este control de interfaz otorga a los usuarios Plus y Pro gobernanza directa sobre la profundidad de búsqueda interna de GPT-5.6 Sol. En lugar de interactuar con el modelo como una caja negra estática que genera un flujo de tokens inalterable, los usuarios pueden escalar mecánicamente el presupuesto computacional asignado para deliberar antes de generar un solo carácter visible.
En los modelos de texto autorregresivos estándar, el costo de inferencia es esencialmente fijo por token de salida. La red predice el siguiente token en la secuencia basándose únicamente en la ventana de contexto anterior, proporcionando un espacio mínimo para evaluar rutas alternativas o corregir suposiciones erróneas a mitad del proceso. Por el contrario, las arquitecturas de razonamiento dependen del cómputo en tiempo de ejecución, generando gráficos de búsqueda ocultos, bucles de autocrítica y rutas de verificación de cadena de pensamiento entre bastidores. El control deslizante recién implementado traduce la intención del usuario de alto nivel en presupuestos de tokens de bajo nivel, alterando dinámicamente el factor de ramificación del árbol de búsqueda.
- Posición baja (Respuesta directa): El modelo suprime los tokens de búsqueda ocultos, priorizando las respuestas rápidas de tiempo hasta el primer token para búsquedas de sintaxis programáticas, traducciones rápidas y recuperaciones factuales básicas.
- Posición equilibrada (Planificación contextual): El modelo inicia comprobaciones moderadas de autoconsistencia, filtrando el ruido conversacional, identificando los objetivos implícitos del usuario y estructurando esquemas complejos sin latencia cognitiva innecesaria.
- Posición alta (Inferencia profunda): El sistema asigna un presupuesto de razonamiento expansivo, explorando vías analíticas en competencia, realizando análisis contrafactuales de varias pasadas y probando rigurosamente la lógica de ingeniería o legal compleja antes de entregar un resultado sintetizado.
Este ajuste dinámico resuelve una frustración persistente entre los usuarios técnicos: la sobrecarga cognitiva. Anteriormente, los modelos de razonamiento avanzado pensaban demasiado en consultas transaccionales simples, envolviendo respuestas directas en preámbulos complicados y justificaciones anidadas. Con la nueva implementación de GPT-5.6 Sol, una consulta sobre variables atmosféricas locales para el ciclismo ya no produce un volcado indiscriminado de presión barométrica y métricas de precipitación. El modelo evalúa el objetivo funcional, aísla la cizalladura del viento y la velocidad convectiva como las principales restricciones de rendimiento, y suprime las variables irrelevantes para ofrecer una evaluación procesable y específica para la misión.
Abordar el déficit de alucinaciones en la producción
Más allá de las mejoras ergonómicas, la principal métrica de rendimiento que rige la generación 5.6 es la fiabilidad factual empírica. En aplicaciones empresariales de alto riesgo, llamadas a herramientas robóticas y tuberías operativas automatizadas, la generación de lenguaje estadístico se ha visto históricamente afectada por sutiles alucinaciones: afirmaciones que suenan plausibles pero que no tienen base factual. Las auditorías internas de OpenAI indican que GPT-5.6 Sol reduce estos incidentes en aproximadamente un 68 por ciento cuando se compara con GPT-5.5 Instant en conjuntos de evaluación rigurosos de múltiples dominios.
Esta reducción no es simplemente el subproducto de un corpus de entrenamiento más grande. El salto en el rendimiento proviene del aprendizaje por refuerzo refinado a partir de la retroalimentación del verificador, donde los modelos de evaluación auxiliares califican los pasos de razonamiento intermedios basados en pruebas algorítmicas de verdad fundamental en lugar de la preferencia humana subjetiva. Al castigar los pasos deductivos incorrectos al principio de la fase de generación de tokens ocultos, Sol poda las rutas lógicas corruptas antes de que se propaguen hacia abajo en el texto de respuesta final. El modelo también exhibe una mayor propensión a la refutación activa; en lugar de aceptar pasivamente premisas defectuosas planteadas por el operador, Sol está entrenado para emitir correcciones técnicas cuando los parámetros de referencia entran en conflicto con las realidades físicas o matemáticas empíricas.
Es importante enfatizar que esta implementación de GPT-5.6 Sol está actualmente restringida a la interfaz conversacional nativa de ChatGPT. Las plataformas de trabajo empresariales y los puntos finales programáticos dedicados que gobiernan Codex conservan sus configuraciones de canalización personalizadas para evitar cambios estructurales disruptivos en los entornos existentes de automatización industrial y generación de código. Mantener esta separación asegura que los consumidores de API de misión crítica permanezcan aislados de los ajustes del front-end del consumidor.
Volantes de consumo y la realpolitik de la distribución de cómputo
La razón estratégica detrás de proporcionar acceso gratuito e ilimitado a Luna mientras se refina la economía de inferencia de Sol resalta la realidad competitiva en evolución de la inteligencia artificial. A medida que la mentalidad de los desarrolladores de frontera se ha inclinado fuertemente hacia el desarrollo de software automatizado y la generación de código programático, las plataformas de diálogo de nivel de consumidor siguen siendo el volante de datos definitivo. Al ofrecer interacciones de texto ilimitadas y altamente precisas a mil millones de usuarios, OpenAI captura un flujo sin precedentes de intención humana en tiempo real, retroalimentación correctiva y casos de borde operativos.
Además, ejecutar Luna a escala proporciona pruebas de estrés críticas para el silicio de próxima generación y la infraestructura de refrigeración dentro de los modernos centros de datos de IA. La amortización de estos gastos de capital masivos requiere operaciones de carga base continuas y de alta eficiencia. Destilar parámetros de alto rendimiento en Luna permite al proveedor mantener una saturación óptima del clúster durante las horas de menor actividad, transformando la participación del consumidor en un activo de telemetría operativa.
Para el ecosistema tecnológico más amplio, este despliegue de dos niveles señala una fase de maduración en la computación generativa. La era de los chatbots indiferenciados que compiten puramente por la escala bruta de parámetros está llegando a su fin. En su lugar, surge una era definida por la ingeniería de sistemas: destilación rigurosa para servicios públicos de alto rendimiento y una profundidad de inferencia finamente ajustada y controlada por el operador para la resolución de problemas de misión crítica.




Comments
No comments yet. Be the first!