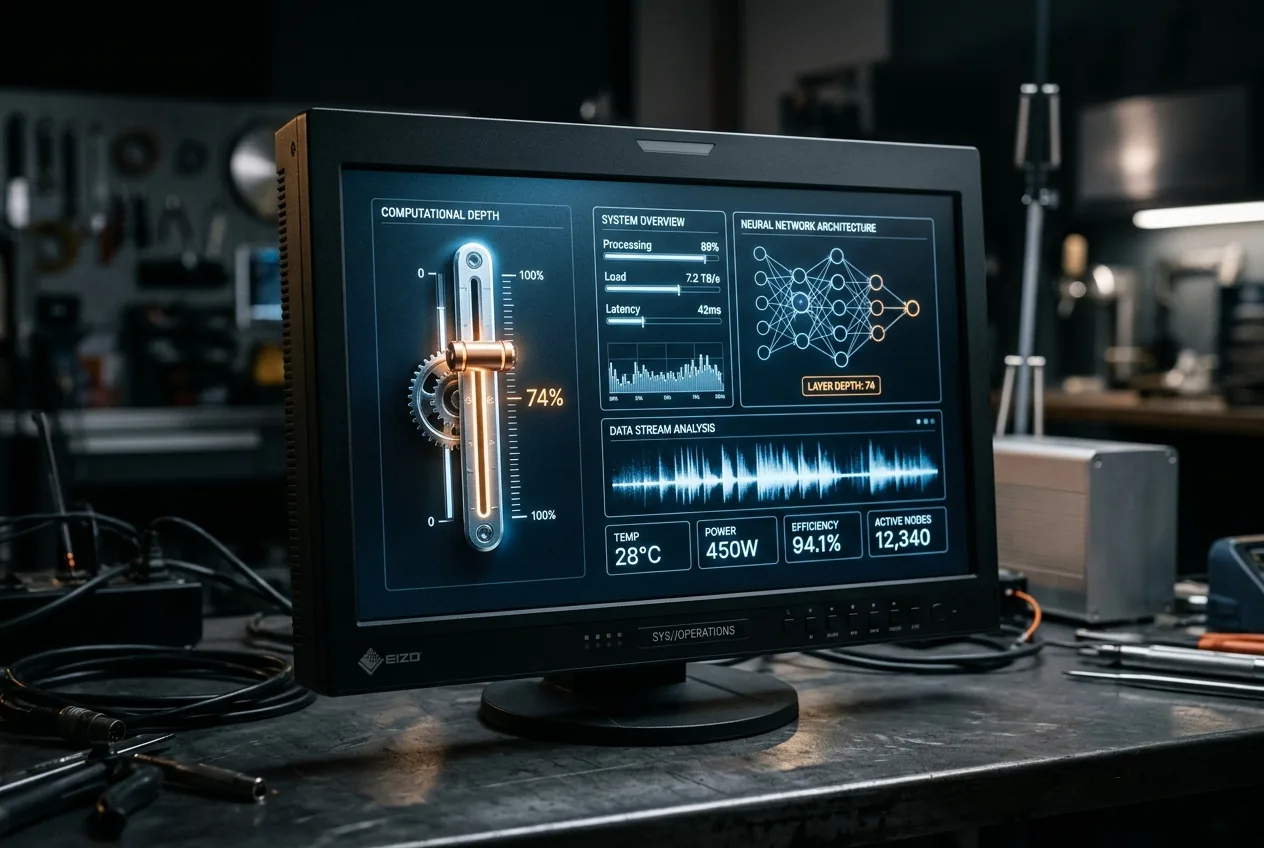
全球数字互动基础设施正在经历一场静悄悄的变革。OpenAI已启动对ChatGPT消费者及专业版架构的全面升级,从根本上重组了其估计每周十亿活跃用户的计算资源分配方式。免费用户已迁移至名为GPT-5.6 Luna的新型优化模型,解锁了无人工限速的无限文本对话体验。与此同时,付费的Plus和Pro用户则接入了GPT-5.6 Sol模型,并配备了一种类物理界面的控制机制,允许操作者直接管控模型的测试时推理计算(test-time reasoning compute)。
此次部署代表了从僵化的离散模型切换向连续的、按需求驱动的推理缩放(inference scaling)这一重大战略转变。多年来,面向消费者的对话式AI迫使用户在初始阶段做出二选一的抉择:将提示词路由至专为简单查询设计的轻量级、低延迟模型,或将其发送至能够进行复杂演绎的高成本多阶段推理引擎。随着GPT-5.6系列的推出,OpenAI正以统一的参数权重和可变的计算分配取代这种碎片化的模式,从根本上改变了消费级人工智能的经济结构。
无限免费访问背后的架构
为数以亿计的用户群提供不受限的无限文本聊天,这主要是硬件和效率方面的挑战,而非数学上的创新。在全球范围内持续生成Token所产生的运营成本,过去一直迫使平台在数据中心负载高峰期间设置人工限速、冷却计时器或强制模型降级。为了消除免费用户的这些障碍,OpenAI开发了GPT-5.6 Luna,这是一款超高效、高度蒸馏的推理引擎,旨在最大化每瓦特的吞吐量。
Luna摒弃了单纯的参数扩张,转而依赖致密的架构剪枝(architectural pruning)、专门的投机解码管线(speculative decoding pipelines)以及跨托管集群高度优化的键值缓存(key-value caching)。虽然Luna完全取消了文本对话上限,但整个系统仍对带宽密集型的多模态工作负载保留了防护措施。文件导入、结构化数据解析和图像生成任务仍受到严格的消费上限限制。然而,对于文本而言,Luna已成为一种持久、低延迟的实用工具层。
为了防止Luna在面对模糊或高度嵌套的提示词时出现偏差,该界面引入了一个专用的处理开关。由于Luna并非庞大的暴力破解型基础模型,该机制允许用户明确命令网络执行二次验证步骤。在金融、医疗和行政法等监管严格领域的内部基准测试中,GPT-5.6 Luna的事实错误率比之前的GPT-5.5 Instant基准降低了62%,这充分说明了在更小的运行空间内可以构建出多么强大的结构稳定性。
测试时推理与“思考滑块”的机制
虽然免费层级受益于激进的模型蒸馏,但付费订阅层级为技术用户引入了一种更细粒度的机制:动态推理滑块(dynamic reasoning slider)。该界面控制借鉴了专业的Codex工程环境,允许Plus和Pro用户直接管控GPT-5.6 Sol内部的搜索深度。用户不再是与一个输出固定Token流的静态黑箱进行交互,而是可以机械地调节在生成可见字符前用于深度思考的计算预算。
在标准的自回归文本模型中,推理成本对于每个输出Token基本是固定的。网络仅基于先前的上下文窗口预测序列中的下一个Token,几乎没有空间来评估替代路径或在过程中纠正错误假设。相比之下,推理架构依赖测试时计算,在幕后生成隐藏的搜索图、自我批判循环和思维链(chain-of-thought)验证路径。新部署的滑块将高层级的用户意图转化为底层级的Token预算,从而动态改变搜索树的分支因子。
- 低位(直接响应):模型抑制隐藏的搜索Token,优先实现程序化语法查询、快速翻译和基本事实检索的快速响应。
- 平衡位(上下文规划):模型启动适度的自我一致性检查,过滤对话噪音,识别隐含的用户目标,并在不产生额外认知延迟的情况下构建复杂的概要。
- 高位(深度推理):系统分配充足的推理预算,探索竞争性的分析路径,进行多轮反事实分析,并在交付合成输出之前对复杂的工程或法律逻辑进行严谨的压力测试。
这种动态调整解决了技术用户长期以来的困扰:认知冗余。此前,先进的推理模型经常对简单的事务性查询进行“过度思考”,将直接的答案包裹在复杂的序言和嵌套的论证中。在新的GPT-5.6 Sol实施方案下,对于“骑行当地大气变量”的询问,模型不再会不加区分地列出气压和降水指标。模型会评估功能目标,将风切变和对流速度视为主要性能约束,并抑制不相关的变量,从而提供可操作的、针对任务的评估结果。
生产环境中的幻觉抑制
除了人体工程学的改进外,5.6版本的主要性能指标是实证事实的可靠性。在高风险的企业应用、机器人工具调用和自动化运营管线中,统计语言模型过去一直受到微妙“幻觉”的困扰——即听起来合情合理但毫无事实根据的断言。OpenAI的内部审计显示,与GPT-5.5 Instant在严格的多领域评估集上的表现相比,GPT-5.6 Sol将此类事件减少了约68%。
这种减少不仅仅是更大训练语料库的副产品。性能的飞跃源于改进的“来自验证者反馈的强化学习”(reinforcement learning from verifier feedback),即辅助评估模型根据真实算法证明而非主观人类偏好,对中间推理步骤进行评分。通过在隐藏Token生成阶段早期惩罚错误的演绎步骤,Sol在逻辑路径传播到最终响应文本之前就将其截断。该模型还表现出更强的积极反驳倾向;与被动接受操作者提出的错误前提不同,当基准参数与物理或数学事实相冲突时,Sol被训练为发出技术修正。
需要强调的是,目前GPT-5.6 Sol的这种实现仅限于原生的ChatGPT对话界面。企业级Work平台和管理Codex的专用程序化端点保留了其定制的管线配置,以防止工业自动化和代码生成环境中的结构性破坏。保持这种分离确保了关键任务的API用户免受前端消费者调整的影响。
消费者飞轮与计算分配的现实政治
在提供免费、无限的Luna访问权限同时优化Sol推理经济性的战略背后,突显了人工智能不断演变的竞争现实。随着前沿开发者的关注重点明显转向自动化软件开发和程序化代码生成,消费级对话平台依然是终极的数据飞轮。通过为十亿用户提供无限、高精度的文本互动,OpenAI捕获了前所未有的实时人类意图、纠正性反馈和运营极端案例流。
此外,大规模运行Luna为现代AI数据中心内的新一代芯片和冷却基础设施提供了关键的压力测试。分摊这些巨额资本支出需要持续、高效率的基荷运营。将高性能参数蒸馏至Luna,使提供商能够在非高峰时段保持集群的最佳饱和度,将消费者参与度转化为运营遥测资产。
对于更广泛的技术生态系统而言,这种双层部署标志着生成式计算进入了成熟期。那种仅仅在原始参数规模上进行竞争的同质化聊天机器人时代即将结束。取而代之的是一个由系统工程定义的新时代:针对高吞吐量公共设施的严谨蒸馏,以及针对关键任务问题解决的、由操作员控制的精细化推理深度。




Comments
No comments yet. Be the first!