在一个推理计算历史上决定了硬性速率限制和计量访问的生态系统中,消费级人工智能的运行机制正在经历根本性的重构。OpenAI 已经取消了长期以来针对免费层用户的文本聊天限制,并在消费端和企业端接口全面部署其 GPT-5.6 模型家族。此次部署引入了两个截然不同的系统层级:GPT-5.6 Luna,这是一个专为高吞吐量公共部署而设计的精简模型;以及 GPT-5.6 Sol,这是一个专为付费订阅用户设计的统一推理引擎。
这种结构性变革意义重大。免费层用户——OpenAI 目前估计这一群体每周活跃用户约为十亿人——将迁移至 GPT-5.6 Luna,摆脱了此前限制长篇对话的强制速率配额。与此同时,付费的 Plus 和 Pro 层级正在从单独的对话引擎和推理引擎转向单一的统一流水线。通过将即时生成与思维链推理整合进一个动态可扩展的系统中,此次发布展示了测试时计算扩展(test-time compute scaling)和架构蒸馏技术的进步,是如何重塑全球规模大语言模型服务经济学的。
取消推理限制的经济学
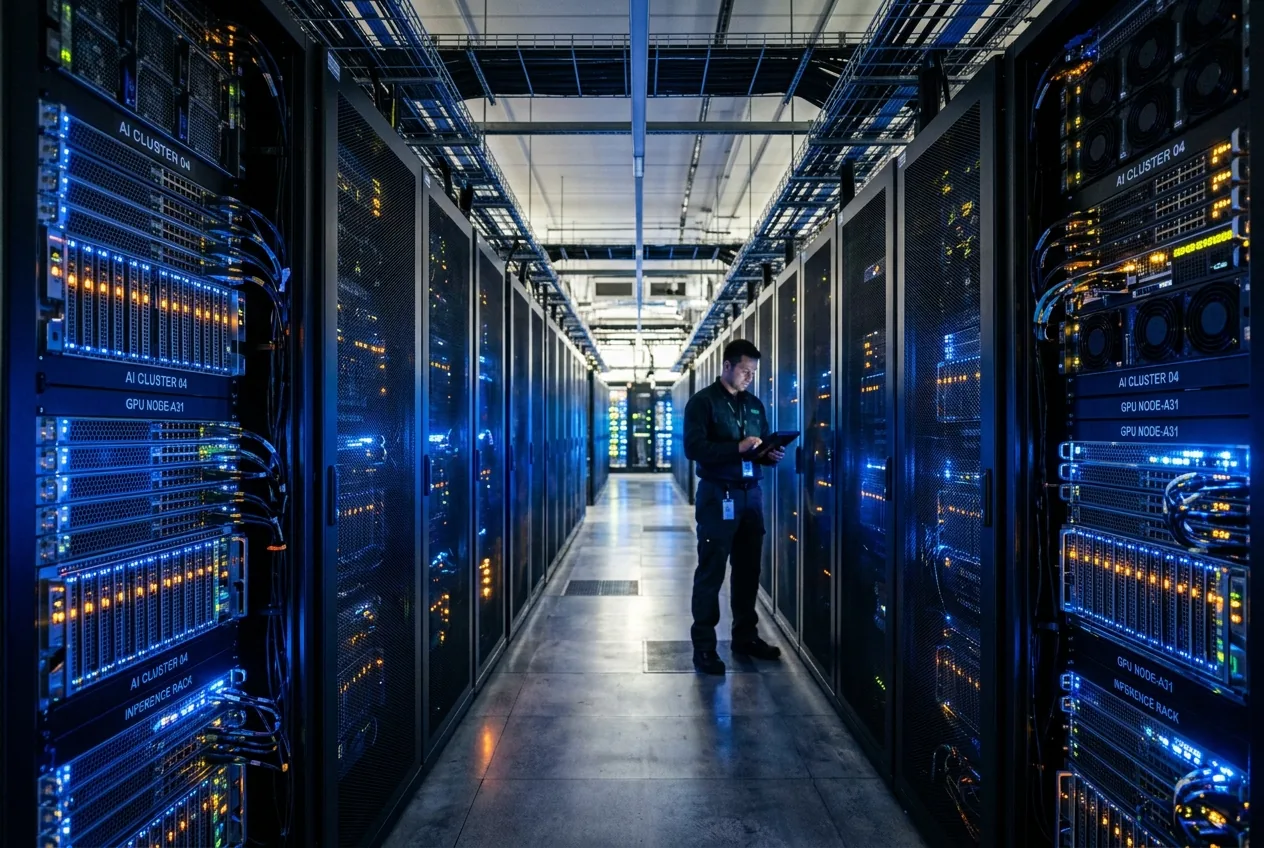
对于数据中心运营商和机器学习基础设施工程师而言,为十亿周活跃用户基数取消速率限制不仅仅是一个产品决策,更是一项巨大的后勤挑战。以如此量级生成 token 需要天文数字般的每秒浮点运算次数(FLOPs)。在此次发布之前,严格的使用限流机制充当了负载削减机制,在高需求窗口期间保护底层 GPU 和加速器集群免受峰值并发冲击。
至关重要的是,运营边界仍然保持严格的划分。尽管基础的字母数字对话带宽现在已无限制,但 OpenAI 仍对资源密集型模态保持了严格的速率限制。包括图像合成、文件摄取、自动化代码执行和实时双向语音流在内的高开销功能,仍然受到配额和订阅墙的限制。从基础设施的角度来看,这在利用高度优化的矩阵乘法器进行基础文本生成的同时,也为高利润业务保留了宝贵的高带宽内存和异构计算资源。
将深度思考与速度融合进 GPT-5.6 Sol
虽然 Luna 解决了公共消费层级的体量需求,但 GPT-5.6 Sol 在高参数系统处理推理任务的方式上引入了关键的技术转变。历史上,前沿人工智能平台要求用户手动选择其操作范式:用于快速、低延迟对话的优化“即时”模型,或者在输出最终答案前花费更长处理周期来综合逐步推理过程的专用“推理”引擎。
Sol 将这种操作二分法合并为单一模型。Sol 不再需要并行模型检查点或在不同的神经网络权重间路由请求,而是将可变测试时计算直接纳入其内部解码策略。这种统一架构允许模型根据任务复杂性或用户明确的指引来调整其潜在处理深度。用户现在可以操作集成的推理滑块来动态调整计算分配,为日常草稿部署浅层的 token 探索,而为复杂的逻辑综合、财务取证或软件架构部署深入的、迭代式的自我修正路径。
这种整合在企业工作流中产生了显著的效率优势。在复杂的多轮交互中,在不同的推理模型和即时模型之间维护单独的上下文缓存会引入显著的延迟惩罚和内存碎片。通过利用能够按需调节自身计算预算的单一权重集,上下文状态可以持久保留在键值(KV)缓存中,最大限度地减少了重新计算开销和系统级的上下文切换。
高风险领域可靠性的基准测试
历史上,激进的蒸馏和模型剪枝带来了一个不受欢迎的副作用:事实性退化和幻觉率升高。由于对话模型倾向于优化下一个最可能的 token,而非验证外部现实,降低计算占用往往会加剧认知上的不可靠性。随 GPT-5.6 一起发布的内部基准测试数据表明,OpenAI 通过改进对齐和结构化推理验证,直接解决了这一弱点。
在涵盖医学、财务合规和法律法规解释的严格评估套件中,GPT-5.6 家族表现出了显著的事实一致性提升。在与 GPT-5.5 Instant 的对比测试中,GPT-5.6 Sol 将事实错误率降低了 68%,而轻量级的 Luna 架构则记录了 62% 的不准确输出减少。这些降低反映了更严格的来自人类和自动化反馈的强化学习(RLHF/RLAIF),以及在 token 输出前评估中间推导步骤的自动化检查程序。
企业系统与公共系统之间的战略分歧
GPT-5.6 的战略部署也揭示了 OpenAI 日益分化的开发路线图。虽然 Luna 和 Sol 在 Web、桌面和移动端的跨平台消费环境中推出,但 OpenAI 明确表示,企业环境——特别是 ChatGPT Work 和 Codex——将在与此次即时消费者更新脱钩的隔离维护线路下运行。
这种分化突显了治理消费平台与高保证工业工具链之间截然不同的工程约束。在企业软件开发和工业自动化中,确定性行为、不可变的 API 合约和持续的延迟至关重要。引入带有动态推理滑块的架构修订可能会无意中破坏自动化流水线、持续集成(CI)测试套件和严格的服务等级协议(SLA)。相反,消费界面则能立即从自适应延迟和众包压力测试中获益。
测试时扩展的长期轨迹
GPT-5.6 代际的到来标志着整个行业正在从单纯的预训练扩展定律向推理时计算优化转型。随着物理数据中心规模面临热、电和制造工艺的约束,仅仅增加单体模型的参数数量所带来的边际效用正在递减。性能提升的主要杠杆已经转向了推理阶段计算周期的智能分配。
随着这些模型在日常消费硬件和工业工作流中的普及,技术焦点转向了完善管理它们的运行时控制系统。在动态延迟与事实严谨性之间取得平衡,仍然是当前生成式人工智能时代的核心运营挑战。随着 GPT-5.6 的出现,行业得以窥见一个运营未来的雏形:系统不再仅仅以恒定速率输出预测,而是有意识地调节其自身的认知延迟,以匹配手头任务的工程复杂性。




Comments
No comments yet. Be the first!