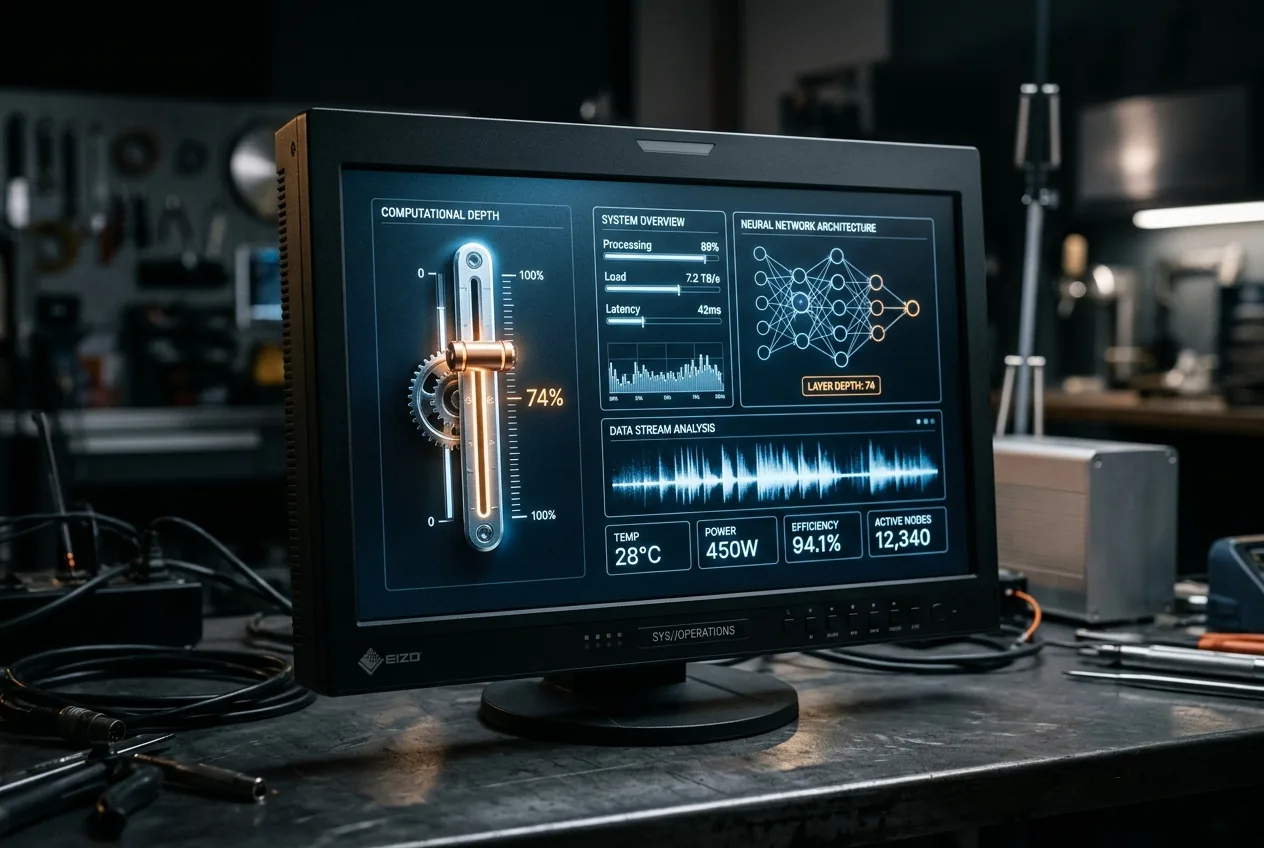
Eine stille Transformation vollzieht sich in der Infrastruktur, die die globale digitale Interaktion antreibt. OpenAI hat eine umfassende Überarbeitung der Architektur sowohl für die Endverbraucher- als auch für die professionellen Ebenen von ChatGPT eingeleitet und grundlegend neu ausgerichtet, wie die Rechenleistung auf die geschätzt eine Milliarde wöchentlich aktiven Nutzer verteilt wird. Kostenlose Nutzer wurden auf ein neu optimiertes Modell namens GPT-5.6 Luna migriert, das unbegrenzte Textkonversationen ohne künstliche Drosselung ermöglicht. Gleichzeitig erhalten die kostenpflichtigen Plus- und Pro-Stufen GPT-5.6 Sol, gepaart mit einer physisch anmutenden Schnittstelle, die es Anwendern ermöglicht, die Rechenleistung für das schlussfolgernde Denken des Modells zur Laufzeit direkt zu steuern.
Diese Bereitstellung stellt einen bedeutenden strategischen Schwenk von starrem, diskretem Modellwechsel hin zu kontinuierlicher, nachfrageorientierter Skalierung der Inferenz dar. Jahrelang zwang verbraucherorientierte KI Nutzer zu einer binären Entscheidung im Voraus: einen Prompt an ein leichtgewichtiges Modell mit geringer Latenz zu senden, das für einfache Anfragen ausgelegt ist, oder ihn an eine teure, mehrstufige Reasoning-Engine für komplexe Deduktionen weiterzuleiten. Mit der Einführung der GPT-5.6-Familie ersetzt OpenAI diesen fragmentierten Ansatz durch einheitliche Parametergewichte und variable Rechenleistungszuweisungen, was die Ökonomie der verbraucherorientierten künstlichen Intelligenz grundlegend verändert.
Die Architektur hinter dem unbegrenzten kostenlosen Zugang
Die Bereitstellung uneingeschränkter, unbegrenzter Text-Chats für eine Nutzerbasis von hunderten Millionen ist in erster Linie eine Herausforderung für Hardware und Effizienz und weniger eine mathematische Neuheit. Die Betriebskosten für die kontinuierliche Token-Generierung im globalen Maßstab erforderten bisher künstliche Ratenbegrenzungen, Abklingzeiten oder erzwungene Modell-Downgrades bei Spitzenlast in den Rechenzentren. Um diese Barrieren für kostenlose Nutzer zu beseitigen, hat OpenAI GPT-5.6 Luna als eine extrem effiziente, hochgradig destillierte Inferenz-Engine entwickelt, die explizit darauf ausgelegt ist, den Durchsatz pro Watt zu maximieren.
Luna verzichtet auf reine Parametererweiterung und setzt stattdessen auf dichtes architektonisches Pruning, spezialisierte spekulative Decoding-Pipelines und stark optimiertes Key-Value-Caching im gesamten Hosting-Cluster. Während Luna die Textkonversations-Limits vollständig aufhebt, behält das Gesamtsystem Leitplanken für bandbreitenintensive multimodale Workloads bei. Dateieinbindungen, die Analyse strukturierter Daten und Routinen zur Bilderzeugung unterliegen weiterhin strengen Nutzungsgrenzen. Für Text fungiert Luna jedoch als dauerhafte Utility-Schicht mit geringer Latenz.
Um zu verhindern, dass Luna bei mehrdeutigen oder stark verschachtelten Prompts ins Stocken gerät, führt die Schnittstelle einen dedizierten Verarbeitungs-Toggle ein. Da Luna kein expansives Brute-Force-Foundation-Modell ist, erlaubt dieser Mechanismus dem Nutzer, das Netzwerk explizit anzuweisen, sekundäre Verifizierungsschritte durchzuführen. In internen Benchmarks, die in stark regulierten Bereichen wie Finanzen, Gesundheitswesen und Verwaltungsrecht evaluiert wurden, zeigte GPT-5.6 Luna eine 62-prozentige Reduzierung der faktischen Fehlerraten im Vergleich zum bisherigen GPT-5.5 Instant-Baseline-Modell, was verdeutlicht, wie viel strukturelle Stabilität in einen kleineren Laufzeit-Footprint eingebaut werden kann.
Die Mechanik der Inferenz zur Testzeit und der Thinking-Slider
Während die kostenlose Stufe von rücksichtsloser Modell-Destillation profitiert, führt die kostenpflichtige Abonnement-Stufe einen granulareren Mechanismus für technische Anwender ein: den dynamischen Reasoning-Slider. Dieser Steuerelement, das aus der spezialisierten Codex-Entwicklungsumgebung übernommen wurde, gewährt Plus- und Pro-Nutzern die direkte Kontrolle über die interne Suchtiefe von GPT-5.6 Sol. Anstatt mit dem Modell als statische Blackbox zu interagieren, die einen unveränderlichen Token-Strom ausgibt, können Nutzer das Rechenbudget, das für das Überlegen vor der Generierung eines einzigen sichtbaren Zeichens zugewiesen wird, mechanisch skalieren.
Bei Standard-autoregressiven Textmodellen sind die Inferenzkosten pro ausgegebenem Token im Wesentlichen fix. Das Netzwerk sagt das nächste Token in der Sequenz ausschließlich basierend auf dem vorherigen Kontextfenster voraus, was nur minimalen Raum bietet, um alternative Pfade zu evaluieren oder fehlerhafte Annahmen mitten im Prozess zu korrigieren. Im Gegensatz dazu basieren Reasoning-Architekturen auf Rechenleistung zur Laufzeit, die im Hintergrund verborgene Suchgraphen, Selbstkritik-Schleifen und Verifizierungspfade der Gedankenketten generiert. Der neu eingeführte Slider übersetzt die Absicht des Nutzers in Token-Budgets auf niedriger Ebene und verändert den Verzweigungsfaktor des Suchbaums dynamisch.
- Niedrige Position (Direkte Antwort): Das Modell unterdrückt verborgene Such-Token und priorisiert schnelle Time-to-First-Token-Antworten für programmatische Syntax-Abfragen, schnelle Übersetzungen und grundlegende Faktenabrufe.
- Ausbalancierte Position (Kontextuelle Planung): Das Modell initiiert moderate Selbstkonsistenzprüfungen, filtert Konversationsrauschen heraus, identifiziert implizite Nutzerziele und strukturiert komplexe Entwürfe ohne unnötige kognitive Latenz.
- Hohe Position (Tiefe Inferenz): Das System weist ein expansives Reasoning-Budget zu, erkundet konkurrierende analytische Pfade, führt kontrafaktische Analysen in mehreren Durchläufen durch und unterzieht komplexe technische oder rechtliche Logik rigorosen Belastungstests, bevor eine synthetisierte Ausgabe geliefert wird.
Diese dynamische Anpassung löst einen hartnäckigen Frust bei technischen Nutzern: kognitive Überladung. Zuvor überdachten fortschrittliche Reasoning-Modelle einfache transaktionale Anfragen häufig und verpackten direkte Antworten in komplizierte Einleitungen und verschachtelte Begründungen. Unter der neuen GPT-5.6 Sol-Implementierung liefert eine Anfrage zu lokalen atmosphärischen Variablen für das Radfahren keine wahllose Ansammlung von Luftdruck- und Niederschlagsdaten mehr. Das Modell evaluiert das funktionale Ziel, isoliert Windscherung und konvektive Geschwindigkeit als primäre Leistungseinschränkungen und unterdrückt irrelevante Variablen, um eine umsetzbare, missionsspezifische Einschätzung zu liefern.
Bekämpfung des Halluzinationsdefizits in der Produktion
Jenseits ergonomischer Verbesserungen ist das primäre Leistungsmerkmal der 5.6-Generation die empirische faktische Zuverlässigkeit. Bei geschäftskritischen Unternehmensanwendungen, robotischen Tool-Aufrufen und automatisierten operativen Pipelines wurde die statistische Sprachgenerierung in der Vergangenheit durch subtile Halluzinationen beeinträchtigt – plausibel klingende Behauptungen ohne faktische Grundlage. Interne Audits von OpenAI zeigen, dass GPT-5.6 Sol diese Vorfälle um etwa 68 Prozent reduziert, wenn es im Vergleich zu GPT-5.5 Instant über rigorose Multi-Domain-Evaluierungssets hinweg gemessen wird.
Diese Reduzierung ist nicht bloß das Nebenprodukt eines größeren Trainingskorpus. Der Leistungssprung resultiert aus verfeinertem Reinforcement Learning aus Verifier-Feedback, bei dem zusätzliche Evaluierungsmodelle Zwischenschritte des Denkens auf der Grundlage von Ground-Truth-algorithmischen Beweisen bewerten, anstatt auf subjektiven menschlichen Präferenzen. Durch die Bestrafung inkorrekter deduktiver Schritte früh in der Phase der verborgenen Token-Generierung bereinigt Sol korrupte logische Pfade, bevor sie sich nachgelagert im endgültigen Antworttext verbreiten. Das Modell zeigt auch eine gesteigerte Neigung zur aktiven Widerlegung; anstatt fehlerhafte Prämissen des Anwenders passiv zu akzeptieren, ist Sol darauf trainiert, technische Korrekturen auszugeben, wenn Baseline-Parameter mit empirischen physikalischen oder mathematischen Realitäten in Konflikt stehen.
Es ist wichtig zu betonen, dass diese Implementierung von GPT-5.6 Sol derzeit auf die native ChatGPT-Konversationsschnittstelle beschränkt ist. Die Work-Plattformen für Unternehmen und dedizierte programmatische Endpunkte, die Codex steuern, behalten ihre maßgeschneiderten Pipeline-Konfigurationen bei, um strukturelle Änderungen in bestehenden industriellen Automatisierungs- und Codegenerierungsumgebungen zu vermeiden. Die Aufrechterhaltung dieser Trennung stellt sicher, dass missionskritische API-Nutzer von Front-End-Anpassungen für Konsumenten isoliert bleiben.
Consumer Flywheels und die Realpolitik der Rechenleistungsverteilung
Die strategische Logik hinter der Bereitstellung eines kostenlosen, unbegrenzten Zugangs zu Luna bei gleichzeitiger Verfeinerung der Inferenz-Ökonomie von Sol unterstreicht die sich entwickelnde Wettbewerbsrealität der künstlichen Intelligenz. Während sich der Fokus der Entwickler stark in Richtung automatisierter Softwareentwicklung und programmatischer Codegenerierung verschoben hat, bleiben Dialogplattformen für Endverbraucher das ultimative Daten-Flywheel. Indem OpenAI eine Milliarde Nutzern unbegrenzte, hochpräzise Textinteraktionen anbietet, erfasst es einen beispiellosen Strom an menschlicher Absicht in Echtzeit, korrigierendem Feedback und operativen Randfällen.
Darüber hinaus bietet der Betrieb von Luna im großen Maßstab kritische Belastungstests für Silizium- und Kühlungsinfrastrukturen der nächsten Generation in modernen KI-Rechenzentren. Die Amortisierung dieser massiven Investitionsausgaben erfordert kontinuierliche, hocheffiziente Grundlastbetriebe. Die Destillation leistungsstarker Parameter in Luna ermöglicht es dem Anbieter, eine optimale Cluster-Sättigung während der Nebenzeiten aufrechtzuerhalten und das Nutzerengagement in einen operativen Telemetrie-Vermögenswert zu verwandeln.
Für das breitere Technologie-Ökosystem signalisiert dieser zweistufige Einsatz eine Reifephase im generativen Computing. Die Ära der undifferenzierten Chatbots, die rein über die rohe Parameterskala konkurrieren, neigt sich dem Ende zu. An ihre Stelle tritt eine Ära, die durch Systemtechnik definiert ist: rigorose Destillation für hochdurchsatzstarke öffentliche Versorgungsleistungen und fein abgestimmte, vom Anwender steuerbare Inferenz-Tiefe für missionskritische Problemlösungen.




Kommentare
Noch keine Kommentare. Seien Sie der Erste!