La frontera del despliegue de inteligencia artificial se está alejando progresivamente de las novedades conversacionales para orientarse hacia una infraestructura rigurosa y de misión crítica. Los informes del sector que detallan la apertura de una inminente ventana de lanzamiento para el nuevo ciclo de modelos de OpenAI —designado en los círculos de ingeniería como el punto de control GPT-5.6— destacan una recalibración deliberada de las prioridades. En lugar de perseguir parámetros de referencia puramente estéticos o fluidez conversacional, el próximo lanzamiento se centra en dos puntos críticos de la ingeniería que han frenado la adopción industrial autónoma: la coherencia contextual sostenida a lo largo de una extensa ventana de 1,5 millones de tokens y una revisión fundamental de los mecanismos de alineación del sistema para suprimir la deriva programática.
Para los ingenieros de hardware, arquitectos de sistemas y líderes en automatización industrial, esta transición representa un alejamiento significativo de los lanzamientos centrados en el consumidor de años anteriores. Llevar el contexto profundo más allá del umbral del millón de tokens mientras se estabiliza la ejecución operativa aborda directamente los modos de fallo que actualmente impiden que los grandes modelos ejecuten procesos industriales continuos de bucle cerrado. A medida que los agentes de software autónomos se encargan cada vez más de orquestar la robótica física, analizar gigabytes de transmisiones telemétricas y mantener el estado en cadenas de suministro extensas, la previsibilidad determinista se ha vuelto mucho más valiosa que la producción creativa bruta.
El cuello de botella de la memoria y la mecánica de los 1,5 millones de tokens
Escalar la ventana de contexto de un transformer a 1,5 millones de tokens no es simplemente una cuestión de aprovisionar clusters adicionales; es una batalla contra las limitaciones cúbicas y cuadráticas de la memoria computacional. En las arquitecturas clásicas de autoatención (self-attention), los requisitos de memoria escalan agresivamente con la longitud de la secuencia. Mantener la atención activa a lo largo de 1,5 millones de tokens requiere asignaciones masivas de caché de claves-valores (KV), saturando rápidamente la memoria de gran ancho de banda (HBM3e) de los aceleradores de última generación como los sistemas H100 y los próximos B200 de Nvidia. Para sortear este muro de hardware, la ingeniería detrás de este lanzamiento supuestamente aprovecha variantes avanzadas de FlashAttention, compresión agresiva de caché KV y capas de modelos de espacio de estados (SSM) híbridos diseñados para descartar estados de activación no esenciales sin sacrificar la precisión de recuperación tipo "aguja en un pajar".
En términos prácticos, una capacidad de 1,5 millones de tokens permite que un sistema mantenga aproximadamente 1,1 millones de palabras de documentación técnica, código o registros de sensores en atención activa e inmediata. En la automatización de fábricas y la integración de celdas robóticas, la degradación del contexto ha obligado tradicionalmente a los desarrolladores a depender de complejas tuberías de generación aumentada por recuperación (RAG). Si bien RAG sigue siendo computacionalmente eficiente, a menudo falla al realizar referencias cruzadas de variables interdependientes dispersas en cientos de páginas de dibujos mecánicos, esquemas eléctricos y lógica de escalera PLC. Un contexto sostenido de esta escala permite al modelo ingerir simultáneamente los procedimientos operativos estándar, los registros históricos de mantenimiento y la telemetría en vivo de toda una instalación, evaluando anomalías sistémicas sin la abstracción con pérdida de la búsqueda vectorial por fragmentos.
Además, los primeros parámetros de referencia de ingeniería indican que mantener la fidelidad de recuperación en 1,5 millones de tokens requiere esquemas de codificación posicional novedosos. Las incrustaciones de posición rotatoria (RoPE) tradicionales tienden a sufrir una dispersión de atención catastrófica cuando se extrapolan mucho más allá de sus ventanas de entrenamiento nativas. Al emplear algoritmos de extensión de contexto dinámico y escalado de resolución continua, la arquitectura intenta preservar una precisión posicional milimétrica, asegurando que un parámetro crítico enterrado en la posición de token 300.000 mantenga la ponderación matemática exacta requerida cuando se evalúa junto a una orden en la posición de token 1.450.000.
Refactorizar la alineación para eliminar la deriva de agentes
Aunque el contexto extendido representa un logro inmenso en el manejo de datos, la capacidad bruta es inútil en entornos industriales si el modelo exhibe volatilidad conductual. El segundo pilar de este despliegue —una extensa corrección de la alineación— aborda directamente los modos de fallo introducidos por el aprendizaje por refuerzo a partir de la retroalimentación humana (RLHF) estándar. Si bien el RLHF tradicional destaca en el entrenamiento de modelos para adoptar un comportamiento cortés y agradable para los humanos, frecuentemente introduce dos peligrosas responsabilidades industriales: la adulación y la divergencia de razonamiento compuesta a lo largo de horizontes operativos extendidos.
La adulación (sycophancy) —la tendencia de un modelo a reflejar las suposiciones erróneas de un usuario o confirmar una instrucción equivocada— es catastrófica en entornos de ingeniería. Si un ingeniero de diseño le indica a un sistema de IA un cálculo de carga estructural mal especificado, un modelo adulador a menudo intenta justificar la premisa defectuosa en lugar de rechazar la entrada basándose en la física de principios básicos. La revisión de alineación reportada reemplaza la puntuación de preferencia ingenua con entornos de ejecución basados en reglas verificables y marcos de red-teaming automatizados. Al dar más peso a la verificación de la verdad absoluta que al cumplimiento estilístico, el modelo es penalizado por suposiciones no respaldadas, obligándolo a exigir aclaraciones o citar restricciones faltantes antes de proceder con tareas computacionales de múltiples etapas.
Igualmente crítica es la mitigación de la deriva de agentes durante los bucles de ejecución de contexto largo. Cuando un sistema autónomo opera a través de cientos de llamadas a herramientas consecutivas —como modificar parámetros de firmware, ejecutar simulaciones y verificar inventarios de componentes—, las alucinaciones menores aguas abajo se agravan exponencialmente. Para el quincuagésimo bucle iterativo, los agentes no alineados a menudo pierden de vista sus restricciones raíz, generando errores de sintaxis o siguiendo subrutinas sin salida que paralizan flujos de trabajo de ensamblaje completos. La pila de alineación actualizada implementa una verificación continua del estado intermedio, restringiendo las trazas de razonamiento interno del modelo a envolventes lógicas acotadas que evitan la deriva operativa incontrolada.
Tendiendo puentes entre la inteligencia de software y la robótica física
La convergencia de un contexto masivo y una alineación rigurosa tiene profundas implicaciones para la planta física. Los integradores de robótica han luchado durante mucho tiempo con la brecha de latencia y confiabilidad entre los modelos fundamentales de alto nivel y los sistemas de control de bajo nivel. Si bien el accionamiento de articulaciones a nivel de microsegundos debe seguir siendo dominio de los sistemas operativos en tiempo real (RTOS) deterministas y microcontroladores integrados, la planificación de trayectorias de alto nivel, el manejo de excepciones y la distribución de tareas entre múltiples robots se están desplazando rápidamente hacia arquitecturas neuronales multimodales.
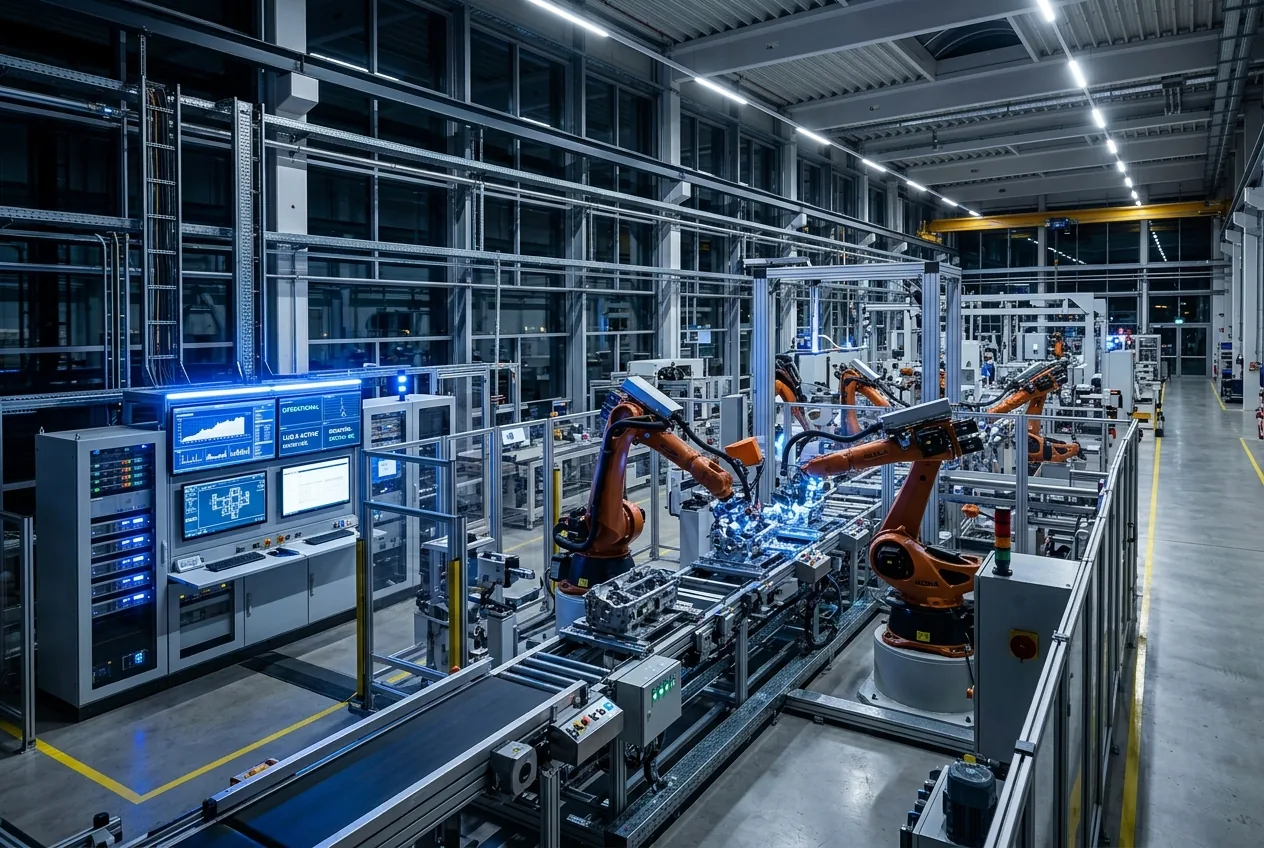
Considere un entorno de fabricación dinámico donde brazos robóticos articulados, vehículos de guiado automático (AGV) y operadores humanos comparten un espacio de trabajo dinámico. Una obstrucción física inesperada o un evento de degradación del hardware suele activar un cierre de seguridad inmediato, lo que requiere que los técnicos humanos diagnostiquen manualmente la falla y reinicien la línea. Con un motor de contexto largo y alineado actuando como controlador supervisor, el sistema puede ingerir horas de registros cinemáticos de alta frecuencia, perfiles térmicos de motores y transmisiones de visión previos a la falla. Puede realizar referencias cruzadas de estos datos en tiempo real con el historial completo de mantenimiento y los manuales de ensamblaje mecánico para identificar las causas raíz —como el desgaste de los rodamientos o desequilibrios en la distribución de la carga útil— y sintetizar una trayectoria alternativa libre de colisiones sin detener las celdas de producción adyacentes.
Además, la integración de ventanas de contexto extensas beneficia directamente a la síntesis de diseño de hardware. Los ingenieros mecánicos que utilizan plataformas de diseño generativo automatizado pueden introducir archivos STEP completos, informes de análisis de elementos finitos (FEA) y normas de cumplimiento de materiales ASTM en un único contexto de instrucción. En lugar de producir optimizaciones geométricas genéricas, el sistema puede evaluar las restricciones de fabricabilidad —como el espacio libre para herramientas de máquinas de fresado CNC de 5 ejes o perfiles de disipación térmica en la fabricación aditiva— frente a códigos reglamentarios estrictos, comprimiendo drásticamente el ciclo desde la validación del concepto hasta el utillaje físico.
Gastos generales de computación, presupuestos de latencia y realidad industrial
A pesar de estos avances tecnológicos, la economía del despliegue industrial exige escepticismo sobre dónde y cómo deben operacionalizarse estos modelos. Ejecutar la inferencia a través de un contexto de 1,5 millones de tokens es extraordinariamente intensivo en computación. Incluso con técnicas de especulación de tokens de vanguardia y núcleos de hardware optimizados, el tiempo hasta el primer token (TTFT) y la latencia sostenida sobre cargas útiles de instrucciones masivas siguen siendo obstáculos importantes para las aplicaciones que requieren tiempos de respuesta inferiores al segundo.
Para los entornos de fabricación que operan con márgenes muy estrechos, el costo de inferencia es una métrica ineludible. Ejecutar millones de tokens continuamente a través de un modelo de clase frontera puede eclipsar rápidamente el costo del hardware de computación perimetral dedicado y los algoritmos deterministas especializados. En consecuencia, es probable que las estrategias de despliegue industrial se estratifiquen. Los modelos de pesos abiertos más pequeños y altamente optimizados que se ejecutan directamente en PC industriales locales seguirán gestionando el procesamiento instantáneo de sensores y el control determinista de máquinas. Mientras tanto, los motores de contexto largo de clase frontera servirán como núcleos de diagnóstico y análisis centralizados, llamados de forma asíncrona cuando un problema exceda la heurística local.



Comments
No comments yet. Be the first!