人工智能部署的前沿领域正稳步脱离对话式的新奇应用,转向严苛的任务关键型基础设施。行业报告详述了 OpenAI 最新模型周期即将开启的发布窗口——在工程界被定为 GPT-5.6 检查点——凸显了其优先级的审慎重构。此次发布不再单纯追求美学基准或对话流畅度,而是聚焦于阻碍自主工业应用普及的两大工程痛点:在 150 万 token 的超长窗口内保持持续的上下文连贯性,以及对系统对齐机制进行彻底的全面革新,以抑制程序性的偏离。
对于硬件工程师、系统架构师和工业自动化负责人而言,这种转变标志着与过去几年消费级产品发布的一次重要分野。将深度上下文突破 100 万 token 的阈值并稳定其操作执行,直接解决了当前大型模型无法运行连续闭环工业流程的失效模式。随着自主软件代理(Autonomous Software Agents)日益承担起调度物理机器人、解析千兆字节遥测数据流以及维护跨庞大供应链状态的任务,确定性的可预测性已远比单纯的创造性输出更有价值。
内存瓶颈与 150 万 token 的机制
将 Transformer 的上下文窗口扩展至 150 万 token,绝非仅仅增加集群部署那么简单,这是一场针对计算内存立方级和二次方约束的战斗。在经典的自注意力架构中,内存需求会随序列长度剧增。在 150 万 token 上保持活跃注意力需要大规模的键值(KV)缓存分配,这将迅速填满 Nvidia H100 及即将推出的 B200 系统等尖端加速器的高带宽内存(HBM3e)。据报道,为了绕过这一硬件壁垒,该发布背后的工程设计利用了 FlashAttention 的高级变体、激进的 KV 缓存压缩,以及混合状态空间模型(SSM)层,旨在在不牺牲“大海捞针”式检索准确性的前提下丢弃非必要的激活状态。
在实际应用中,150 万 token 的容量允许系统将约 110 万字的技术文档、代码或传感器日志保存在直接的活跃注意力中。在工厂自动化和机器人单元集成中,上下文衰减传统上迫使开发人员依赖复杂的检索增强生成(RAG)流水线。虽然 RAG 在计算上保持了高效,但当需要交叉引用散布在数百页机械图纸、电气原理图和 PLC 梯形图逻辑中相互依赖的变量时,它经常失效。如此规模的持续上下文使模型能够同时摄取整个工厂的操作标准作业程序、历史维护日志和实时遥测数据,从而评估系统性异常,而无需分块向量搜索带来的有损抽象。
此外,早期的工程基准测试表明,在 150 万 token 下保持检索保真度需要新颖的位置编码方案。传统的旋转位置嵌入(RoPE)在超出原生训练窗口进行外推时,往往会遭受灾难性的注意力分散。通过采用动态上下文扩展算法和连续分辨率缩放,该架构试图保持精确的位置准确性,确保隐藏在第 30 万个 token 位置的关键参数,在与第 145 万个 token 位置的指令进行评估时,仍能保持所需的精确数学权重。
重构对齐以消除代理偏离(Agentic Drift)
虽然扩展上下文代表了数据处理方面的巨大成就,但如果模型表现出行为波动,那么原始容量在工业环境中将毫无用处。此次推出的第二个支柱——广泛的对齐修复——直接针对了由标准人类反馈强化学习(RLHF)引入的失效模式。虽然传统的 RLHF 在训练模型采用礼貌、讨好人类的态度方面表现出色,但它往往会引入两个危险的工业责任:谄媚倾向(Sycophancy)以及在长运营周期内累积的推理发散。
谄媚倾向——即模型迎合用户错误假设或确认错误提示的倾向——在工程环境中是灾难性的。如果设计工程师向 AI 系统提示了一个定义不明确的结构载荷计算,谄媚的模型往往会试图证明这个错误的前提,而不是基于第一性物理原则拒绝输入。据报道,此次对齐重构用可验证的、基于规则的执行环境和自动化红队测试框架取代了单纯的偏好评分。通过将基础事实验证的权重置于风格合规之上,模型因未经支持的假设而受到惩罚,从而迫使它在进行多阶段计算任务之前要求澄清或指出缺失的约束条件。
同样关键的是在长上下文执行循环中对代理偏离的缓解。当一个自主系统在数百次连续的工具调用中运行时——例如修改固件参数、运行模拟和检查组件库存——微小的下游幻觉会呈指数级累加。到第 50 次迭代循环时,未对齐的代理往往会失去对其根本约束的把握,产生语法错误或陷入停滞整个装配工作流程的死胡同子程序。更新后的对齐栈实现了连续的中间状态检查,将模型的内部推理轨迹限制在有界的逻辑范围内,从而防止失控的操作偏离。
架起软件智能与物理机器人的桥梁
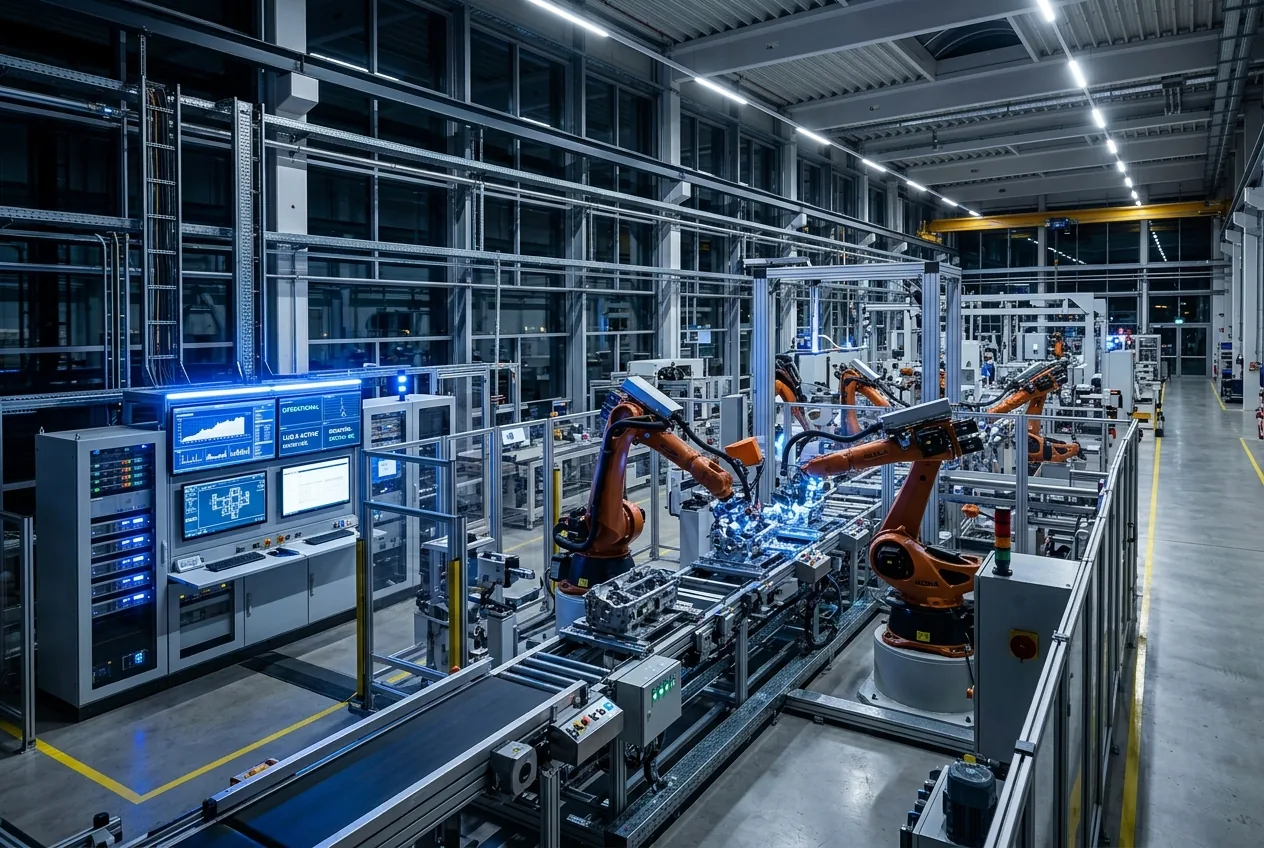
海量上下文与严苛对齐的融合,对物理车间具有深远的影响。机器人集成商长期以来一直在努力解决高级基础模型与低级控制系统之间的延迟和可靠性鸿沟。虽然微秒级的关节驱动必须保持在确定性实时操作系统(RTOS)和嵌入式微控制器的领域内,但高级路径规划、异常处理和多机器人任务分配正迅速转向多模态神经架构。
以动态制造环境为例,其中铰接式机械臂、自动导引车(AGV)和人类操作员共享一个动态工作空间。意外的物理障碍或硬件退化事件通常会触发立即的安全停机,需要人工技术人员手动诊断故障并重置生产线。借助充当监督控制器的对齐式长上下文引擎,系统可以摄取故障前数小时的高频运动学日志、电机热分布图和视觉流。它可以将这些实时数据与完整的维护历史记录和机械装配手册进行交叉引用,以识别根本原因(如轴承磨损或负载分布不平衡),并在不停止相邻生产单元的情况下合成替代的无碰撞轨迹。
此外,集成广泛的上下文窗口直接有益于硬件设计合成。利用自动化生成式设计平台的机械工程师可以将完整的 STEP 文件、有限元分析(FEA)报告和 ASTM 材料合规标准输入到单个提示上下文中。系统不仅能产生通用的几何优化,还能根据严格的法规代码评估可制造性约束(如 5 轴 CNC 铣床的刀具间隙或增材制造中的散热分布),从而大幅缩短从概念验证到物理工具制造的周期。
计算开销、延迟预算与工业现实
尽管取得了这些技术进步,但工业部署的经济性要求我们对其应用场景和方式保持怀疑。在 150 万 token 的上下文中运行推理极其消耗计算资源。即使采用最先进的 token 预测技术和优化的硬件内核,首 token 时间(TTFT)以及在大规模提示负载下的持续延迟,对于需要亚秒级响应时间的应用而言仍然是重大的障碍。
对于以极低利润率运营的制造环境,推理成本是一个不可逾越的指标。通过尖端模型持续运行数百万 token 的成本可能很快就会超过专用边缘计算硬件和专用确定性算法的成本。因此,工业部署策略可能会出现分层。运行在本地工业 PC 上、经过高度优化的较小型开源权重模型将继续管理瞬时传感器处理和确定性机器控制;而尖端级长上下文引擎将作为集中式的诊断和分析核心,在问题超出本地启发式规则时被异步调用。


Comments
No comments yet. Be the first!