推理延迟长期以来一直是人工智能领域一个静默的瓶颈。虽然基准测试排行榜历史上一直沉迷于原始参数规模和静态推理评分,但那些将前沿模型部署到现实生产环境中的工程团队却面临着一个无法妥协的运营约束:等待下一个 token 的生成。OpenAI 通过为其 GPT-5.6 Sol 模型发布 Ultrafast(超快)模式,直接针对这一延迟下限发力,使其生成速度较基准配置提升了 14 倍。
这种速度提升不仅仅是针对交互式消费类聊天机器人的增量式体验优化。在企业级部署、自主制造车间和多智能体协调框架中,token 生成速度直接决定了任务的可行性。通过以标准速度的 14 倍运行 GPT-5.6 Sol,OpenAI 正在将竞争差异化的主要驱动力从单纯的规模转向运行时机制,承认了一个响应缓慢的卓越模型在闭环物理系统和动态决策引擎中实际上是无法使用的。
低延迟推理的机制
在前沿模型上实现 14 倍的加速,需要系统级的架构和硬件层面的干预,而非简单的服务器超额配置。虽然 OpenAI 对具体的专有权重和特定的流水线实现保持保密,但这种数量级的生成式 Transformer 推理飞跃,指向了多种协调的硬件和编译器优化。在标准的自回归生成中,内存带宽而非原始算术处理能力是决定性的节流点。为每个 token 从高带宽内存向计算核心提取海量权重矩阵,会引入不可避免的内存限制延迟。
为了打破这一屏障,Ultrafast 模式似乎利用了精密的推测解码(speculative decoding)架构,并结合了激进的量化和内存管理程序。推测解码将一个重量级前沿模型与一个轻量级、超优化的草稿模型配对,后者在单次前向传递中提出多个预期 token。随后,主模型同时并行验证或拒绝整个 token 块,从而将曾经严格顺序的内存密集型任务转化为计算密集型的并行验证循环。当配合 FP4 等超低精度数值格式和次字节表示法时,所需的内存流量会急剧下降。
此外,深度内核融合(kernel fusion)和优化的键值缓存(key-value caching)在长上下文窗口中维持这些速度起到了核心作用。如果没有先进的缓存压缩协议和防止内存碎片化的内核级调度,生成速度必然会随着对话上下文的拉长而下降。通过将整个软件栈优化到硅片层,OpenAI 正在最大化现代张量加速器的设备利用率,证明了软件层面的效率提升可以匹配甚至超过代际硬件制造工艺的飞跃。
打破机器人与自动化领域的延迟壁垒
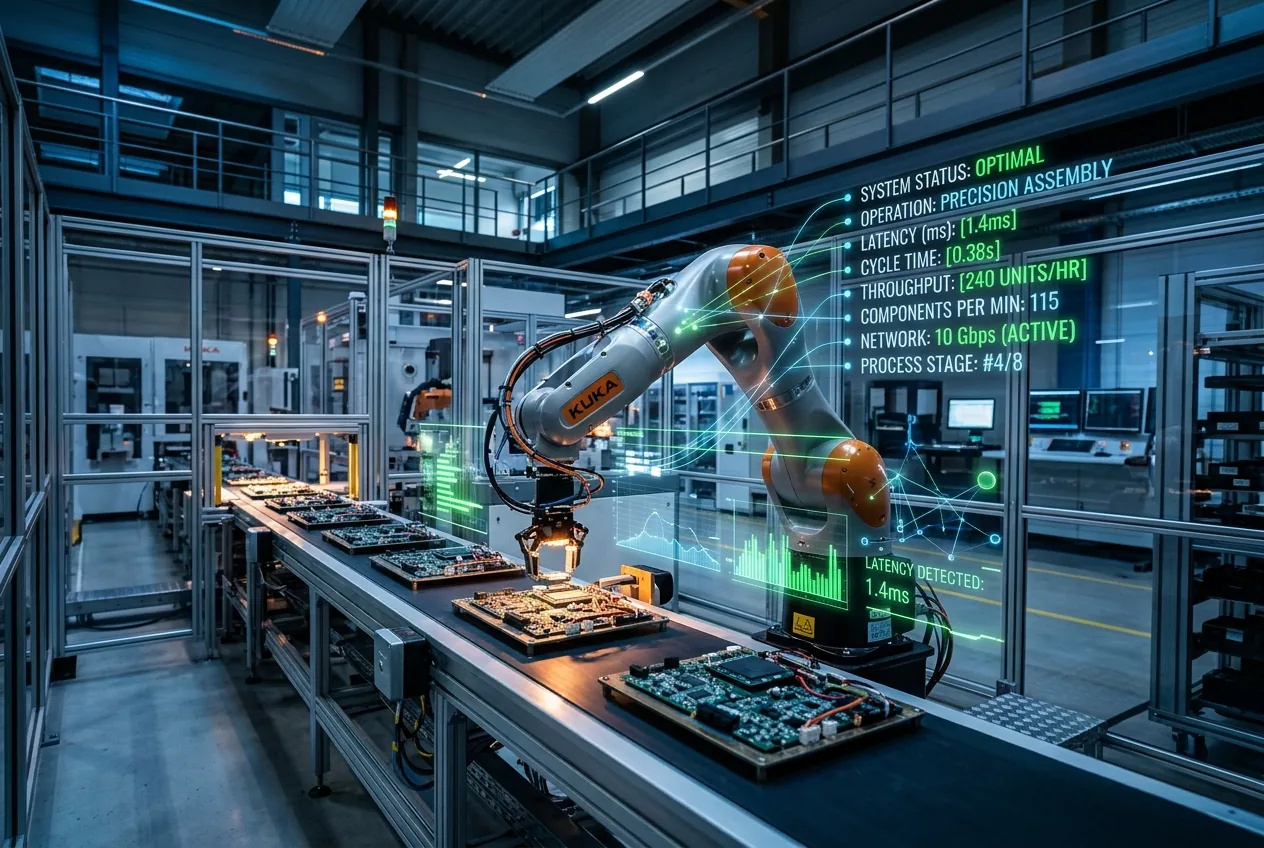
对于在机器智能与工业机械交叉领域工作的工程师而言,推理速度始终关乎安全性和操作稳定性。在信息物理系统(Cyber-physical systems)中,例如机器人分拣单元、自主移动机械臂和高频自动化检测线,控制循环往往以毫秒为单位运行。一个具有半秒延迟的高参数基础模型若直接放入触觉反馈循环中,将面临碰撞、物料掉落或过程不同步的风险。
借助 14 倍的吞吐量提升,GPT-5.6 Sol 跨越了一个重要的门槛,进入了近乎确定性的响应窗口。高速度模型不再仅仅作为提前数分钟勾勒高层策略的离线规划器,而是能够几乎与物理执行器同步地评估视觉和传感器遥测数据。一个在高速包装过程中对未知变形物体调整抓取力的自主机械臂,需要进行分秒必争的空间重评估。缩短推理往返时间,使基础模型从静态监督者转变为工厂车间中主动、灵敏的协处理器。
这一飞跃也直接影响了现代生产线上的自动质量控制。传统的计算机视觉系统擅长刚性模板匹配,但在面对上下文异常时表现吃力,而大型多模态模型过去在检测以工业速度沿传送带移动的组件时往往过于迟钝。在 14 倍标准吞吐量下,深度上下文推理与流水线周期时间之间的差距开始缩小,使得复杂的缺陷分拣无需强制生产设施降低产能即可完成。
多步智能体乘数效应
除了物理硬件之外,现代软件层日益围绕多智能体推理构建,其中编排器模型将复杂的请求分解为数十个子任务,查询外部工具,分析中间代码执行过程,并合成最终解决方案。在这些嵌套的智能体链中,延迟并非线性增加,而是呈复合式增长。如果一个智能体需要 20 次连续的工具调用循环来调试软件库或审计供应链账簿,那么每次推理步骤 3 秒的延迟就会转化为整整一分钟的停滞。
在 Ultrafast 模式下,这一 60 秒的链条缩短至 4 秒。等待一分钟与等待 4 秒之间的定性差异是深远的。它将“人在回路”的交互方式从异步的工单式工作流转变为真正的实时协作。开发人员可以交互式地迭代复杂的代码库,软件智能体也可以在不消耗用户耐心或导致关键网络连接超时的情况下,进行广泛的多分支树搜索探索。
至关重要的是,这种加速也从根本上改变了合成数据生成和自动验证的经济性。通过自评循环运行推理模型需要生成数十万条候选路径,以确定最稳健的答案。当模型以标准速度运行时,高迭代验证在财务和时间上都是令人望而却步的。通过大幅压缩 token 生成时间,企业可以在不拖累运营计划的前提下,进行更深入的审议循环和递归错误检查。
计算经济学与数据中心密度
然而,以极限速度运行会对单个处理节点带来严峻的热量和电力需求。在最大计算密度下爆发式运行推测解码内核,需要严格的功耗限制管理和激进的液冷基础设施,以防止过热降频。工程挑战已从优化静态功耗转向抑制集群在空闲状态与最大吞吐量 token 爆发之间瞬间切换时产生的极端动态负载峰值。
对于管理专用主机实例的企业而言,这些速度提升直接转化为计算开支的减少。如果一个专用节点能够处理相当于五到六个旧实例的交易量,那么部署前沿智能的总拥有成本将大幅下降。成本效率与运营速度从根本上是同一枚硬币的两面,通过运行时加速来降低单位 token 价格,是将实验原型转化为盈利且可扩展的企业应用的关键。
平衡原始速度与推理精度
对于采用 Ultrafast 模式的工程师而言,核心问题仍然在于权衡配置。在算法加速领域,速度很少是完全免费的。激进的量化、减少推测草稿采样或修剪中间注意力层等技术,可能会在细致的数学推理、深度的语法编码准确性或抗幻觉能力方面引入轻微的性能下降。系统工程师将需要严格审查 Ultrafast 模式在哪些场景下表现优异,而在哪些场景下全精度、标准速度的推理依然是不可妥协的底线。
实际上,企业 AI 架构的未来很可能是混合型的。涉及安全关键型空气动力学模拟、药物分子建模或复杂法律合同验证的高风险边缘案例,可能会继续在未经压缩、节奏经过深思熟虑的推理引擎上运行。相反,高容量的客户交互、机器人运动校正、操作遥测监控以及探索性编码可以完全迁移到像 Ultrafast 这样的高速模式。
OpenAI 对 GPT-5.6 Sol 的这一举措标志着行业正在发生重大转变:不再将模型视为仅凭纸面基准测试进行评估的单体黑盒。新兴范式将基础模型视为动态运行时引擎,其性能必须以每秒 token 数、每查询瓦数和往返响应时间来衡量。随着物理机械、自动化物流和数字工作流对反馈循环的需求日益加快,AI 领域的前沿竞争将不再仅仅取决于谁的思维最深邃,而将取决于谁的速度最快。



Comments
No comments yet. Be the first!