Die Inferenzlatenz ist seit langem der stille Flaschenhals der künstlichen Intelligenz. Während sich Benchmarks in der Vergangenheit fast obsessiv auf reine Parameterzahlen und statische Reasoning-Scores konzentrierten, standen Engineering-Teams, die Spitzenmodelle in realen Produktionsumgebungen einsetzen, vor einer unerbittlichen operativen Einschränkung: dem Warten auf das nächste Token. OpenAI hat mit der Veröffentlichung des Ultrafast-Modus für sein GPT-5.6 Sol-Modell direkt auf diese Latenzuntergrenze abgezielt und eine vierzehnfache Steigerung der Generierungsgeschwindigkeit im Vergleich zur Standardkonfiguration erreicht.
Diese Beschleunigung ist nicht nur ein inkrementelles Quality-of-Life-Update für interaktive Consumer-Chatbots. Über Unternehmensanwendungen, autonome Fertigungsstraßen und Multi-Agenten-Koordinationsframeworks hinweg bestimmt die Token-Generierungsgeschwindigkeit direkt die Durchführbarkeit von Aufgaben. Indem OpenAI GPT-5.6 Sol mit der 14-fachen Standardgeschwindigkeit betreibt, verschiebt das Unternehmen den primären Vektor des Wettbewerbsvorteils von reiner Skalierung hin zur Laufzeitmechanik. Dabei wird anerkannt, dass ein brillantes Modell, das zu langsam reagiert, für physikalische Regelkreise und dynamische Entscheidungssysteme funktional unbrauchbar ist.
Die Mechanik der latenzarmen Inferenz
Das Erreichen einer 14-fachen Beschleunigung bei einem Spitzenmodell erfordert eher systemische architektonische und hardwareseitige Eingriffe als eine einfache Überprovisionierung der Server. Obwohl OpenAI die genauen proprietären Gewichte und spezifischen Pipeline-Implementierungen unter Verschluss hält, deutet ein Sprung dieser Größenordnung bei der generativen Transformer-Inferenz auf mehrere koordinierte Hardware- und Compiler-Optimierungen hin. Bei der standardmäßigen autoregressiven Generierung ist die Speicherbandbreite – nicht die reine arithmetische Verarbeitungsleistung – der entscheidende Engpass. Das Abrufen massiver Gewichtsmatrizen aus dem High-Bandwidth Memory (HBM) zu den Rechenkernen für jedes einzelne Token führt zu unvermeidbaren speichergebundenen Verzögerungen.
Um diese Barriere zu durchbrechen, scheint der Ultrafast-Modus auf ausgefeilte Architekturen für spekulative Dekodierung zu setzen, die parallel zu aggressiven Quantisierungs- und Speicherverwaltungsroutinen laufen. Bei der spekulativen Dekodierung wird ein schweres Spitzenmodell mit einem leichtgewichtigen, hyper-optimierten Entwurfsmodell gekoppelt, das mehrere potenzielle Tokens in einem einzigen Durchlauf vorschlägt. Das primäre Modell verifiziert oder verwirft dann gleichzeitig ganze Token-Blöcke parallel, wodurch eine einst streng sequentielle, speichergebundene Aufgabe in eine rechenintensive parallele Verifizierungsschleife umgewandelt wird. In Verbindung mit numerischen Formaten mit extrem niedriger Präzision wie FP4 und Sub-Byte-Darstellungen sinkt der erforderliche Speicherverkehr drastisch.
Darüber hinaus spielen Deep Kernel Fusion und optimiertes Key-Value-Caching eine zentrale Rolle bei der Aufrechterhaltung dieser Geschwindigkeiten über erweiterte Kontextfenster hinweg. Ohne fortschrittliche Cache-Kompressionsprotokolle und Kernel-Level-Scheduling, das Speicherfragmentierung verhindert, sinkt die Generierungsgeschwindigkeit zwangsläufig mit zunehmendem Gesprächskontext. Durch die Optimierung des gesamten Software-Stacks bis hinunter zur Siliziumebene maximiert OpenAI die Geräteauslastung moderner Tensor-Beschleuniger und beweist, dass Effizienzgewinne auf Softwareebene mit generationsübergreifenden Sprüngen in der Hardwarefertigung mithalten oder diese sogar übertreffen können.
Das Durchbrechen der Latenzmauer in Robotik und Automatisierung
Für Ingenieure an der Schnittstelle von Maschinenintelligenz und industrieller Mechanik war die Inferenzgeschwindigkeit schon immer eine Frage der Sicherheit und operativen Stabilität. In cyber-physischen Systemen – wie robotischen Sortierzellen, autonomen mobilen Manipulatoren und hochfrequenten automatisierten Inspektionslinien – operieren Regelkreise im Millisekundenbereich. Ein hochparametrisches Basismodell, das mit einer Latenz von einer halben Sekunde arbeitet, kann nicht direkt in einen taktilen Feedback-Regelkreis integriert werden, ohne das Risiko von Kollisionen, herunterfallenden Materialien oder Prozessdesynchronisationen einzugehen.
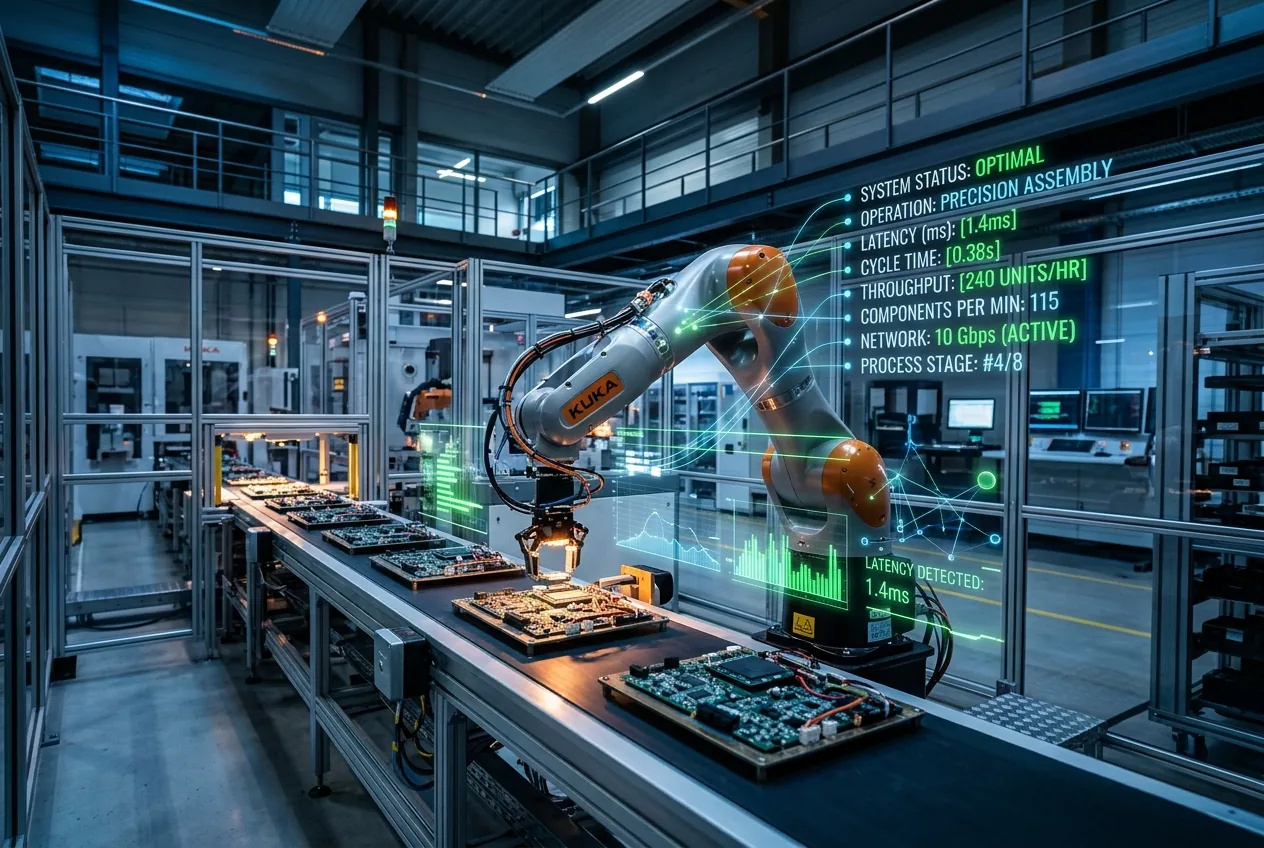
Mit einer 14-fachen Durchsatzsteigerung überschreitet GPT-5.6 Sol eine wichtige Schwelle hin zu nahezu deterministischen Reaktionszeiten. Anstatt rein als Offline-Planer zu fungieren, der Strategien Minuten im Voraus entwirft, kann ein Hochgeschwindigkeitsmodell visuelle und Sensor-Telemetriedaten nahezu im Gleichschritt mit physischen Aktuatoren auswerten. Ein autonomer Roboterarm, der während einer Hochgeschwindigkeitsverpackung seinen Griff an ein unmodelliertes, verformbares Objekt anpasst, erfordert räumliche Neubewertungen im Bruchteil einer Sekunde. Die massive Verkürzung des Inferenz-Roundtrips verwandelt Basismodelle von statischen Supervisoren in aktive, reaktive Co-Prozessoren in der Fabrikhalle.
Dieser Sprung wirkt sich auch direkt auf die automatisierte Qualitätskontrolle an modernen Fertigungslinien aus. Herkömmliche Computer-Vision-Systeme glänzen bei der starren Vorlagenanpassung, kämpfen jedoch mit kontextuellen Anomalien, während große multimodale Modelle bisher zu träge waren, um Komponenten mit industrieller Geschwindigkeit auf einem Förderband zu inspizieren. Bei 14-fachem Standarddurchsatz beginnt sich die Lücke zwischen tiefem kontextuellem Reasoning und Taktzeiten der Montagelinie zu schließen, was eine komplexe Fehlerbewertung ermöglicht, ohne dass Anlagen den Durchsatz drosseln müssen.
Der Multi-Step Agentic Multiplier
Jenseits der physischen Hardware ist die moderne Softwareschicht zunehmend um Multi-Agenten-Reasoning herum aufgebaut, bei dem ein Orchestrator-Modell komplexe Anfragen in Dutzende Teilaufgaben zerlegt, externe Tools abfragt, Zwischenergebnisse von Code-Ausführungen analysiert und finale Lösungen synthetisiert. In diesen verschachtelten Agenten-Ketten skaliert die Latenz nicht linear, sondern kumulativ. Wenn ein Agent zwanzig aufeinanderfolgende Tool-Aufrufzyklen benötigt, um ein Software-Repository zu debuggen oder ein Lieferketten-Ledger zu prüfen, bedeutet eine Latenz von drei Sekunden pro Inferenzschritt eine ganze Minute Leerlaufzeit.
Im Ultrafast-Modus schrumpft diese 60-sekündige Kette auf vier Sekunden. Der qualitative Unterschied zwischen dem Warten von einer Minute und vier Sekunden ist gravierend. Es verschiebt die Interaktion zwischen Mensch und Maschine von einem asynchronen, ticketbasierten Workflow zu echter Echtzeit-Zusammenarbeit. Entwickler können interaktiv an komplexen Codebasen arbeiten, und Software-Agenten können umfangreiche, mehrverzweigte Baumsuche-Explorationen durchführen, ohne die Geduld der Benutzer zu erschöpfen oder kritische Netzwerkverbindungen ablaufen zu lassen.
Entscheidend ist, dass diese Beschleunigung auch die Ökonomie der Generierung synthetischer Daten und der automatisierten Verifizierung grundlegend verändert. Das Durchlaufen von Reasoning-Modellen durch Selbstkritik-Zyklen erfordert die Erzeugung von Hunderttausenden von Kandidatenpfaden, um die robusteste Antwort zu finden. Wenn Modelle mit Standardgeschwindigkeit arbeiten, ist eine Verifizierung mit hoher Iterationsrate finanziell und zeitlich unerschwinglich. Durch die drastische Komprimierung der Token-Generierungszeit können Unternehmen tiefere Beratungsschleifen und rekursive Fehlerprüfungen durchführen, ohne den operativen Zeitplan zu sprengen.
Rechenökonomie und Rechenzentrumsdichte
Der Betrieb bei extremer Geschwindigkeit stellt jedoch hohe thermische und elektrische Anforderungen an einzelne Verarbeitungsknoten. Das Ausschöpfen der spekulativen Dekodierungskerne bei maximaler Rechendichte erfordert ein rigoroses Power-Capping-Management und eine aggressive Flüssigkeitskühlungsinfrastruktur, um Thermal Throttling zu verhindern. Die technische Herausforderung verlagert sich von der Optimierung des Ruhestromverbrauchs hin zur Dämpfung extremer dynamischer Lastspitzen, wenn Cluster sofort zwischen Leerlaufzuständen und Token-Bursts mit maximalem Durchsatz wechseln.
Für Unternehmen, die dedizierte Host-Instanzen verwalten, führen diese Geschwindigkeitsgewinne direkt zu reduzierten Rechenausgaben. Wenn ein dedizierter Knoten das Transaktionsvolumen von fünf oder sechs Legacy-Instanzen bewältigen kann, sinken die Gesamtbetriebskosten für den Einsatz von Spitzenintelligenz erheblich. Kosteneffizienz und operative Geschwindigkeit sind im Grunde zwei Seiten derselben Medaille, und die Senkung des Preises pro Token durch Laufzeitbeschleunigung ist essenziell, um experimentelle Prototypen in profitable, skalierbare Unternehmensanwendungen zu verwandeln.
Abwägung zwischen reiner Geschwindigkeit und Reasoning-Präzision
Die Kernfrage, die für Ingenieure bleibt, die den Ultrafast-Modus einführen, ist das Trade-off-Profil. Bei algorithmischer Beschleunigung kommt Geschwindigkeit selten völlig umsonst. Techniken wie aggressive Quantisierung, reduziertes spekulatives Draft-Sampling oder beschnittene interne Attention-Layer können leichte Verschlechterungen bei nuanciertem mathematischen Reasoning, tiefer syntaktischer Coding-Genauigkeit oder Halluzinationsresistenz mit sich bringen. Systemingenieure müssen rigoros prüfen, wo der Ultrafast-Modus glänzt und wo eine Inferenz mit voller Präzision und Standardgeschwindigkeit unverhandelbar bleibt.
In der Praxis wird die Zukunft der Enterprise-KI-Architektur wahrscheinlich hybrid sein. Hochriskante Edge-Cases, die sicherheitskritische aerodynamische Simulationen, pharmazeutische Molekularmodellierungen oder komplexe Validierungen von Rechtsverträgen beinhalten, könnten weiterhin auf unkomprimierten, bewusst getakteten Reasoning-Engines laufen. Umgekehrt können hochvolumige Kundeninteraktionen, robotische Bewegungskorrekturen, operative Telemetrieüberwachung und exploratives Coden vollständig auf Hochgeschwindigkeitsmodi wie Ultrafast migrieren.
OpenAIs Schritt mit GPT-5.6 Sol signalisiert eine branchenweite Abkehr davon, Modelle als monolithische Blackboxen zu behandeln, die ausschließlich nach Papier-Benchmarks bewertet werden. Das neue Paradigma betrachtet Basismodelle als dynamische Laufzeit-Engines, deren Leistung in Token pro Sekunde, Watt pro Abfrage und Roundtrip-Reaktionszeit gemessen werden muss. Da physische Maschinen, automatisierte Logistik und digitale Workflows immer schnellere Feedback-Schleifen fordern, wird die Grenze der KI nicht nur von den tiefgründigsten Denkern, sondern von den schnellsten gewonnen werden.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!