La latence d'inférence est restée longtemps le goulot d'étranglement silencieux de l'intelligence artificielle. Alors que les classements de référence se sont historiquement obsédés par le nombre brut de paramètres et les scores de raisonnement statiques, les équipes d'ingénierie déployant des modèles de pointe dans des environnements de production réels ont fait face à une contrainte opérationnelle inflexible : attendre le jeton suivant. OpenAI a directement visé ce seuil de latence avec le lancement du mode Ultrafast pour son modèle GPT-5.6 Sol, offrant une vitesse de génération quatorze fois supérieure à celle de sa configuration de base.
Cette accélération n'est pas simplement un correctif incrémental de confort pour les chatbots grand public interactifs. Dans les déploiements en entreprise, les usines de fabrication autonomes et les cadres de coordination multi-agents, la vitesse de génération de jetons régit directement la viabilité des tâches. En faisant fonctionner GPT-5.6 Sol à 14 fois sa vitesse standard, OpenAI déplace le vecteur principal de différenciation concurrentielle, passant de l'échelle brute à la mécanique d'exécution, reconnaissant qu'un modèle brillant qui répond trop lentement est fonctionnellement inutilisable pour les systèmes physiques en boucle fermée et les moteurs de décision dynamiques.
La mécanique de l'inférence à faible latence
Atteindre une accélération de 14x sur un modèle de pointe nécessite des interventions systémiques au niveau de l'architecture et du matériel plutôt qu'un simple surprovisionnement des serveurs. Bien qu'OpenAI ait gardé secrètes les pondérations propriétaires exactes et les implémentations spécifiques du pipeline, un bond d'un ordre de grandeur de cette ampleur dans l'inférence par transformateur génératif pointe vers plusieurs optimisations coordonnées du matériel et du compilateur. Dans la génération autorégressive standard, la bande passante mémoire — plutôt que le traitement arithmétique brut — est le facteur limitant définitif. L'extraction de matrices de poids massives depuis la mémoire à large bande passante vers les cœurs de calcul pour chaque jeton individuel introduit des délais inévitables liés à la mémoire.
Pour briser cette barrière, le mode Ultrafast semble tirer parti d'architectures de décodage spéculatif raffinées fonctionnant parallèlement à des routines agressives de quantification et de gestion de la mémoire. Le décodage spéculatif associe un modèle de pointe lourd à un modèle de brouillon léger et hyper-optimisé qui propose plusieurs jetons prospectifs en un seul passage vers l'avant. Le modèle principal vérifie ou rejette ensuite simultanément des blocs entiers de jetons en parallèle, convertissant ce qui était autrefois une corvée séquentielle liée à la mémoire en une boucle de vérification parallèle liée au calcul. Lorsqu'il est associé à des formats numériques ultra-basse précision comme le FP4 et des représentations inférieures à l'octet, le trafic mémoire requis chute de manière spectaculaire.
En outre, la fusion profonde des noyaux (kernel fusion) et la mise en cache optimisée des clés-valeurs jouent un rôle central dans le maintien de ces vitesses sur des fenêtres contextuelles étendues. Sans protocoles avancés de compression du cache et une planification au niveau du noyau évitant la fragmentation de la mémoire, la vitesse de génération se dégrade inévitablement à mesure que le contexte conversationnel s'allonge. En optimisant l'ensemble de la pile logicielle jusqu'à la couche silicium, OpenAI maximise l'utilisation des périphériques sur les accélérateurs tensoriels modernes, prouvant que les gains d'efficacité au niveau logiciel peuvent égaler ou dépasser les sauts générationnels de fabrication matérielle.
Franchir le mur de latence dans la robotique et l'automatisation
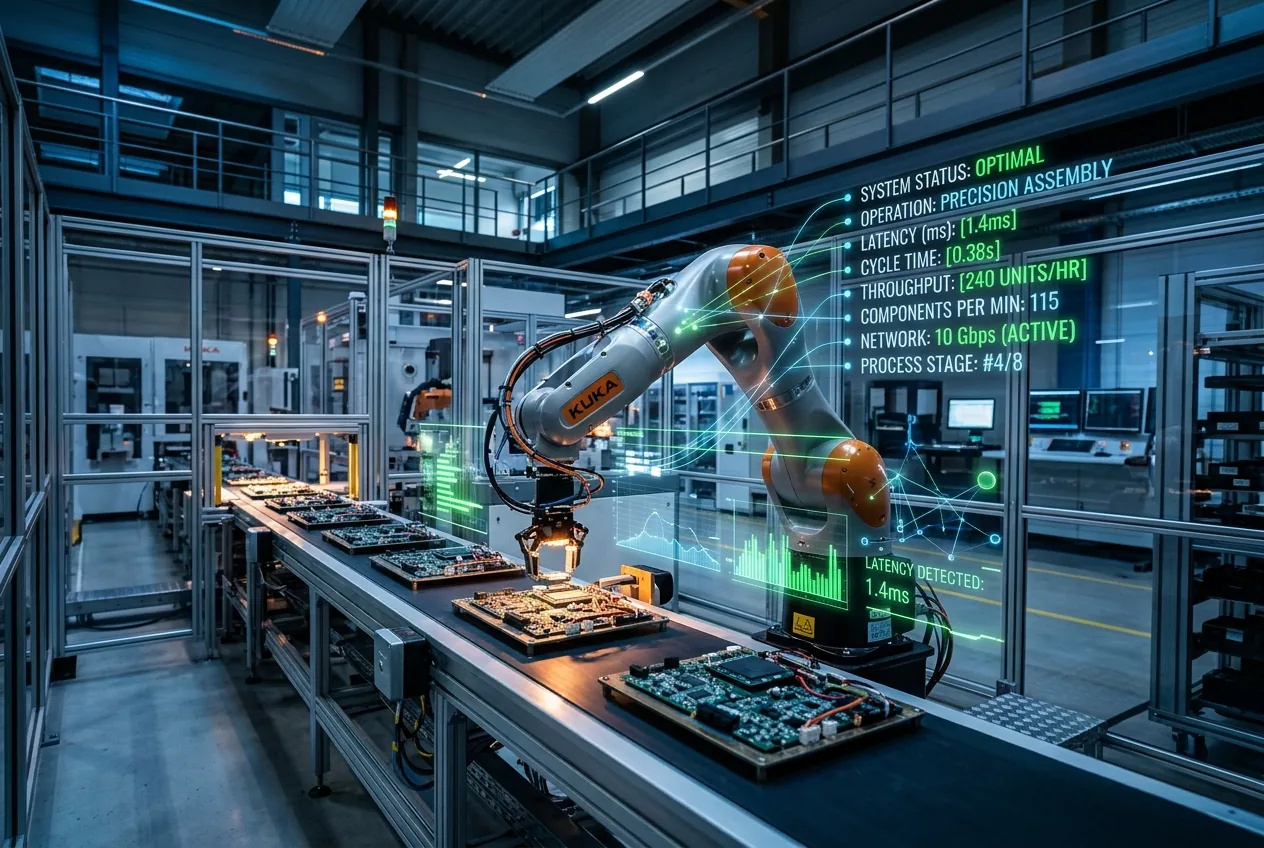
Pour les ingénieurs travaillant à l'intersection de l'intelligence artificielle et de la mécanique industrielle, la vitesse d'inférence a toujours été une question de sécurité et de stabilité opérationnelle. Dans les systèmes cyber-physiques — tels que les cellules de tri robotisées, les manipulateurs mobiles autonomes et les lignes d'inspection automatisées à haute fréquence — les boucles de contrôle fonctionnent à l'échelle de la milliseconde. Un modèle de base à paramètres élevés fonctionnant avec une latence d'une demi-seconde ne peut être placé directement dans une boucle de rétroaction tactile sans risquer des collisions, des chutes de matériaux ou une désynchronisation des processus.
Avec un gain de débit de 14x, GPT-5.6 Sol franchit un seuil important vers des fenêtres de réponse quasi déterministes. Au lieu de fonctionner strictement comme un planificateur hors ligne esquissant des stratégies de haut niveau des minutes à l'avance, un modèle à haute vitesse peut évaluer la télémétrie visuelle et sensorielle presque en phase avec les actionneurs physiques. Un bras robotique autonome ajustant sa prise sur un objet déformable non modélisé lors d'un emballage à grande vitesse nécessite des réévaluations spatiales en une fraction de seconde. Réduire le temps d'aller-retour de l'inférence transforme les modèles de base, passant de superviseurs statiques à des co-processeurs actifs et réactifs dans l'usine.
Ce bond impacte également directement le contrôle qualité automatisé sur les lignes de fabrication modernes. Les systèmes de vision par ordinateur traditionnels excellent dans la correspondance de modèles rigides mais peinent face aux anomalies contextuelles, tandis que les grands modèles multimodaux ont historiquement été trop lents pour inspecter des composants se déplaçant sur un convoyeur à des vitesses industrielles. À 14 fois le débit standard, l'écart entre le raisonnement contextuel profond et les temps de cycle de la chaîne de montage commence à se réduire, permettant un triage complexe des défauts sans forcer les installations à réduire leur cadence.
Le multiplicateur agentique multi-étapes
Au-delà du matériel physique, la couche logicielle moderne est de plus en plus construite autour du raisonnement multi-agents, où un modèle orchestrateur décompose des requêtes complexes en dizaines de sous-tâches, interroge des outils externes, analyse des exécutions de code intermédiaires et synthétise les solutions finales. Dans ces chaînes agentiques imbriquées, la latence ne s'additionne pas de manière linéaire ; elle se cumule. Si un agent nécessite vingt cycles successifs d'invocation d'outils pour déboguer un référentiel logiciel ou auditer un registre de chaîne d'approvisionnement, une latence de trois secondes par étape d'inférence se traduit par une minute entière de temps mort.
En mode Ultrafast, cette chaîne de soixante secondes s'effondre à quatre secondes. La différence qualitative entre attendre une minute et attendre quatre secondes est profonde. Elle fait passer l'interaction humain-dans-la-boucle d'un flux de travail asynchrone basé sur des tickets à une véritable collaboration en temps réel. Les développeurs peuvent itérer interactivement sur des bases de code complexes, et les agents logiciels peuvent mener une exploration approfondie par recherche arborescente multi-branches sans épuiser la patience de l'utilisateur ou provoquer l'expiration de connexions réseau critiques.
Surtout, cette accélération modifie fondamentalement l'économie de la génération de données synthétiques et de la vérification automatisée. Faire passer des modèles de raisonnement par des cycles d'auto-critique nécessite de générer des centaines de milliers de voies candidates pour identifier la réponse la plus robuste. Lorsque les modèles fonctionnent à des vitesses standard, la vérification à haute itération est financièrement et chronologiquement prohibitive. En compressant radicalement le temps de génération des jetons, les organisations peuvent exécuter des boucles de délibération plus profondes et des vérifications d'erreurs récursives sans faire exploser les calendriers opérationnels.
Économie du calcul et densité des centres de données
Cependant, fonctionner à une vitesse extrême impose des exigences thermiques et électriques sévères sur les nœuds de traitement individuels. Dépasser les limites des noyaux de décodage spéculatif à une densité de calcul maximale nécessite une gestion rigoureuse de la limitation de puissance (power-capping) et une infrastructure de refroidissement liquide agressive pour éviter le bridage thermique. Le défi technique passe de l'optimisation de la consommation électrique au repos à l'atténuation des pics de charge dynamique extrêmes lorsque les clusters passent instantanément des états inactifs aux rafales de jetons à débit maximal.
Pour les entreprises gérant des instances hôtes dédiées, ces gains de vitesse se traduisent directement par une réduction des dépenses de calcul. Si un nœud dédié peut gérer le volume de transactions de cinq ou six instances héritées, le coût total de possession pour le déploiement de l'intelligence de pointe chute substantiellement. L'efficacité des coûts et la vitesse opérationnelle sont fondamentalement les deux faces d'une même pièce, et réduire le prix par jeton grâce à la vitesse d'exécution est essentiel pour transformer des prototypes expérimentaux en applications d'entreprise rentables et évolutives.
Équilibrer la vitesse brute et la précision du raisonnement
La question centrale qui demeure pour les ingénieurs adoptant le mode Ultrafast est le profil de compromis. Dans l'accélération algorithmique, la vitesse est rarement totalement gratuite. Des techniques telles que la quantification agressive, l'échantillonnage de brouillon spéculatif réduit ou les couches d'attention intermédiaires élaguées peuvent introduire de légères dégradations dans le raisonnement mathématique nuancé, la précision du codage syntaxique profond ou la résistance aux hallucinations. Les ingénieurs système devront auditer rigoureusement où le mode Ultrafast excelle et où l'inférence en pleine précision à vitesse standard reste non négociable.
En pratique, l'avenir de l'architecture IA en entreprise sera probablement hybride. Les cas critiques impliquant des simulations aérodynamiques, la modélisation moléculaire pharmaceutique ou la validation de contrats juridiques complexes pourraient continuer à fonctionner sur des moteurs de raisonnement non compressés et délibérément cadencés. À l'inverse, les interactions clients à haut volume, la correction des mouvements robotiques, la surveillance de la télémétrie opérationnelle et le codage exploratoire peuvent migrer entièrement vers des modes haute vitesse comme Ultrafast.
L'initiative d'OpenAI avec GPT-5.6 Sol signale un pivot à l'échelle de l'industrie, s'éloignant de la considération des modèles comme des boîtes noires monolithiques évaluées uniquement sur des benchmarks papier. Le paradigme émergent traite les modèles de base comme des moteurs d'exécution dynamiques dont la performance doit être mesurée en jetons par seconde, en watts par requête et en réactivité des allers-retours. Alors que la machinerie physique, la logistique automatisée et les flux de travail numériques exigent des boucles de rétroaction toujours plus rapides, la frontière de l'IA ne sera conquise non seulement par les penseurs les plus profonds, mais par les plus rapides.



Comments
No comments yet. Be the first!