La latencia de inferencia ha sido durante mucho tiempo el cuello de botella silencioso de la inteligencia artificial. Si bien las tablas de clasificación de referencia se han obsesionado históricamente con el número de parámetros brutos y las puntuaciones de razonamiento estático, los equipos de ingeniería que despliegan modelos de vanguardia en entornos de producción reales se han enfrentado a una restricción operativa inquebrantable: esperar al siguiente token. OpenAI ha apuntado directamente a ese umbral de latencia con el lanzamiento del modo Ultrafast para su modelo GPT-5.6 Sol, que ofrece un aumento de catorce veces en la velocidad de generación en comparación con su configuración base.
La aceleración no es simplemente un parche de calidad de vida incremental para los chatbots interactivos de consumo. En despliegues empresariales, plantas de fabricación autónomas y marcos de coordinación multiagente, la velocidad de generación de tokens rige directamente la viabilidad de las tareas. Al ejecutar GPT-5.6 Sol a 14 veces la velocidad estándar, OpenAI está desplazando el vector principal de diferenciación competitiva desde la escala bruta hacia la mecánica de ejecución, reconociendo que un modelo brillante que responde con demasiada lentitud es funcionalmente inutilizable para sistemas físicos de bucle cerrado y motores de decisión dinámicos.
La mecánica de la inferencia de baja latencia
Lograr una aceleración de 14x en un modelo de vanguardia requiere intervenciones sistémicas a nivel arquitectónico y de hardware, en lugar de una simple sobreprovisión de servidores. Aunque OpenAI ha mantenido en secreto los pesos propietarios exactos y las implementaciones específicas de la canalización, un salto de magnitud en esta escala en la inferencia de transformadores generativos apunta a varias optimizaciones coordinadas de hardware y compilador. En la generación autorregresiva estándar, el ancho de banda de la memoria —más que el procesamiento aritmético bruto— es el limitador determinante. La obtención de matrices de pesos masivas desde la memoria de gran ancho de banda hacia los núcleos de computación para cada token individual introduce retrasos inevitables limitados por la memoria.
Para romper esa barrera, el modo Ultrafast parece aprovechar arquitecturas de decodificación especulativa refinadas que se ejecutan junto con rutinas agresivas de cuantización y gestión de memoria. La decodificación especulativa empareja un modelo de vanguardia pesado con un modelo de borrador ligero y altamente optimizado que propone múltiples tokens prospectivos en una sola pasada hacia adelante. El modelo primario luego verifica o rechaza bloques enteros de tokens simultáneamente en paralelo, convirtiendo lo que antes era una tarea estrictamente secuencial limitada por la memoria en un bucle de verificación paralelo limitado por la computación. Cuando se combina con formatos numéricos de ultra baja precisión, como FP4 y representaciones sub-byte, el tráfico de memoria requerido disminuye precipitadamente.
Además, la fusión profunda de núcleos y el almacenamiento en caché de clave-valor optimizado juegan un papel central en el sostenimiento de estas velocidades a través de ventanas contextuales extendidas. Sin protocolos avanzados de compresión de caché y una programación a nivel de núcleo que evite la fragmentación de la memoria, la velocidad de generación se degrada inevitablemente a medida que el contexto conversacional se alarga. Al optimizar toda la pila de software directamente hasta la capa de silicio, OpenAI maximiza la utilización del dispositivo en aceleradores tensoriales modernos, demostrando que las ganancias de eficiencia a nivel de software pueden igualar o superar los saltos generacionales en la fabricación de hardware.
Rompiendo el muro de latencia en robótica y automatización
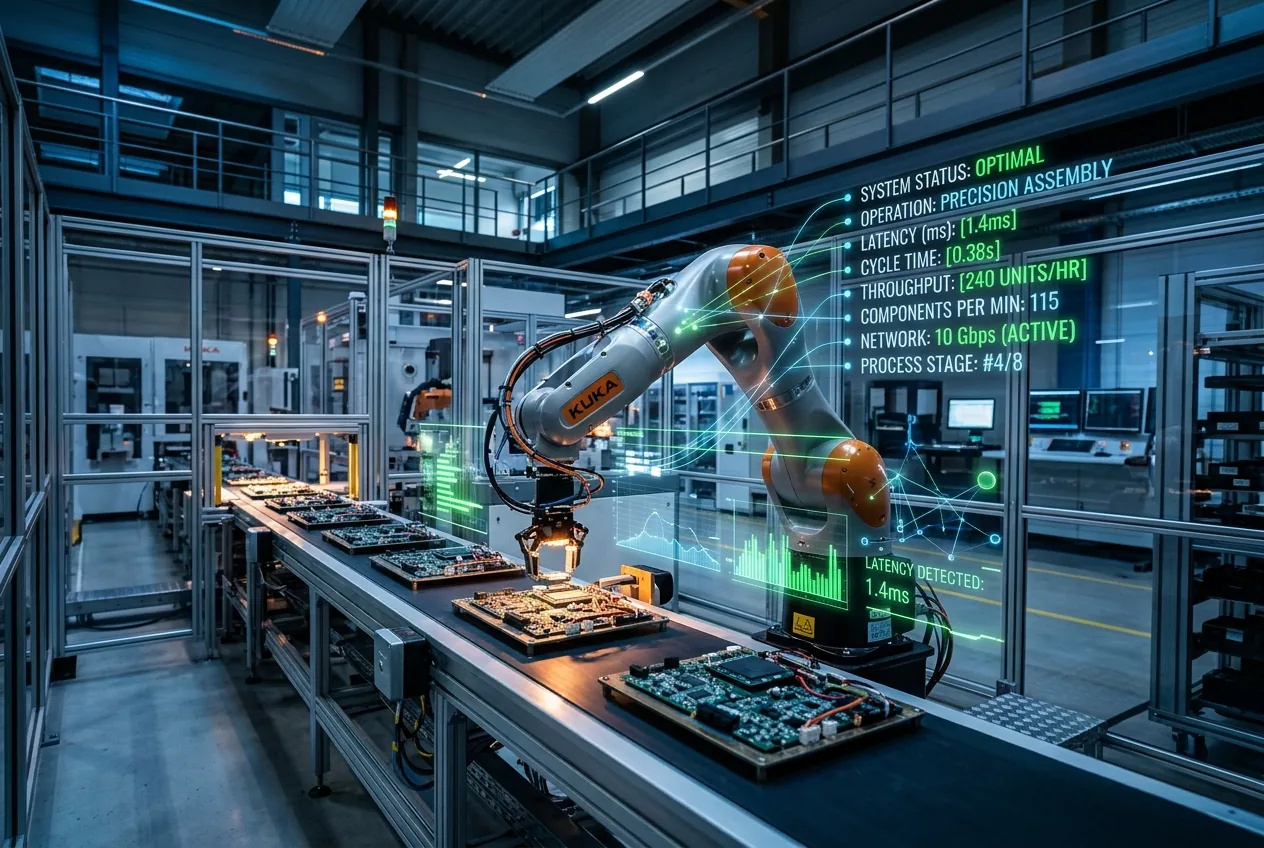
Para los ingenieros que trabajan en la intersección de la inteligencia artificial y la mecánica industrial, la velocidad de inferencia siempre ha sido una cuestión de seguridad y estabilidad operativa. En los sistemas ciberfísicos —como celdas de clasificación robótica, manipuladores móviles autónomos y líneas de inspección automatizadas de alta frecuencia— los bucles de control operan en el orden de los milisegundos. Un modelo base de alto número de parámetros que se ejecuta con una latencia de medio segundo no puede colocarse directamente en un bucle de retroalimentación táctil sin arriesgarse a colisiones, caída de materiales o desincronización de procesos.
Con un aumento de rendimiento de 14x, GPT-5.6 Sol cruza un umbral importante hacia ventanas de respuesta casi deterministas. En lugar de funcionar estrictamente como un planificador fuera de línea que esboza estrategias de alto nivel con minutos de antelación, un modelo de alta velocidad puede evaluar la telemetría visual y de sensores casi al paso de los actuadores físicos. Un brazo robótico autónomo que ajusta su agarre sobre un objeto deformable no modelado durante un empaquetado a alta velocidad requiere reevaluaciones espaciales en fracciones de segundo. Reducir el tiempo de ida y vuelta de la inferencia transforma los modelos base de supervisores estáticos a coprocesadores activos y reactivos en la planta de producción.
Este salto también impacta directamente en el control de calidad automatizado a lo largo de las líneas de fabricación modernas. Los sistemas tradicionales de visión artificial sobresalen en la coincidencia de plantillas rígidas pero tienen dificultades con las anomalías contextuales, mientras que los grandes modelos multimodales han sido históricamente demasiado lentos para inspeccionar componentes que se mueven a lo largo de una cinta transportadora a velocidades industriales. A 14 veces el rendimiento estándar, la brecha entre el razonamiento contextual profundo y los tiempos de ciclo de la línea de montaje comienza a cerrarse, permitiendo que la clasificación compleja de defectos tenga lugar sin obligar a las instalaciones a limitar el rendimiento.
El multiplicador agéntico de múltiples pasos
Más allá del hardware físico, la capa de software moderna se construye cada vez más en torno al razonamiento multiagente, en el que un modelo orquestador divide las solicitudes complejas en docenas de subtareas, consulta herramientas externas, analiza ejecuciones de código intermedias y sintetiza soluciones finales. En estas cadenas agénticas anidadas, la latencia no escala linealmente; se complica. Si un agente requiere veinte ciclos sucesivos de invocación de herramientas para depurar un repositorio de software o auditar un registro de cadena de suministro, una latencia de tres segundos por paso de inferencia se traduce en un minuto completo de tiempo muerto.
Bajo el modo Ultrafast, esa cadena de sesenta segundos se reduce a cuatro segundos. La diferencia cualitativa entre esperar un minuto y esperar cuatro segundos es profunda. Cambia la interacción humana en el bucle de un flujo de trabajo basado en tickets asincrónicos a una colaboración genuina en tiempo real. Los desarrolladores pueden iterar sobre bases de código complejas de forma interactiva, y los agentes de software pueden realizar una exploración extensiva de búsqueda en árbol de múltiples ramas sin agotar la paciencia del usuario ni agotar el tiempo de espera de las conexiones de red críticas.
Crucialmente, esta aceleración también altera fundamentalmente la economía de la generación de datos sintéticos y la verificación automatizada. Ejecutar modelos de razonamiento a través de ciclos de autocrítica requiere generar cientos de miles de vías candidatas para identificar la respuesta más robusta. Cuando los modelos operan a velocidades estándar, la verificación de alta iteración es financiera y cronológicamente prohibitiva. Al comprimir drásticamente el tiempo de generación de tokens, las organizaciones pueden ejecutar bucles de deliberación más profundos y comprobaciones de errores recursivas sin arruinar los calendarios operativos.
Economía de la computación y densidad del centro de datos
Sin embargo, ejecutar a una velocidad extrema impone severas demandas térmicas y eléctricas a los nodos de procesamiento individuales. Explotar los núcleos de decodificación especulativa a la máxima densidad de computación requiere una gestión rigurosa de la limitación de energía y una infraestructura de refrigeración líquida agresiva para evitar la limitación térmica. El desafío de ingeniería cambia de optimizar el consumo de energía en reposo a amortiguar los picos de carga dinámica extremos a medida que los clústeres pasan instantáneamente de estados inactivos a ráfagas de tokens de máximo rendimiento.
Para las empresas que gestionan instancias de alojamiento dedicadas, estas ganancias de velocidad se traducen directamente en una reducción del gasto en computación. Si un nodo dedicado puede manejar el volumen de transacciones de cinco o seis instancias heredadas, el coste total de propiedad para desplegar inteligencia de vanguardia cae sustancialmente. La eficiencia de costes y la velocidad operativa son fundamentalmente dos caras de la misma moneda, y reducir el precio por token a través de la velocidad de ejecución es esencial para convertir prototipos experimentales en aplicaciones empresariales rentables y escalables.
Equilibrando la velocidad bruta frente a la precisión del razonamiento
La pregunta fundamental que queda para los ingenieros que adoptan el modo Ultrafast es el perfil de compensación. En la aceleración algorítmica, la velocidad rara vez es completamente gratuita. Técnicas como la cuantización agresiva, el muestreo reducido de borradores especulativos o las capas de atención intermedia podadas pueden introducir ligeras degradaciones en el razonamiento matemático matizado, la precisión de la codificación sintáctica profunda o la resistencia a las alucinaciones. Los ingenieros de sistemas deberán auditar rigurosamente dónde destaca el modo Ultrafast y dónde la inferencia de precisión completa y velocidad estándar sigue siendo innegociable.
En la práctica, el futuro de la arquitectura de IA empresarial probablemente sea híbrido. Los casos extremos de alto riesgo que involucran simulaciones aerodinámicas críticas para la seguridad, modelado molecular farmacéutico o validación de contratos legales complejos pueden seguir ejecutándose en motores de razonamiento sin comprimir y de ritmo deliberado. Por el contrario, las interacciones con los clientes de gran volumen, la corrección de movimiento robótico, el monitoreo de telemetría operativa y la codificación exploratoria pueden migrar completamente a modos de alta velocidad como Ultrafast.
El movimiento de OpenAI con GPT-5.6 Sol señala un giro en toda la industria para dejar de tratar los modelos como cajas negras monolíticas evaluadas únicamente en pruebas de referencia en papel. El paradigma emergente trata a los modelos base como motores de ejecución dinámicos cuyo rendimiento debe medirse en tokens por segundo, vatios por consulta y capacidad de respuesta de ida y vuelta. A medida que la maquinaria física, la logística automatizada y los flujos de trabajo digitales exigen bucles de retroalimentación cada vez más rápidos, la vanguardia de la IA no la ganarán solo los pensadores más profundos, sino los más rápidos.



Comments
No comments yet. Be the first!