Nell'infrastruttura di machine learning, la tensione tra capacità di ragionamento del modello e latenza operativa ha funzionato a lungo come una legge di conservazione: se servivano risposte deterministiche in tempo reale, si ricorreva a compressione, quantizzazione o distillazione verso architetture leggere. Se invece era necessario un ragionamento di frontiera, si accettava la "tassa sulla latenza" imposta dai cluster GPU limitati dalla memoria. L'anteprima di OpenAI della modalità Ultrafast per il suo modello di punta, GPT-5.6 Sol, attacca sistematicamente questo compromesso. Eseguito a una velocità fino a 14 volte superiore rispetto alle normali distribuzioni di produzione, il nuovo livello genera fino a 750 token di output al secondo, colmando il divario tra intelligenza di frontiera ed esecuzione sincrona a velocità macchina.
L'annuncio sposta il dibattito tecnico dalla scala dei parametri grezzi alla meccanica della velocità di inferenza. Piuttosto che basarsi su ottimizzazioni incrementali dei rack server esistenti basati su parallelismo tensoriale, questa classe di velocità è alimentata da un'integrazione hardware diretta con il produttore di chip Cerebras. L'erogazione di 750 token al secondo trasforma i modelli generativi da sistemi contemplativi a turni a pipeline di dati continui, capaci di tenere il passo con il dialogo umano ad alta larghezza di banda, ambienti di trading quantitativo e cicli di controllo industriale autonomi.
Superare il muro di memoria autoregressivo
Per capire perché un salto di velocità di 14 volte sia importante, occorre analizzare il collo di bottiglia ingegneristico della generazione di token autoregressiva. L'inferenza dei modelli linguistici di grandi dimensioni è notoriamente limitata dalla larghezza di banda della memoria piuttosto che dalla potenza di calcolo durante la fase di generazione. Mentre l'acquisizione iniziale del prompt può parallelizzare le moltiplicazioni di matrici su migliaia di core tensoriali, la generazione dei token di output avviene in sequenza: ogni nuovo token richiede la lettura dell'intero set di pesi del modello e della cache chiave-valore (KV) dalla memoria. Sui cluster convenzionali composti da GPU discrete collegate tramite bus PCIe e switch NVLink, il tempo di transito fisico tra gli stack di memoria ad alta larghezza di banda (HBM) e la logica di calcolo crea una base di latenza insormontabile.
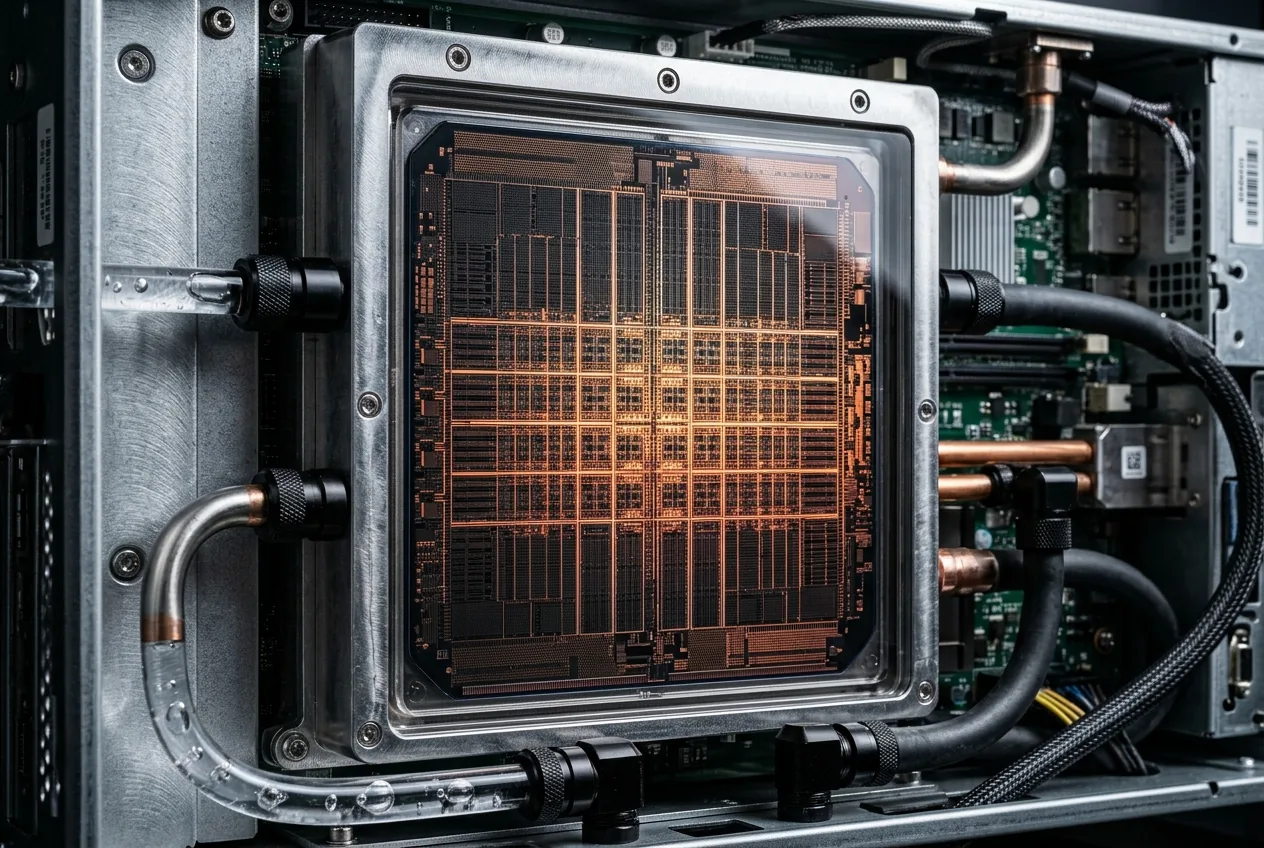
Per un modello con la complessità di GPT-5.6 Sol, l'esecuzione su questo tessuto a livello di wafer elimina il sovraccarico di serializzazione. Il risultato è un ambiente di inferenza in cui le velocità di trasferimento della memoria corrispondono ai tassi di esecuzione aritmetica. Questo cambiamento strutturale consente a OpenAI di fornire 750 token al secondo senza dover potare i livelli del modello, degradare la precisione in virgola mobile a livelli inutilizzabili o sacrificare la comprensione contestuale.
Chiusura del ciclo di controllo nei sistemi industriali e digitali
Nell'ingegneria meccanica e nei sistemi industriali, la latenza determina la fedeltà del controllo. Un sistema che impiega cinque secondi per analizzare la telemetria non può partecipare al controllo di supervisione a ciclo chiuso; è relegato a un'attività di log post-mortem passivo. Riducendo la latenza a un output quasi istantaneo, OpenAI ha dimostrato che la modalità Ultrafast può generare simulazioni 3D di magazzini funzionali e interattive direttamente da prompt testuali descrittivi in tempo reale. I livelli di inferenza standard costruiscono gli ambienti in modo incrementale, procedendo a scatti attraverso calcoli spaziali e dichiarazioni di asset; Ultrafast renderizza la logica programmatica e le geometrie spaziali a velocità paragonabili a quelle di una pipeline grafica nativa che compila codice.
Questa velocità altera il modo in cui il software autonomo interagisce con le risorse fisiche e digitali. All'interno di OpenAI, i team di ingegneria hanno implementato Ultrafast nei flussi di lavoro di risposta automatizzata agli incidenti. Durante complessi blackout produttivi, quando la telemetria distribuita, le tracce di memoria e i log di errore cambiano dinamicamente, i secondi determinano l'entità del danno. Invece di attendere un prolungato ciclo di inferenza diagnostica, il motore Ultrafast acquisisce telemetria multi-sorgente, formula ipotesi, esegue script di verifica e redige patch correttive mentre l'anomalia è ancora in fase di propagazione attiva.
Le stesse meccaniche si applicano alle catene di fornitura fisiche e alle strutture automatizzate. Quando le flotte robotiche incontrano fallimenti di prelievo ai margini o blocchi spaziali, la risoluzione del conflitto di traiettoria richiede la sintesi di input dei sensori, vincoli cinematici e tabelle di stato del magazzino. Un modello che opera a 750 token al secondo può analizzare la modalità di guasto non strutturata, calcolare ricalcoli praticabili ed emettere comandi correttivi ben entro le soglie temporali operative standard dei controllori logici programmabili industriali.
Stress test aziendali ed eliminazione della latenza
I test di accesso anticipato tra i partner aziendali esterni dimostrano come l'inferenza ad alto throughput modifichi la progettazione del software commerciale. La società di trading quantitativo Jane Street ha integrato il livello Ultrafast negli ambienti di programmazione orientati agli sviluppatori, abbattendo la barriera di latenza che tradizionalmente interrompe la concentrazione del programmatore durante complesse trasformazioni di codice su più file. Quando i completamenti del codice e i refactoring architettonici completi vengono generati più velocemente di quanto un ingegnere possa esaminarli, il ciclo cognitivo rimane ininterrotto.
Nelle applicazioni vocali, i miglioramenti della latenza risolvono un vincolo strutturale ancora più rigido. La piattaforma di comunicazione Podium ha integrato GPT-5.6 Sol Ultrafast nel suo stack vocale di produzione. Storicamente, gli agenti vocali conversazionali dovevano affidarsi a modelli minuscoli e altamente specializzati per mantenere le latenze di risposta round-trip sotto i 500 millisecondi, la soglia oltre la quale la conversazione umana appare interrotta e innaturale. Ultrafast consente agli sviluppatori di eseguire modelli di ragionamento profondi e a parametri completi all'interno del ciclo di streaming audio senza instabilità conversazionale, permettendo agli agenti di analizzare query complesse, incrociare database esterni e sintetizzare risposte parlate senza pause imbarazzanti.
Le piattaforme di ricerca finanziaria come Rogo e le aziende di automazione dei flussi di lavoro come Basis riportano cambiamenti strutturali simili. L'aggregazione complessa di documenti in più fasi, la modellazione finanziaria e l'uso deterministico di strumenti tipicamente sommano la latenza a ogni invocazione di sotto-agente. Quando un agente analitico deve richiamare una mezza dozzina di strumenti in sequenza, un ritardo di 10 secondi per passaggio rende la ricerca interattiva non praticabile. A 750 token al secondo, le orchestrazioni multi-agente completano le loro catene di ragionamento end-to-end in frazioni di secondo, convertendo l'estrazione dati in stile batch in un dialogo analitico continuo.
Il calcolo economico dell'inferenza su wafer su misura
Sebbene le cifre prestazionali della modalità Ultrafast rappresentino un innegabile salto tecnico, esse introducono anche complesse questioni infrastrutturali ed economiche. Il mercato dell'IA iperscalabile si è in gran parte consolidato attorno ad architetture rack modulari standard popolate da GPU commodity. La distribuzione di silicio su scala wafer richiede una distribuzione di potenza su misura, loop di raffreddamento a liquido personalizzati e catene di strumenti di compilazione dedicati in grado di mappare enormi grafi computazionali sull'intero wafer di silicio senza ricorrere al routing standard dei cluster.
L'equazione delle spese in conto capitale per l'esecuzione di modelli di frontiera a una velocità 14 volte superiore dipende interamente dalla densità di utilizzo. I motori su scala wafer comportano una notevole complessità di packaging e produzione rispetto ai singoli die modulari tagliati da lingotti standard da 300 mm. Tuttavia, poiché ogni wafer può sostituire dozzine di nodi server discreti consumando meno watt totali per token erogato, le spese operative dell'inferenza ad alta densità possono diventare favorevoli su larga scala. Se un'impresa paga un prezzo premium per il livello API Ultrafast, ma tale livello elimina i tempi di inattività dei lavoratori, consolida l'infrastruttura di calcolo e abilita prodotti in tempo reale precedentemente impossibili, il costo totale di proprietà vira nettamente a favore del silicio ad alto throughput.
I vincoli di capacità detteranno la velocità di rilascio. OpenAI sta lanciando Ultrafast in un livello di anteprima limitato proprio perché la capacità su scala wafer non può essere avviata dall'oggi al domani in strutture di colocation generiche. Man mano che la produzione di Cerebras si espanderà e OpenAI costruirà cluster dedicati a bassa latenza, la disponibilità di modelli di frontiera a 750 token al secondo metterà alla prova se l'ecosistema tecnologico più ampio sia pronto a ricostruire le proprie architetture software attorno all'intelligenza generativa istantanea.
Il passaggio all'intelligenza artificiale sincrona
La transizione dalle velocità di inferenza standard a quelle di Ultrafast segna la fine di un'era in cui l'intelligenza artificiale era trattata come uno strato di consulenza asincrono. Per il primo decennio del deep learning commerciale, gli ingegneri del software hanno trattato le reti neurali come query di database remote: inviare un prompt, attendere la serializzazione e strutturare il resto dell'applicazione attorno all'inevitabile penalità di latenza. I progetti di sistema erano ottimizzati per nascondere quel ritardo attraverso indicatori di caricamento, rendering progressivo e pre-fetching speculativo.
A 750 token al secondo, quell'intero paradigma di progettazione diventa obsoleto. I modelli di frontiera non sono più lontani processori batch; sono primitive computazionali sincrone capaci di eseguire complessi ragionamenti simbolici entro i cicli di clock operativi del software aziendale e industriale contemporaneo. Man mano che OpenAI e Cerebras espanderanno l'accesso oltre il gruppo di anteprima iniziale, il vantaggio competitivo si sposterà da chi ha accesso ai pesi più intelligenti a chi saprà progettare sistemi che sfruttano appieno la velocità computazionale grezza e non mitigata.



Comments
No comments yet. Be the first!