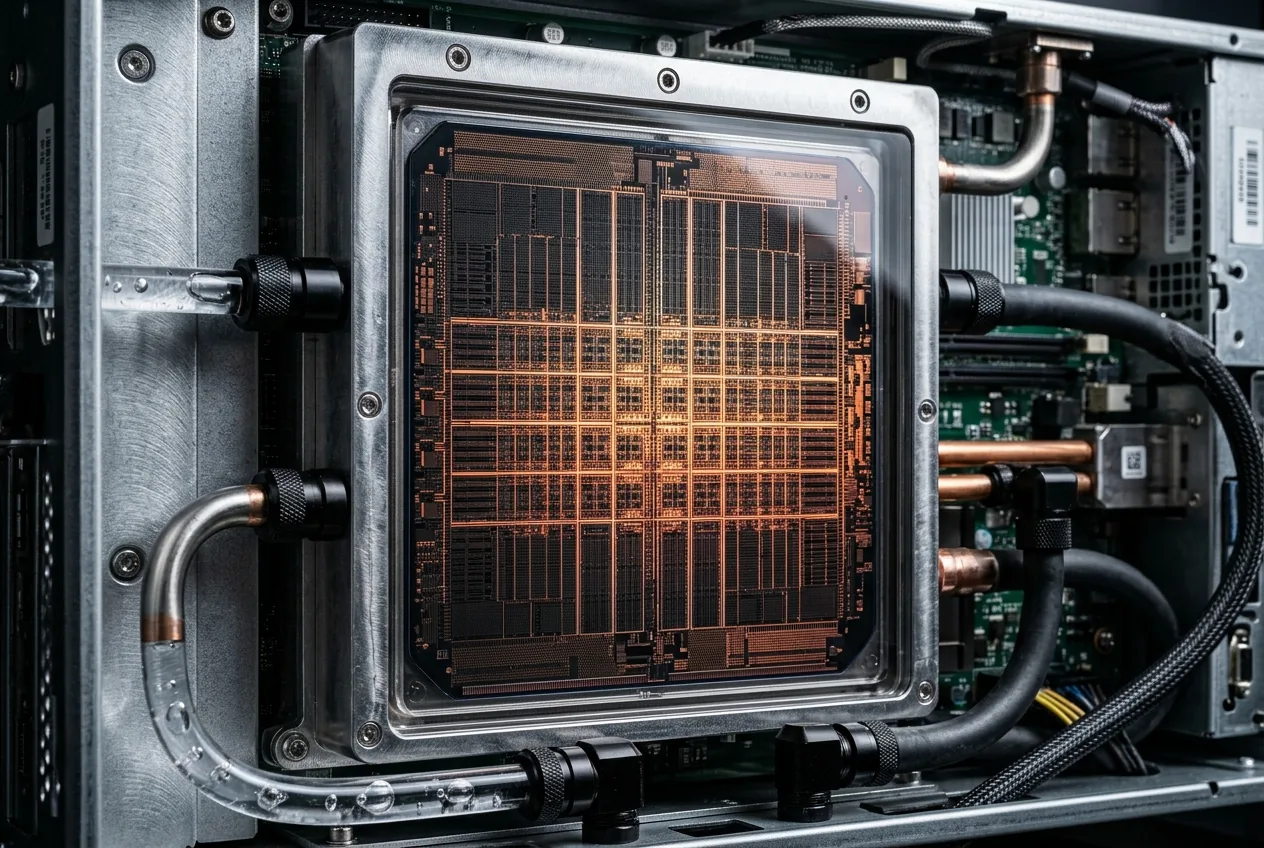
在机器学习基础设施中,模型推理能力与操作延迟之间的张力长期以来就像一条守恒定律:如果你需要实时的确定性响应,就必须通过压缩、量化或蒸馏等手段将其简化为轻量级架构。如果你需要前沿水平的推理能力,就必须接受受内存限制的 GPU 集群所带来的“延迟税”。OpenAI 预览版中为其旗舰模型 GPT-5.6 Sol 推出的“超快模式”(Ultrafast mode)从根本上解决了这一矛盾。该新层级的运行速度最高可达标准生产部署的 14 倍,每秒可生成高达 750 个输出 token,架起了前沿智能与同步化机器速度执行之间的桥梁。
这一发布将技术辩论的重心从原始参数规模转移到了推理吞吐量的机制上。该速度等级并非依赖对现有张量并行服务器机架的增量优化,而是通过与芯片制造商 Cerebras 的直接硬件集成来实现的。每秒 750 个 token 的生成速度将生成式模型从沉思式的回合制系统,转化为能够与高带宽人类对话、量化交易环境和自动化工业控制回路保持同步的连续数据流管道。
克服自回归内存墙
要理解为何 14 倍的速度提升意义重大,必须剖析自回归 token 生成过程中的工程瓶颈。大型语言模型推理在生成阶段并非受限于算力,而是众所周知的内存带宽限制。虽然初始提示词摄入可以在数千个张量核心上对矩阵乘法进行并行化处理,但输出 token 的生成是按顺序进行的:每一个新 token 的产生都需要将整个模型的权重和键值(KV)缓存从内存中读取出来。在由跨 PCIe 总线和 NVLink 交换机连接的离散 GPU 组成的传统集群上,高带宽内存(HBM)堆栈与计算逻辑之间的物理传输时间造成了不可逾越的延迟底线。
对于 GPT-5.6 Sol 这种复杂度的模型而言,在晶圆级架构上执行消除了序列化开销。其结果是一个推理环境,其中的内存传输速度与算术执行速率相匹配。这一结构性转变使得 OpenAI 能够在不剪枝模型层、不将浮点精度降低至不可用水平,也不牺牲上下文理解能力的情况下,实现每秒 750 个 token 的处理速度。
闭合工业和数字系统的控制回路
在机械工程和工业系统中,延迟决定了控制的保真度。一个需要五秒钟才能分析遥测数据的系统无法参与闭环监督控制;它只能被降级为被动的后期日志记录。通过将延迟降低到近乎瞬时的输出,OpenAI 展示了“超快模式”如何实时从描述性文本提示中直接生成功能性、交互式的 3D 仓库模拟。标准的推理层级只能增量地构建环境,在空间计算和资产声明中卡顿;而“超快模式”渲染程序逻辑和空间几何图形的速度,堪比原生图形管线编译代码的速度。
这种速度改变了自主软件与物理和数字资产交互的方式。在 OpenAI 内部,工程团队已将“超快模式”部署到自动化事件响应工作流中。在复杂的生产故障期间,当分布式遥测数据、内存跟踪和错误日志动态变化时,每一秒都决定了故障的影响范围。工程师无需等待漫长的诊断推理周期,超快引擎即可摄入多源遥测数据、构建假设、执行验证脚本并起草纠正补丁,而此时异常还在活跃扩散中。
同样的机制也适用于物理供应链和自动化设施。当机器人集群遇到边缘情况下的抓取失败或空间死锁时,解决轨迹冲突需要综合传感器输入、运动学约束和仓库状态表。一个以每秒 750 个 token 运行的模型可以解析非结构化的故障模式,计算出可行的重新规划路径,并在工业可编程逻辑控制器的标准操作定时阈值内发出纠正指令。
企业压力测试与消除延迟
外部企业合作伙伴的早期访问测试展示了高吞吐量推理如何改变商业软件的设计。量化交易公司 Jane Street 已将“超快模式”层级集成到面向开发人员的编程环境中,消除了传统上在复杂的、多文件代码转换过程中打断程序员思路的延迟屏障。当代码补全和完整的架构重构生成速度快于工程师的浏览速度时,认知回路就不会被中断。
在语音应用中,延迟的改善解决了一个更严苛的结构性约束。通信平台 Podium 将 GPT-5.6 Sol Ultrafast 集成到了他们的生产语音栈中。从历史上看,对话式语音代理必须依赖极其微小且高度专业化的模型,才能将往返响应延迟保持在 500 毫秒以内——这是人类对话感觉流畅与否的阈值。超快模式使开发者能够在音频流循环内运行深度、全参数推理模型,而不会产生对话抖动,使代理能够在没有尴尬停顿的情况下解析复杂查询、交叉引用外部数据库并合成口语响应。
像 Rogo 这样的金融研究平台和像 Basis 这样的工作流自动化公司也报告了类似的结构性转变。复杂的文档汇总、金融建模和确定性工具使用通常会在每次子代理调用时累积延迟。当分析代理必须按顺序调用六个工具时,每一步 10 秒的延迟会使交互式研究变得不可行。在每秒 750 个 token 的速度下,多代理编排可以在几分之一秒内完成其端到端的推理链,将批处理式的数据提取转化为连续的分析对话。
定制晶圆级推理的经济计算
虽然“超快模式”的性能数据代表了不可否认的技术飞跃,但它们也引入了复杂的架构和经济问题。超大规模 AI 市场已在很大程度上整合到由通用 GPU 组成的标准模块化机架架构中。部署晶圆级硅片需要定制的配电系统、定制的液冷回路,以及能够将庞大的计算图映射到整个硅晶圆上而无需标准集群路由的专用编译器工具链。
以 14 倍速度运行前沿模型的资本支出方程完全取决于利用密度。与从标准 300 毫米晶圆切割出的单个模块化芯片相比,晶圆级引擎具有更高的封装和制造复杂性。然而,由于每片晶圆可以替代数十个离散服务器节点,同时每个已生成 token 的总瓦特功耗更低,因此高密度推理的运营支出在规模化时可能会产生有利的转变。如果企业为“超快模式”支付了溢价的 API 层级费用,但该层级消除了员工的闲置时间、整合了计算基础设施,并实现了此前不可能实现的实时产品,那么总拥有成本将大幅转向高吞吐量的硅片方案。
容量限制将决定推广速度。OpenAI 之所以以受限预览层级的形式推出“超快模式”,正是因为晶圆级产能无法在通用的托管设施中一夜之间实现扩容。随着 Cerebras 制造规模的扩大和 OpenAI 专用低延迟集群的建设,每秒 750 个 token 的前沿模型可用性将考验更广泛的技术生态系统是否准备好围绕瞬时生成式智能重建其软件架构。
向同步机器智能的转变
从标准推理速度到“超快模式”的过渡,标志着机器智能被视为异步咨询层的时代终结。在商业深度学习的第一个十年里,软件工程师将神经网络视为远程数据库查询:提交提示词,等待序列化,并围绕不可避免的延迟惩罚来构建应用程序的其余部分。系统设计经过优化,通过加载指示器、渐进式渲染和推测性预取来掩盖这种延迟。
在每秒 750 个 token 的速度下,整个设计范式变得过时了。前沿模型不再是遥远的批处理处理器;它们是能够执行复杂符号推理的同步计算原语,能在现代商业和工业软件的操作时钟周期内运行。随着 OpenAI 和 Cerebras 将访问权限扩展到最初的预览组之外,竞争优势将从谁能拥有最智能的模型权重,转移到谁能设计出充分利用原始、无损计算速度的系统。



Comments
No comments yet. Be the first!