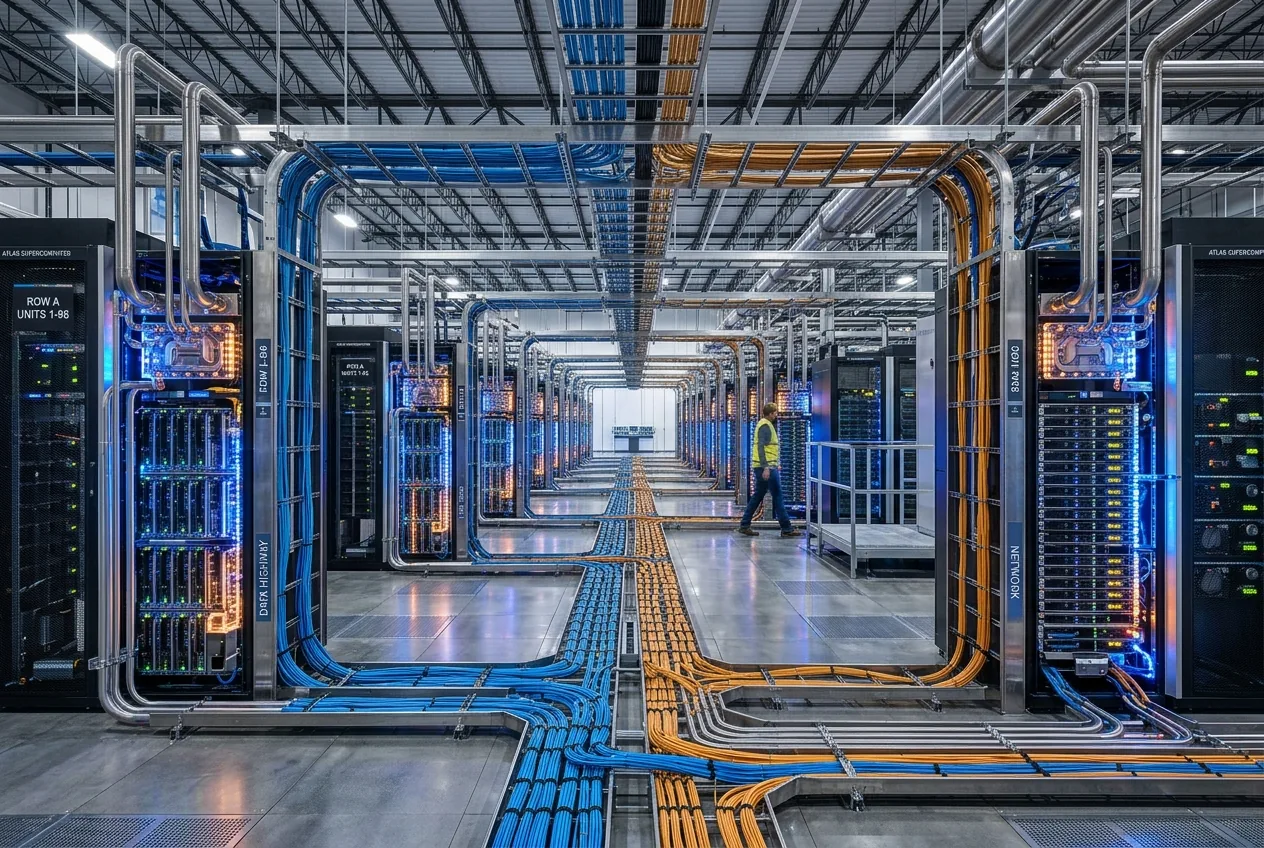
Der Sektor für wegweisende Künstliche Intelligenz hat sich offiziell von klassischen Software-Kennzahlen entkoppelt und ist fest in den Bereich des komplexen Ingenieurwesens und der geopolitischen Industriepolitik übergegangen. Berichte über Anthropic’s beispielloses Streben nach einer Bewertung im fast Billionen-Dollar-Bereich, untermauert durch ein beeindruckendes Kapitalvolumen von 65 Milliarden Dollar, stellen weit mehr dar als nur einen Triumph im Sitzungssaal über den Rivalen OpenAI. Sie signalisieren eine fundamentale Veränderung in der Art und Weise, wie Basismodelle finanziert, konstruiert und physisch mit Energie versorgt werden müssen.
In den letzten drei Jahren konzentrierte sich das Narrativ rund um Large Language Models auf algorithmische Durchbrüche, Innovationen bei synthetischen Trainingsdaten und den Wettlauf um die Beherrschung von Enterprise-Chat-Schnittstellen. Doch hinter der für Endnutzer sichtbaren Software-Schicht gehorchten die zugrunde liegenden Mechanismen schon immer den brutalen Gesetzen der Thermodynamik und der Lieferketten für Halbleiter. Die Beschaffung und der Einsatz von Kapital in dieser astronomischen Größenordnung sind keine Übung in Sachen Marketing-Hype; sie sind ein direktes Abbild der Kosten, die entstehen, um Stromnetze im Gigawatt-Maßstab zu reservieren, dedizierte Kapazitäten für Hochbandbreitenspeicher zu sichern und die Fertigung von Superclustern mit hunderttausenden Beschleunigern zu finanzieren.
Die thermodynamische Realität der Skalierung der nächsten Generation
Um zu verstehen, warum ein Unternehmen Kapitalreserven in zweistelliger Milliardenhöhe benötigt, muss man die physischen Realitäten der aktuellen Trainingscluster betrachten. Die Industrie hat die Effizienzgewinne, die durch einfache Parameterskalierung auf standardisierter Cloud-Infrastruktur möglich waren, faktisch ausgeschöpft. Das Training der für Ende 2025 und 2026 erwarteten Spitzenarchitekturen erfordert Rechencluster, die nicht aus zehntausend GPUs bestehen, sondern auf 100.000 bis 300.000 miteinander verbundene Beschleuniger skalieren.
Bei dieser Dichte verschieben sich die technischen Herausforderungen von der Software-Orchestrierung hin zum mechanischen und elektrischen Anlagendesign. Moderne Architekturen, die auf Hardware wie NVIDIAs Blackwell NVL72 oder maßgeschneiderten Cloud-Beschleunigern wie Amazons Trainium2 basieren, erfordern Flüssigkeitskühlverteiler direkt am Chip, komplexe sekundäre Flüssigkeitskreisläufe und Wärmeabfuhrsysteme, die für thermische Auslegungsleistungen von über 120 Kilowatt pro Rack ausgelegt sind. Luftkühlung ist bei der für eine niedrige Latenz bei verteilter Tensor-Parallelisierung erforderlichen Rechendichte physisch nicht mehr praktikabel.
Darüber hinaus ist das Interconnect-Fabric zum primären Engpass bei der Spitzenrechenleistung geworden. Bei der Verteilung eines autoregressiven Transformers über hunderttausende Knoten bestimmen optische Transceiver, Co-Packaged Optics und proprietäre Switching-Backplanes den Durchsatz weit mehr als rein theoretische Teraflops. Das Kapital, das Anthropic ansammelt, dient als Vorauszahlung, um sich fortschrittliche Packaging-Kapazitäten, maßgeschneiderte Netzwerktopologien und dedizierte Silizium-Fertigungslinien bei Foundries wie TSMC zu sichern, lange bevor das erste Gewicht eines neuen Modells initialisiert wird.
Der strategische Keil zwischen Amazon, Google und Microsoft
Anthropic’s Aufstieg über die Marktreichweite von OpenAI hinaus unterstreicht die sich verschiebenden Dynamiken zwischen den Hyperscalern, die dieses Wettrüsten finanzieren. Während OpenAI durch seine enge Partnerschaft mit Microsoft Azure zunächst einen Vorsprung erzielte, führte diese enge Bindung schließlich zu Reibungspunkten bei der Infrastrukturzuteilung, bei Fragen des geistigen Eigentums und der Hardware-Exklusivität. Anthropic hingegen entwickelte eine Dual-Engine-Architektur, indem es tiefgreifende strategische Allianzen sowohl mit Amazon Web Services als auch mit Google Cloud einging.
Da Unternehmenskunden nach Unabhängigkeit vom „Lock-in“-Effekt einzelner Ökosysteme streben, hat sich Anthropic’s plattformagnostische Haltung zu einem beachtlichen kommerziellen Burggraben entwickelt. Unternehmensentwickler können Claude-Modelle nativ über AWS Bedrock, Google Cloud Vertex AI oder private virtuelle Clouds ausführen, ohne ihre zugrunde liegenden Datenpipelines umbauen zu müssen. Diese breite Einsatzbasis ermöglicht es Anthropic, Unternehmens-Workloads mit weniger Reibungsverlusten zu gewinnen als proprietäre Stacks, die an einen einzigen Infrastrukturanbieter gebunden sind.
Wird Unternehmensautomatisierung Billionen-Dollar-Bilanzen rechtfertigen?
Die zentrale Frage, die sich Hardware-Ingenieuren und Marktanalysten gleichermaßen stellt, ist, ob Unternehmens-Workflows die Umsatzdynamik erzeugen können, die zur Bedienung dieser beispiellosen Kapitalisierung erforderlich ist. Bewertungen, die sich einer Billion Dollar nähern, erfordern hunderte Milliarden an wiederkehrenden, hochmargigen Cashflows – eine Realität, die reine Konsumenten-Abonnements und Chat-Anwendungen nicht stützen können. Das Endziel ist nicht die dialogorientierte Suche; es ist die deterministische industrielle Automatisierung und die durchgängige Aufgabenabwicklung.
Doch der Übergang von experimenteller Desktop-Assistenz hin zu Zuverlässigkeit auf Unternehmensebene erfordert massive systemische Redundanz. Ein autonomer Agent, der in fünf Prozent der Fälle halluziniert oder einen ungültigen API-Aufruf ausführt, ist in geschäftskritischen industriellen oder geschäftlichen Umgebungen grundsätzlich nicht tragfähig. Um diese letzte Zuverlässigkeitslücke zu schließen, sind kontinuierliche Inferenz-Verifizierung, Multi-Agent-Debattenarchitekturen und Reinforcement Learning in Echtzeit erforderlich – Prozesse, die den Rechenverbrauch pro Aufgabe exponentiell vervielfachen. Das heute angehäufte Kapital finanziert direkt die Inferenzkapazität, die erforderlich ist, um diese mehrstufigen autonomen Pipelines in industriellem Maßstab wirtschaftlich rentabel zu machen.
Der Infrastruktur-Engpass verlagert sich auf das Stromnetz
Selbst mit Liquidität in zweistelliger Milliardenhöhe stößt die Wachstumskurve der Spitzen-KI auf eine harte physische Barriere: die Energieinfrastruktur. Kapital kann zwar GPUs kaufen, aber es kann nicht einseitig die fünf- bis siebenjährigen Genehmigungs- und Bauzeiten für regionale Hochspannungsleitungen, Umspannwerke und neue Grundlastkapazitäten verkürzen. Der primäre Wettbewerb hat sich von der Softwareoptimierung hin zu Stromabnahmeverträgen verschoben.
Große Technologiebetreiber sichern sich bereits langfristige Stromabnahmeverträge von Kernkraftwerken, Erdgaskraftwerken mit CO2-Abscheidung und dedizierten Microgrids im Versorgungsmaßstab. Da Rechenzentren der Spitzenklasse einen Strombedarf von einem bis zwei Gigawatt pro Standort erreichen – was dem Strombedarf einer mittelgroßen Stadt entspricht –, wird die Skalierbarkeit zunehmend durch die lokale Stromnetzkapazität und weniger durch Kapitalbeschränkungen rationiert.
Anthropic’s Multi-Cloud- und Multi-Partner-Modell bietet einen entscheidenden Puffer in dieser Energielandschaft. Anstatt sich auf einen einzigen geografischen Knotenpunkt zu verlassen, können Workloads dynamisch über die weltweite Präsenz von Amazon und Google verteilt werden, wobei gestrandete Energie, regionale Kühlvorteile und internationale Netzschwankungen genutzt werden. Die Verwaltung dieses Rechen-Logistiknetzwerks entwickelt sich schnell zu einer ebenso wichtigen operativen Kompetenz wie das Design von Modell-Verlustfunktionen.
Der Anbruch der kapitalintensiven Maschinenintelligenz
Anthropic’s aggressiver Kapitalzuwachs bestätigt, dass die Ära des schlagkräftigen, softwarezentrierten KI-Startups beendet ist. Wir sind in die Phase des Kapitaleinsatzes auf Souveränitätsniveau eingetreten, in der synthetische Intelligenz durch die konsequente Zusammenführung fortschrittlicher Siliziumfertigung, massiver Hochbandbreitenspeicher-Kontingente und industrieller Energieinfrastruktur konstruiert wird.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!