Le secteur de l'intelligence artificielle de pointe s'est officiellement détaché des indicateurs de capital-risque logiciels traditionnels pour basculer résolument dans le domaine du génie civil lourd et de la politique industrielle géopolitique. Les rapports détaillant la poussée sans précédent d'Anthropic vers une valorisation proche du billion de dollars, ancrée par une structure de capital vertigineuse de 65 milliards de dollars, représentent bien plus qu'un simple triomphe en salle de conseil sur son rival OpenAI. Ils signalent une mutation fondamentale dans la manière dont les modèles de fondation doivent être financés, construits et alimentés physiquement.
Au cours des trois dernières années, le récit entourant les grands modèles de langage était centré sur les percées algorithmiques, les innovations en matière de données d'entraînement synthétiques et la course à la capture des interfaces de chat en entreprise. Pourtant, sous la couche logicielle destinée aux consommateurs, les mécanismes sous-jacents ont toujours obéi aux lois brutales de la thermodynamique et des chaînes d'approvisionnement en semi-conducteurs. Lever et déployer des capitaux à cette échelle astronomique n'est pas un exercice de marketing tapageur ; c'est le reflet direct de ce qu'il en coûte de réserver des réseaux électriques à l'échelle du gigawatt, de sécuriser des allocations de conditionnement de mémoire à large bande passante dédiées et de financer la fabrication de superclusters dotés de centaines de milliers d'accélérateurs.
La réalité thermodynamique de la mise à l'échelle de nouvelle génération
Pour comprendre pourquoi toute entreprise nécessite des réserves de capital se chiffrant en dizaines de milliards de dollars, il faut examiner les réalités physiques des clusters d'entraînement de génération actuelle. L'industrie a effectivement épuisé les gains d'efficacité permis par une simple mise à l'échelle des paramètres sur une infrastructure cloud standardisée. L'entraînement des architectures de pointe prévues pour fin 2025 et 2026 exige des clusters de calcul composés non pas de dix mille GPU, mais de clusters dépassant les 100 000 à 300 000 accélérateurs interconnectés.
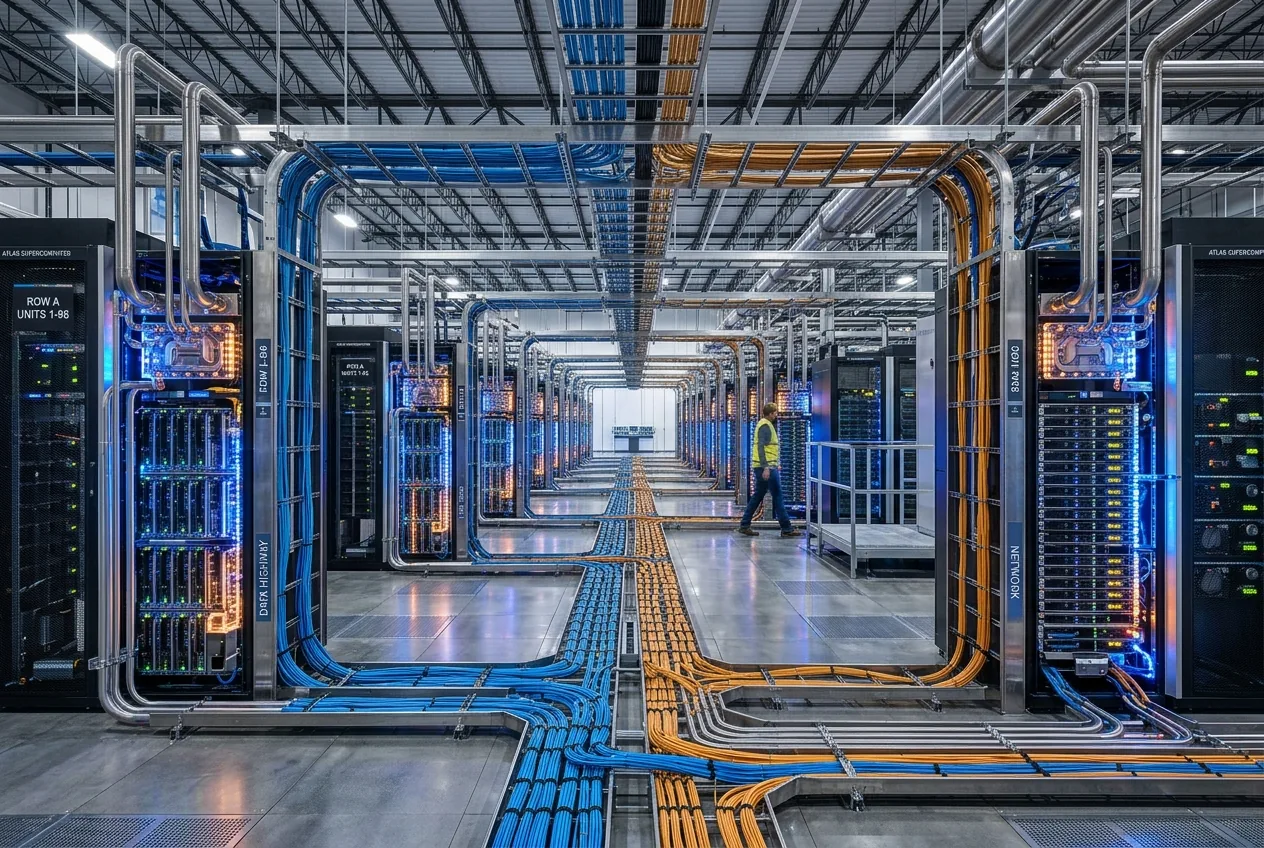
À cette densité, les défis d'ingénierie passent de l'orchestration logicielle à la conception d'installations mécaniques et électriques. Les architectures modernes construites autour de matériels comme le Blackwell NVL72 de NVIDIA ou des accélérateurs cloud sur mesure tels que le Trainium2 d'Amazon nécessitent des collecteurs de refroidissement liquide direct sur puce, des boucles de fluide secondaires sophistiquées et des installations d'évacuation de chaleur capables de gérer des puissances de conception thermique (TDP) dépassant 120 kilowatts par rack. Le refroidissement par air n'est plus physiquement viable aux densités de calcul requises pour maintenir des latences d'interconnexion suffisamment faibles pour le parallélisme tensoriel distribué.
De plus, l'architecture d'interconnexion est devenue le principal goulot d'étranglement du calcul de pointe. Lors de la distribution d'un transformateur autorégressif sur des centaines de milliers de nœuds, les émetteurs-récepteurs optiques, l'optique co-packagée et les fonds de panier de commutation propriétaires dictent le débit bien plus que les téraflops théoriques bruts. Le capital qu'Anthropic accumule sert de prépaiement pour verrouiller la capacité de conditionnement avancé, les topologies réseau personnalisées et les lignes de silicium dédiées dans des fonderies comme TSMC, bien avant que le premier poids d'un nouveau modèle ne soit initialisé.
Le levier stratégique entre Amazon, Google et Microsoft
L'ascension d'Anthropic au-delà de l'empreinte de marché d'OpenAI souligne la dynamique changeante parmi les hyperscalers qui financent cette course aux armements. Alors qu'OpenAI avait initialement pris une avance précoce grâce à son partenariat étroit avec Microsoft Azure, cet alignement a fini par créer des points de friction concernant l'allocation des infrastructures, les limites de propriété intellectuelle et l'exclusivité matérielle. Anthropic, en revanche, a conçu une architecture à double moteur en établissant des alliances stratégiques profondes à la fois avec Amazon Web Services et Google Cloud.
Alors que les entreprises clientes cherchent à s'affranchir du verrouillage d'un écosystème unique, la position agnostique d'Anthropic est devenue un formidable fossé commercial. Les développeurs d'entreprise peuvent exécuter les modèles Claude nativement via AWS Bedrock, Google Cloud Vertex AI ou des clouds virtuels privés sans avoir à restructurer leurs pipelines de données sous-jacents. Cette large surface de déploiement permet à Anthropic de capturer les charges de travail des entreprises avec moins de friction que les piles propriétaires liées à un seul fournisseur d'infrastructure.
L'automatisation en entreprise justifiera-t-elle des bilans à hauteur de mille milliards ?
La question centrale à laquelle sont confrontés les ingénieurs matériels et les analystes de marché est de savoir si les flux de travail des entreprises peuvent générer la vélocité de revenus nécessaire pour soutenir cette capitalisation sans précédent. Des valorisations approchant le billion de dollars exigent des centaines de milliards de flux de trésorerie récurrents à haute marge — une réalité que les simples abonnements grand public et les applications de chat conversationnel ne peuvent pas supporter. Le but ultime n'est pas la recherche conversationnelle ; c'est l'automatisation industrielle déterministe et l'exécution de tâches de bout en bout.
Pourtant, passer de l'agence de bureau expérimentale à une fiabilité de niveau entreprise nécessite une redondance systémique massive. Un agent autonome qui hallucine ou exécute un appel API invalide cinq pour cent du temps est fondamentalement inviable dans des environnements industriels ou d'entreprise critiques. Combler ce dernier fossé de fiabilité nécessite une vérification continue de l'inférence, des architectures de débat multi-agents et un apprentissage par renforcement en temps réel — des processus qui multiplient exponentiellement la consommation de calcul par tâche. Le capital accumulé aujourd'hui finance directement la capacité d'inférence requise pour rendre ces pipelines autonomes multi-étapes économiquement viables à l'échelle industrielle.
Le goulot d'étranglement de l'infrastructure se déplace vers le réseau électrique
Même avec des dizaines de milliards de liquidités, la courbe de croissance de l'IA de pointe se heurte à une barrière physique dure : l'infrastructure énergétique. Le capital peut acheter des GPU, mais il ne peut pas réduire unilatéralement les délais d'autorisation et de construction de cinq à sept ans requis pour les lignes de transport haute tension régionales, les transformateurs abaisseurs de sous-stations et la nouvelle capacité de production en charge de base. Le principal lieu de compétition s'est déplacé de l'optimisation logicielle vers les accords d'achat d'électricité.
Les principaux opérateurs technologiques sécurisent déjà des accords d'achat d'électricité à long terme auprès d'installations nucléaires, de centrales au gaz naturel avec des dispositions de captage du carbone et de micro-réseaux dédiés à l'échelle du service public. À mesure que les centres de données de pointe approchent des consommations électriques d'un à deux gigawatts par campus — équivalent à la demande électrique d'une ville de taille moyenne — la capacité de mise à l'échelle est de plus en plus rationnée par la capacité du réseau électrique local plutôt que par des contraintes de capital.
Le modèle multi-cloud et multi-partenaires d'Anthropic fournit un tampon crucial dans cette géographie de l'énergie. Plutôt que de dépendre d'un seul hub géographique, les charges de travail peuvent être routées dynamiquement sur l'empreinte mondiale d'Amazon et de Google, tirant parti de l'énergie disponible localement, des efficacités de refroidissement régionales et des variations des réseaux internationaux. Gérer ce réseau logistique de calcul devient rapidement une compétence opérationnelle aussi vitale que la conception de fonctions de perte pour les modèles.
L'aube de l'intelligence machine à forte intensité de capital
La poussée agressive de capital d'Anthropic confirme que l'ère de la startup IA centrée sur le logiciel et pleine de débrouillardise est révolue. Nous sommes entrés dans la phase de déploiement de capital à l'échelle souveraine, où l'intelligence synthétique est construite grâce à la convergence par la force brute de la fabrication avancée de silicium, d'allocations massives de mémoire à large bande passante et d'infrastructures énergétiques industrielles.



Comments
No comments yet. Be the first!