前沿人工智能领域已正式与传统的软件风投指标脱钩,稳步跨入了重型土木工程和地缘政治产业政策的领域。有报道详细披露了Anthropic在650亿美元资本框架的支持下,正以前所未有的势头冲击近万亿美元的估值,这不仅仅是其在董事会层面对竞争对手OpenAI的一次胜利,更标志着基础模型在融资、构建和物理供能方式上的根本性变革。
在过去三年中,围绕大语言模型的叙事主要集中在算法突破、合成训练数据创新以及争夺企业聊天界面市场份额上。然而,在面向消费者的软件层之下,底层机制始终遵循着热力学和半导体供应链的残酷规律。以如此天文数字规模募集和部署资本,并非营销炒作,而是预留吉瓦级电网、锁定专用高带宽内存(HBM)封装产能,以及承销数十万个加速器组成的超级集群制造所需的直接成本体现。
下一代扩展的热力学现实
要理解为何任何企业都需要以数百亿美元计的资本储备,就必须审视当前一代训练集群的物理现实。工业界实际上已经耗尽了通过在标准化云基础设施上进行简单参数扩展所能带来的效率增益。训练预计于2025年末和2026年推出的前沿架构,所需的计算集群不再是万余块GPU,而是扩展至10万至30万个互联加速器的超大规模集群。
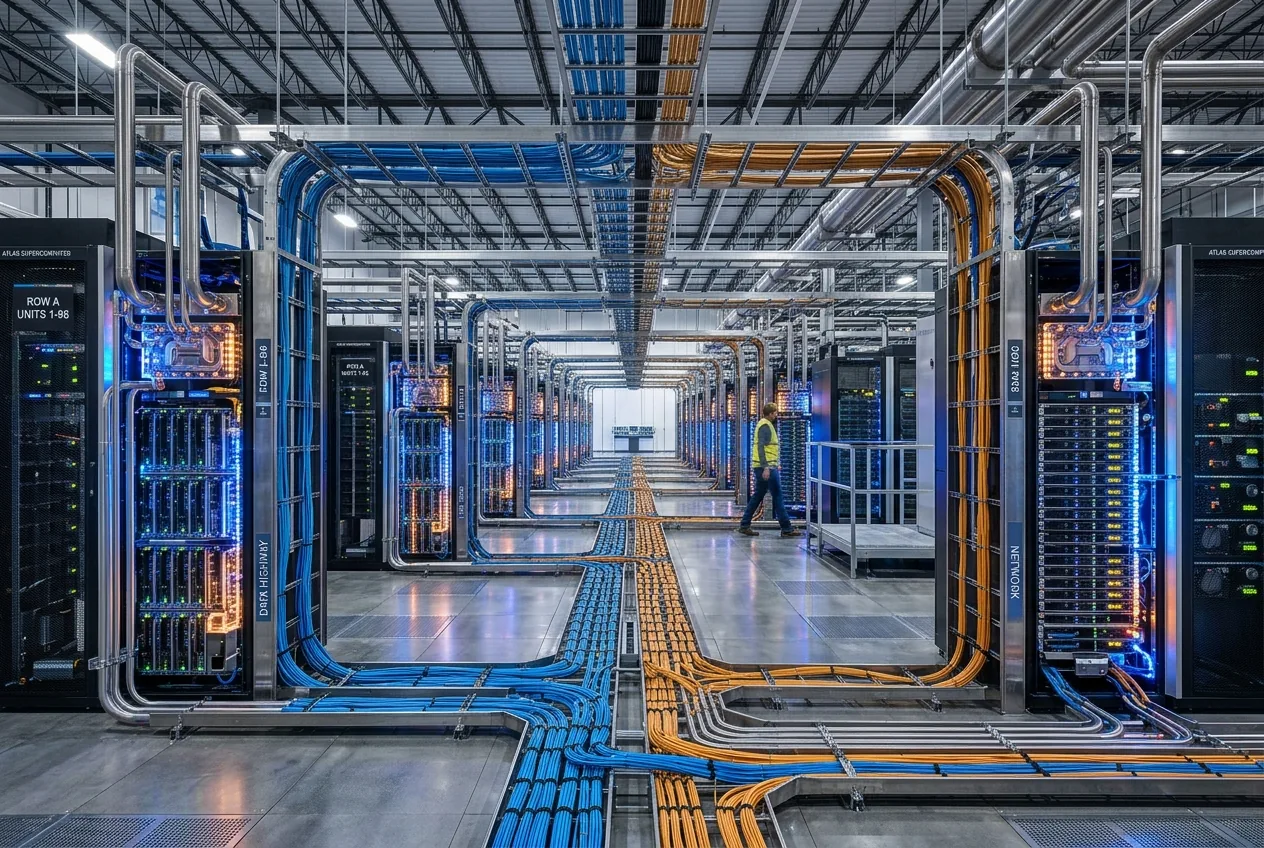
在这种密度下,工程挑战已从软件编排转向了机械和电力工厂设计。围绕NVIDIA的Blackwell NVL72等硬件,或Amazon的Trainium2等定制云加速器构建的现代架构,需要芯片直冷式液冷歧管、复杂的二次流体回路,以及能够处理每机架超过120千瓦散热设计功耗(TDP)的排热设施。在保持分布式张量并行所需的低互联延迟的计算密度下,风冷已不再具备物理可行性。
此外,互联架构已成为前沿计算的主要瓶颈。当将自回归Transformer模型分布在数十万个节点上时,光收发器、共封装光学器件(CPO)和专有交换背板对吞吐量的影响,远超原始理论浮点运算能力(TFLOPS)。Anthropic正在积聚的资本,实际上是在新模型初始权重生成前,为锁定先进封装产能、定制化网络拓扑以及TSMC等晶圆代工厂的专用硅片生产线所支付的预付款。
Amazon、Google和Microsoft之间的战略楔子
Anthropic的市场影响力超越OpenAI,凸显了为这场军备竞赛提供资金的超大规模云服务商(Hyperscalers)之间动态关系的转变。虽然OpenAI通过与Microsoft Azure的深度合作取得了先发优势,但这种紧密的协同最终在基础设施分配、知识产权界限和硬件排他性方面产生了摩擦。相比之下,Anthropic通过与Amazon Web Services和Google Cloud建立深度战略联盟,设计出了一套双引擎架构。
随着企业客户寻求摆脱单一生态系统的锁定,Anthropic的平台无关立场已转化为一条强大的商业护城河。企业开发者可以在AWS Bedrock、Google Cloud Vertex AI或私有虚拟云上原生运行Claude模型,而无需重构其底层数据流水线。这种广泛的部署面使Anthropic能够以比绑定单一基础设施提供商的专有技术栈更低的阻力,捕获企业工作负载。
企业自动化能否支撑万亿美元资产负债表?
硬件工程师和市场分析师共同面临的核心问题是,企业工作流能否产生足够的收入增速来支撑如此前所未有的资本化进程。接近万亿美元的估值需要数千亿美元的经常性高利润现金流——这是纯粹的消费者订阅和对话式聊天应用无法支撑的现实。终局目标并非对话式搜索,而是确定性的工业自动化和端到端的任务执行。
然而,从实验性的桌面代理迈向企业级可靠性需要大规模的系统冗余。一个在5%的情况下会产生幻觉或执行无效API调用的自主智能体,在关键任务的工业或企业环境中根本无法应用。弥合这一最终可靠性差距需要持续的推理验证、多智能体辩论架构以及实时强化学习——这些过程会使单任务计算消耗呈指数级增长。当今筹集的资本正直接用于资助实现这些多步骤自主流水线在工业规模上实现经济可行性所需的推理能力。
基础设施瓶颈转向电网
即使拥有数百亿美元的流动性,前沿AI的增长曲线也正在撞上一道坚硬的物理壁垒:能源基础设施。资本可以购买GPU,但无法单方面压缩区域性高压输电线路、变电站降压变压器和新建基荷发电能力所需的5到7年审批与建设周期。竞争的主要阵地已从软件优化转向了电力采购协议(PPA)。
大型技术运营商已经开始从核电设施、具备碳捕集能力的天然气工厂以及专用的公用事业级微电网中锁定长期购电协议。随着前沿数据中心单园区的电力需求接近1至2吉瓦——相当于中型大都市的电力需求——扩展能力正日益受到当地电网容量而非资本约束的配额限制。
Anthropic的多云、多合作伙伴模式在这种能源地理格局中提供了一个关键的缓冲。工作负载无需依赖单一的地理中心,而是可以在Amazon和Google的全球足迹中动态路由,从而利用闲置电力、区域制冷效率和国际电网差异。管理这种计算物流网络正迅速成为与设计模型损失函数同等重要的运营能力。
资本密集型机器智能的曙光
Anthropic激进的资本扩张证实,以软件为中心的草根AI创业时代已经结束。我们已进入主权规模的资本部署阶段,在这种阶段,合成智能是通过先进硅片制造、大规模高带宽内存分配和工业能源基础设施的暴力收敛而构建的。



Comments
No comments yet. Be the first!