Auf dem hochkarätig besetzten Schauplatz der Frontier-KI bringt jedes bevorstehende Bereitstellungsfenster eine Flut von internen Leaks, strategischen Aussagen der Geschäftsführung und intensiven Prüfungen von Benchmarks mit sich. Während OpenAI auf seinen Release-Zyklus zur Jahresmitte zusteuert, haben öffentliche Äußerungen der Führungsebene, darunter Chief Scientist Jakub Pachocki, neue Diskussionen in der Unternehmens- und Ingenieurlandschaft entfacht. Die Erwartungen an den nächsten großen architektonischen Meilenstein von OpenAI beziehen sich nicht mehr nur auf die flüssige Konversation; sie konzentrieren sich darauf, ob die Organisation rohe Rechenleistung in deterministische, hochzuverlässige Ausführungen für komplexe Arbeitsabläufe in der realen Welt umwandeln kann.
Für Unternehmensingenieure und Architekten industrieller Systeme ist das Versprechen eines bedeutenden Sprungs an spezifische operative Kriterien geknüpft. Generative Modelle haben in den letzten drei Jahren bemerkenswerte allgemeine sprachliche Fähigkeiten bewiesen, scheiterten jedoch durchweg bei der Integration in enge Feedbackschleifen, die eine strikte Einhaltung physikalischer Zwänge, eine fehlerfreie Verifizierung und eine zuverlässige mehrstufige Planung erfordern. Wenn die kommende Architektur einen echten Generationswechsel darstellt, müssen die technischen Fortschritte weit über größere Kontextfenster und synthetische Text-Benchmark-Werte hinausgehen.
Der Übergang vom Brute-Force-Pretraining zum vereinheitlichten Test-Time Compute
Das Standardparadigma der autoregressiven Next-Token-Vorhersage, das den Fortschritt von GPT-3 bis zu den GPT-4-Varianten bestimmte, ist auf gut dokumentierte thermodynamische und algorithmische abnehmende Erträge gestoßen. Das Pretraining von Billionen-Parameter-Modellen mit statischen Internetdaten führt zu zunehmend marginalen Verbesserungen der logischen Konsistenz, während gleichzeitig die Investitionsausgaben, der Stromverbrauch und der Aufwand für das Wärmemanagement exponentiell steigen. Interne Durchbrüche der letzten zwölf Monate, katalysiert durch die Integration von gezieltem Test-Time Compute und bestärkendem Lernen (Reinforcement Learning) über Gedankengänge (Chains of Thought), haben die Entwicklung der KI effektiv in neue Bahnen gelenkt.
Die technische Herausforderung liegt darin, die Inferenzlatenz gegen die Tiefe der Verifizierungssuche abzuwägen. Bei Konversationsschnittstellen ist eine fünfsekündige Pause, während das Modell eine Abfrage durchdenkt, akzeptabel; in autonomen Fertigungslinien, bei der Routenplanung von Lagerrobotern oder bei algorithmischen Verhandlungen in der Lieferkette erfordern solche Latenzprofile eine präzise programmatische Steuerung. Industriekunden werden genau darauf achten, ob das neue Modell eine fein abgestimmte Kontrolle über Rechenbudgets ermöglicht, sodass Ingenieure je nach Kritikalität der Aufgabe exakt festlegen können, wie viel Suchzeit zugewiesen wird.
Engpässe bei der Recheninfrastruktur und Realitäten der Halbleiterindustrie
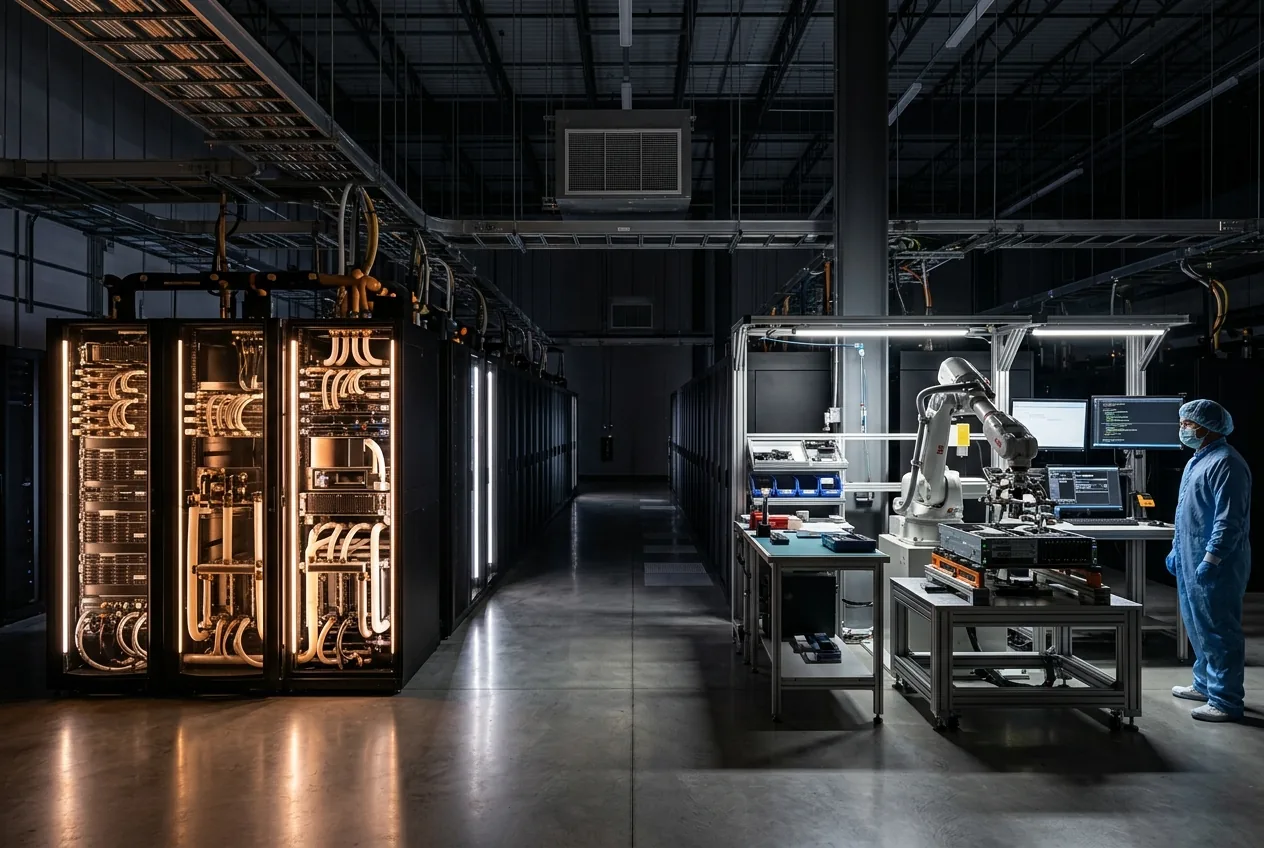
Hinter den Software-Benchmarks verbirgt sich die schiere physische Realität der Datacenter-Technik im Gigawatt-Maßstab. Das Training und der Betrieb einer Architektur, die als bedeutender Generationssprung gilt, erfordern gewaltige Cluster aus High-Bandwidth Memory (HBM) und spezialisierter Beschleuniger-Hardware, primär Nvidias Hopper- und die aufkommenden Blackwell-Plattformen. Die Betriebskosten dieser Bereitstellungen zwingen KI-Entwickler dazu, sich mit der Physik von Rechenzentrums-Interconnects, Flüssigkeitskühlungsinfrastrukturen und den Kapazitätsgrenzen regionaler Stromnetze auseinanderzusetzen.
Um eine nachhaltige Wirtschaftlichkeit bei einer breiten kommerziellen Veröffentlichung aufrechtzuerhalten, kann OpenAI die Parameteranzahl nicht einfach ungebremst skalieren. Moderne Systemtechnik schreibt eine aggressive Parameteroptimierung vor, die wahrscheinlich Mixture-of-Experts (MoE)-Topologien nutzt, welche nur einen gezielten Bruchteil der Gewichte für ein gegebenes Token aktivieren, kombiniert mit Destillationstechniken nach dem Training. Wenn das kommende Modell überlegene Reasoning-Benchmarks erreicht und dabei eine diszipliniertere Speicherauslastung aufweist, wird dies signalisieren, dass architektonische Verfeinerung statt Brute-Force-Skalierung wieder im Mittelpunkt der Frontier-KI-Forschung steht.
Darüber hinaus hängt die Akzeptanz in Unternehmen von der Wirtschaftlichkeit der Inferenz ab. Der Unternehmenssektor ist vorsichtig geworden gegenüber fragilen APIs mit variabler Preisgestaltung und schwankenden Antwortlatenzen. Industriekunden mit hohem Volumen benötigen eine vorhersehbare Token-Preisgestaltung und deterministische Service-Level-Agreements, um die Ablösung herkömmlicher deterministischer Software zugunsten probabilistischer Basismodelle zu rechtfertigen. Die Tragfähigkeit dieser kommenden Veröffentlichung wird sowohl in der Unternehmensbilanz als auch an akademischen Evaluationssets gemessen werden.
Überbrückung der digitalen Reasoning-Lücke für die physische Robotik
Das wahre Testfeld für diese nächste Generation der künstlichen Intelligenz ist nicht die Codegenerierung oder Marketingtexte, sondern die physische Welt. Seit Jahren kämpft der Robotiksektor mit der grundlegenden Kluft zwischen semantischem Reasoning auf hoher Ebene und der motorischen Betätigung auf niedriger Ebene. Traditionelle robotergestützte Prozessautomatisierung zeichnet sich durch die Ausführung repetitiver Bewegungsabläufe mit Sub-Millimeter-Präzision aus, versagt aber vollständig, wenn eine Umgebung von der geplanten Vorhersehbarkeit abweicht.
Ein Frontier-Modell, das zu robuster räumlicher Wahrnehmung, kausalem Denken und selbstkorrigierender Aufgabenzerlegung fähig ist, stellt das fehlende Glied in der autonomen Manipulation und mobilen Robotik dar. Wenn ein Industrieroboter in einer Fabrikhalle auf ein unerwartetes Hindernis oder in einer Montagezelle auf eine nicht modellierte Teilorientierung trifft, kann er sich nicht auf vage Wahrscheinlichkeitsverteilungen verlassen. Er benötigt eine kognitive Schicht, die physikalische Hypothesen formulieren, räumliche Abstände verifizieren und innerhalb von Millisekunden sichere kinematische Pläne erstellen kann. Sollte die kommende Architektur von OpenAI eine anhaltende zeitliche Konsistenz und rigoroses physikalisches Reasoning beweisen, wird sie umgehend zur grundlegenden Betriebsebene für die nächste Generation automatisierter fahrerloser Transportsysteme und Zweiarm-Manipulationsplattformen werden.
Diese Konvergenz von Basismodellen mit physischen Steuerungssystemen verschiebt auch die Last der Verifizierung. In der Softwareentwicklung führt eine fehlerhafte Token-Ausgabe zu einem Compilerfehler oder einer unbehandelten Ausnahme; in einer Industriezelle kann eine nicht verifizierte Aktion zu einer katastrophalen mechanischen Kollision oder zu Verletzungen von Menschen führen. Folglich werden die Luft- und Raumfahrt- sowie die Fertigungsindustrie die Zuverlässigkeitsversprechen von OpenAI einer rigorosen empirischen Belastungsprobe unterziehen, bevor sie eine autonome Integration freigeben.
Unternehmenszuverlässigkeit statt Silicon-Valley-Benchmarks
Die Technologiebranche feiert seit zwei Jahren inkrementelle Benchmark-Triumphe, die den Kontakt mit der Unternehmensrealität häufig nicht überstehen. Synthetische Tests wie MMLU und HumanEval sind zwar nützlich für akademische Vergleichsrankings, wurden jedoch zunehmend kontaminiert und von chaotischen operativen Umgebungen entkoppelt. Führungskräfte in Unternehmen bewerten Modelle heute anhand unnachgiebiger Metriken: Halluzinationsraten bei der Verarbeitung unternehmenskritischer Dokumente, deterministische Werkzeugnutzung über APIs und Einhaltung strenger operativer Protokolle ohne Abweichungen.
Damit OpenAI das Versprechen eines transformativen Sprungs einlösen kann, muss die neue Architektur das Problem des stillen Versagens lösen. Wenn ein Modell auf mehrdeutige Anweisungen oder eine unmögliche Reihe von Einschränkungen stößt, muss es zuverlässig seine eigenen kognitiven Grenzen erkennen und um Klärung bitten, anstatt selbstbewusst eine plausible Unwahrheit zu generieren. Diese Selbstkalibrierung ist die Grundvoraussetzung für den Einsatz autonomer Agenten in regulierten Sektoren wie dem Lieferkettenmanagement, der medizinischen Diagnostik und der Rechtsanalyse.
Während das erwartete Startfenster im Sommer näher rückt, bereitet sich die gesamte Branche auf einen Realitätscheck vor. Die Wettbewerbslücke zwischen proprietären Frontier-Laboren und hochkarätigen Open-Weights-Modellen hat sich im vergangenen Jahr deutlich verringert. Um seine Premium-Positionierung zu rechtfertigen und seine kommerzielle Dynamik aufrechtzuerhalten, muss die nächste Bereitstellung von OpenAI demonstrieren, dass seine bewussten Reasoning-Paradigmen und architektonischen Verfeinerungen in einen unbestreitbaren wirtschaftlichen Nutzen sowohl in der physischen als auch in der digitalen Wirtschaft übersetzt werden.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!