Dans l'arène aux enjeux élevés de l'intelligence artificielle de pointe, chaque fenêtre de déploiement imminente s'accompagne d'un flot de fuites internes, de déclarations stratégiques des dirigeants et d'un examen minutieux des benchmarks. Alors qu'OpenAI s'oriente vers son cycle de publication de mi-année, les remarques publiques de la direction, notamment celles du Chief Scientist Jakub Pachocki, ont déclenché de nouvelles discussions dans les écosystèmes d'entreprise et d'ingénierie. L'anticipation entourant le prochain jalon architectural majeur d'OpenAI ne porte plus seulement sur la fluidité conversationnelle ; elle se concentre sur la capacité de l'organisation à convertir une mise à l'échelle computationnelle brute en une exécution déterministe et hautement fiable pour des flux de travail complexes en conditions réelles.
Pour les ingénieurs d'entreprise et les architectes de systèmes industriels, la promesse d'un bond en avant significatif implique des critères opérationnels précis. Ces trois dernières années, les modèles génératifs ont démontré des capacités linguistiques générales remarquables, mais ils ont systématiquement échoué lorsqu'ils ont été intégrés dans des boucles de rétroaction serrées exigeant un respect rigoureux des contraintes physiques, une vérification zéro défaut et une planification fiable en plusieurs étapes. Si l'architecture à venir représente une véritable transition générationnelle, les avancées techniques devront aller bien au-delà des fenêtres de contexte plus larges et des scores sur les benchmarks de texte synthétique.
La transition du préentraînement par force brute vers le calcul unifié au moment de l'inférence
Le paradigme standard de la prédiction autorégressive du jeton suivant, qui a régi la progression de GPT-3 jusqu'aux variantes de GPT-4, s'est heurté à des rendements décroissants thermodynamiques et algorithmiques bien documentés. Le préentraînement de modèles à mille milliards de paramètres sur des données Internet statiques génère des améliorations marginales de la cohérence logique tout en entraînant des augmentations exponentielles des dépenses en capital, de la consommation électrique et des coûts de gestion thermique. Les percées internes de ces douze derniers mois, catalysées par l'intégration d'un calcul délibéré au moment de l'inférence et d'un apprentissage par renforcement sur des chaînes de pensée, ont effectivement modifié la trajectoire du développement de l'IA.
Le défi d'ingénierie réside dans l'équilibre entre la latence d'inférence et la profondeur de la recherche de vérification. Dans les interfaces conversationnelles, une pause de cinq secondes pendant que le modèle raisonne sur une requête est acceptable ; dans les lignes de fabrication autonomes, le routage robotique en entrepôt ou la négociation algorithmique de la chaîne d'approvisionnement, de tels profils de latence exigent un contrôle programmatique précis. Les consommateurs industriels examineront de près si le nouveau modèle offre un contrôle granulaire sur les budgets de calcul, permettant aux ingénieurs de dicter exactement combien de temps de recherche est alloué en fonction de la criticité de la tâche.
Goulots d'étranglement de l'infrastructure de calcul et réalités du silicium
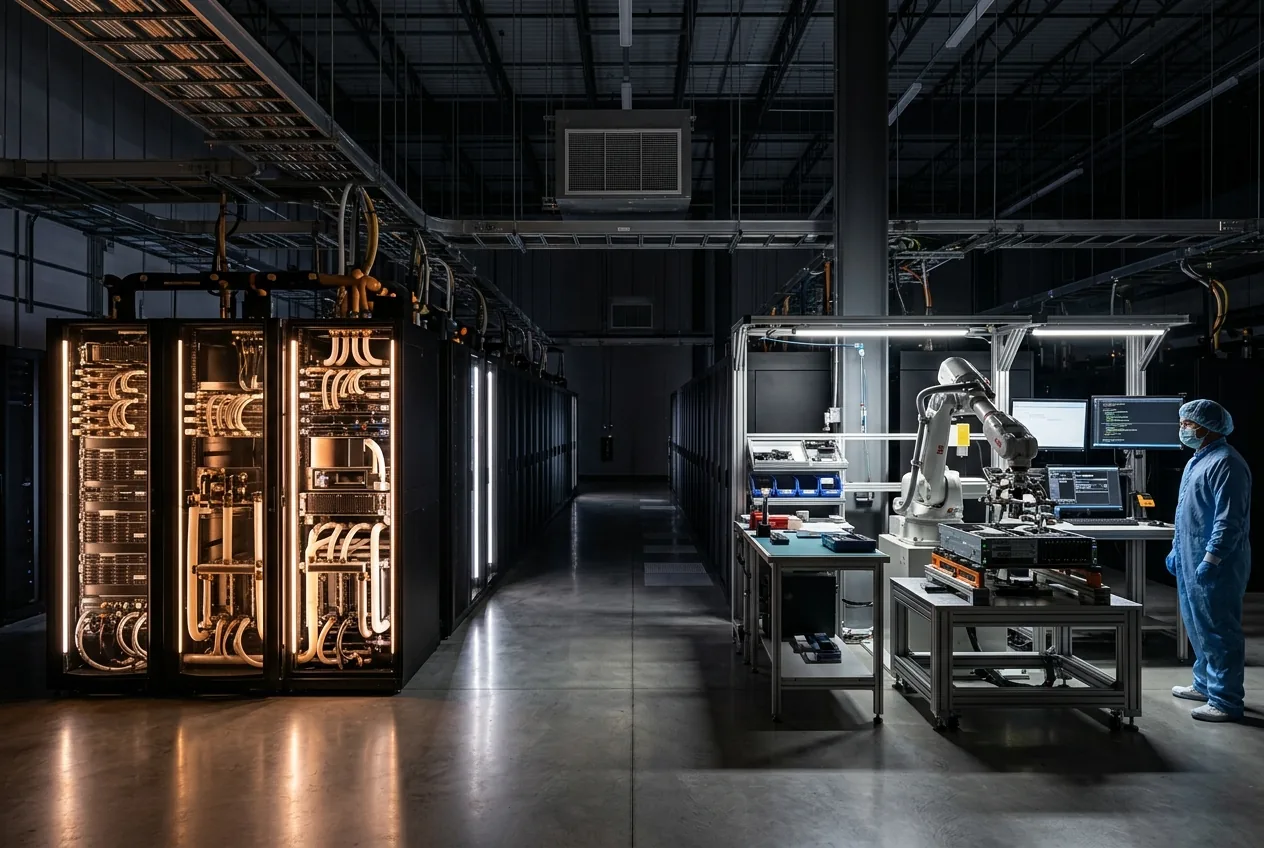
Derrière les benchmarks logiciels se cache la réalité physique pure de l'ingénierie des centres de données à l'échelle du gigawatt. Entraîner et servir une architecture considérée comme un saut générationnel significatif nécessite des clusters stupéfiants de mémoire à large bande passante (HBM) et de matériel accélérateur spécialisé, principalement les plateformes Hopper et les naissantes Blackwell de Nvidia. Le coût opérationnel de ces déploiements force les développeurs d'IA à compter avec la physique des interconnexions des centres de données, l'infrastructure de refroidissement liquide et les contraintes des réseaux électriques régionaux.
Pour maintenir une économie unitaire durable lors d'une large diffusion commerciale, OpenAI ne peut pas simplement mettre à l'échelle le nombre de paramètres sans contrôle. L'ingénierie système moderne impose une optimisation agressive des paramètres, exploitant probablement des topologies de type « mixture-of-experts » (MoE) qui n'activent qu'une fraction ciblée de poids pour tout jeton donné, combinée à des techniques de distillation post-entraînement. Si le modèle à venir atteint des benchmarks de raisonnement supérieurs tout en fonctionnant avec une empreinte mémoire plus disciplinée, cela signifiera que le raffinement architectural, plutôt que la mise à l'échelle par force brute, a repris le devant de la scène dans la recherche en IA de pointe.
En outre, l'adoption par les entreprises dépend de l'économie de l'inférence. Le secteur des entreprises est devenu méfiant vis-à-vis des API fragiles aux prix variables et aux latences de réponse fluctuantes. Les clients industriels à haut volume exigent une tarification prévisible des jetons et des accords de niveau de service déterministes pour justifier le remplacement des logiciels déterministes existants par des modèles de fondation probabilistes. La viabilité de cette prochaine version sera mesurée aussi bien au bilan comptable de l'entreprise que sur les ensembles d'évaluation académiques.
Combler le vide du raisonnement numérique pour la robotique physique
Le véritable terrain d'essai pour cette prochaine génération d'intelligence artificielle n'est pas la génération de code ou le marketing, mais le monde physique. Pendant des années, le secteur de la robotique a lutté contre le fossé fondamental entre le raisonnement sémantique de haut niveau et l'actionnement moteur de bas niveau. L'automatisation traditionnelle des processus robotiques excelle dans l'exécution de trajectoires répétitives avec une précision sub-millimétrique, mais elle échoue complètement lorsqu'un environnement s'écarte de la prévisibilité conçue.
Un modèle de pointe capable de perception spatiale robuste, de raisonnement causal et de décomposition de tâches avec autocorrection représente le chaînon manquant de la manipulation autonome et de la robotique mobile. Lorsqu'un robot industriel rencontre un obstacle inattendu sur un sol d'usine ou une orientation de pièce non modélisée dans une cellule d'assemblage, il ne peut pas se fier à de vagues distributions de probabilités. Il nécessite une couche cognitive capable de formuler des hypothèses physiques, de vérifier les dégagements spatiaux et de générer des plans cinématiques sûrs en quelques millisecondes. Si l'architecture à venir d'OpenAI démontre une cohérence temporelle soutenue et un raisonnement physique rigoureux, elle deviendra immédiatement la couche opérationnelle fondamentale pour les véhicules guidés automatisés et les plateformes de manipulation à double bras de nouvelle génération.
Cette convergence des modèles de fondation avec les systèmes de contrôle physique déplace également la charge de la vérification. Dans le développement de logiciels, une sortie de jeton erronée entraîne une erreur de compilation ou une exception non gérée ; dans une cellule industrielle, une action non vérifiée peut entraîner une collision mécanique catastrophique ou des blessures humaines. Par conséquent, les secteurs de l'aérospatiale et de la fabrication soumettront les affirmations de fiabilité d'OpenAI à des tests de résistance empiriques rigoureux avant d'autoriser toute intégration autonome.
La fiabilité de l'entreprise face aux benchmarks de la Silicon Valley
L'industrie technologique a passé les deux dernières années à célébrer des triomphes incrémentaux sur les benchmarks qui échouent fréquemment à survivre au contact de la réalité des entreprises. Les tests synthétiques comme MMLU et HumanEval, bien qu'utiles pour le classement académique comparatif, sont devenus de plus en plus contaminés et déconnectés des environnements opérationnels complexes. Les dirigeants technologiques des entreprises évaluent désormais les modèles par rapport à des mesures inflexibles : taux d'hallucination dans le traitement de documents critiques, utilisation déterministe d'outils via API et respect de protocoles opérationnels stricts sans dérive.
Pour qu'OpenAI tienne sa promesse d'un bond en avant transformateur, l'architecture entrante doit résoudre le problème de la défaillance silencieuse. Lorsqu'un modèle rencontre des instructions ambiguës ou un ensemble de contraintes impossibles, il doit reconnaître de manière fiable ses propres limites cognitives et demander des clarifications, plutôt que de générer avec assurance une fausseté plausible. Cette auto-étalonnage est l'exigence de base pour déployer des agents autonomes dans des secteurs réglementés tels que la gestion de la chaîne d'approvisionnement, le diagnostic médical et l'analyse juridique.
Alors que la fenêtre de lancement prévue cet été approche, l'ensemble de l'industrie se prépare à une confrontation avec la réalité. L'écart concurrentiel entre les laboratoires propriétaires de pointe et les modèles à poids ouverts de haut calibre s'est considérablement réduit au cours de l'année écoulée. Pour justifier sa gamme premium et maintenir son élan commercial, le prochain déploiement d'OpenAI doit démontrer que ses paradigmes de raisonnement délibéré et ses raffinements architecturaux se traduisent par une utilité économique indiscutable dans les économies physiques et numériques.



Comments
No comments yet. Be the first!