Nel teatro ad alta posta in gioco dell'intelligenza artificiale di frontiera, ogni imminente finestra di rilascio porta con sé un turbinio di fughe di notizie interne, dichiarazioni strategiche dei dirigenti e un intenso scrutinio dei benchmark. Mentre OpenAI manovra verso il suo ciclo di rilascio di metà anno, le osservazioni pubbliche della leadership, incluso il Chief Scientist Jakub Pachocki, hanno acceso nuove discussioni nel panorama aziendale e ingegneristico. L'attesa che circonda il prossimo importante traguardo architetturale di OpenAI non riguarda più solo la fluidità conversazionale; si concentra sulla capacità dell'organizzazione di convertire il calcolo computazionale grezzo in un'esecuzione deterministica ad alta affidabilità per complessi flussi di lavoro nel mondo reale.
Per gli ingegneri aziendali e gli architetti di sistemi industriali, la promessa di un salto significativo comporta criteri operativi specifici. Negli ultimi tre anni, i modelli generativi hanno dimostrato notevoli capacità linguistiche generali, ma hanno costantemente fallito quando integrati in stretti cicli di feedback che richiedono una rigida adesione a vincoli fisici, una verifica a zero difetti e una pianificazione multi-step affidabile. Se l'architettura in arrivo rappresenta un autentico passaggio generazionale, i progressi tecnici devono estendersi ben oltre finestre di contesto più ampie e punteggi nei benchmark di testo sintetico.
La transizione dal pre-addestramento a forza bruta al calcolo unificato in fase di test
Il paradigma standard della previsione autoregressiva del token successivo, che ha guidato l'evoluzione da GPT-3 attraverso le varianti di GPT-4, si è scontrato con rendimenti decrescenti termodinamici e algoritmici ben documentati. Il pre-addestramento di modelli con trilioni di parametri su dati internet statici produce miglioramenti progressivamente marginali nella coerenza logica, comportando al contempo incrementi esponenziali nelle spese in conto capitale, nel consumo di energia elettrica e negli oneri di gestione termica. Le scoperte interne degli ultimi dodici mesi, catalizzate dall'integrazione di un calcolo deliberato in fase di test (test-time compute) e dall'apprendimento per rinforzo su catene di pensiero (chains of thought), hanno effettivamente alterato la traiettoria dello sviluppo dell'IA.
La sfida ingegneristica risiede nel bilanciare la latenza di inferenza con la profondità della ricerca di verifica. Nelle interfacce conversazionali, una pausa di cinque secondi mentre il modello ragiona su una query è accettabile; nelle linee di produzione autonome, nell'instradamento robotico dei magazzini o nella negoziazione algoritmica della catena di approvvigionamento, tali profili di latenza richiedono un preciso controllo programmatico. I consumatori industriali osserveranno attentamente se il nuovo modello offrirà un controllo granulare sui budget di calcolo, consentendo agli ingegneri di stabilire esattamente quanto tempo di ricerca allocare in base alla criticità dell'attività.
Colli di bottiglia dell'infrastruttura di calcolo e realtà del silicio
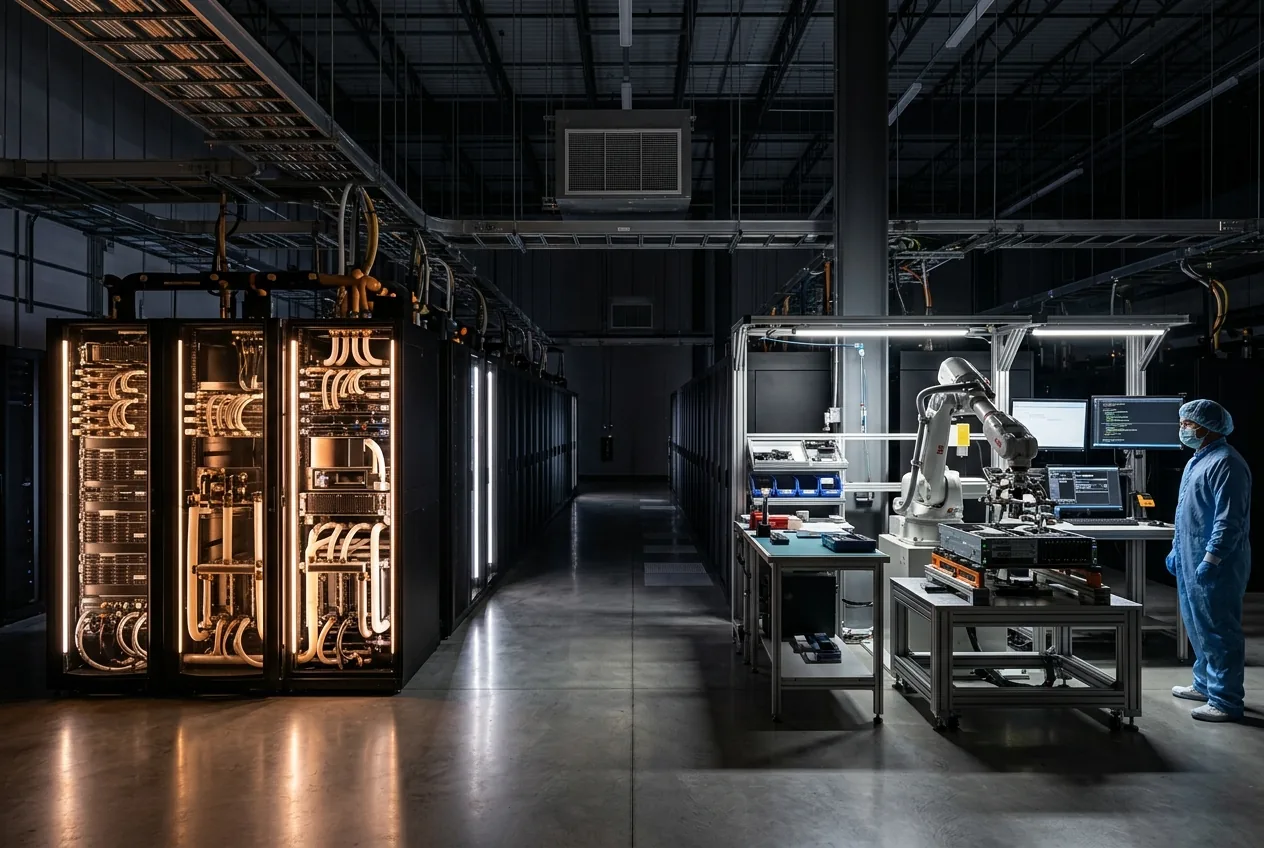
Dietro i benchmark software si cela la pura realtà fisica dell'ingegneria dei data center su scala gigawatt. Addestrare e servire un'architettura considerata un significativo salto generazionale richiede cluster sbalorditivi di memoria a larghezza di banda elevata (HBM) e hardware acceleratore specializzato, principalmente le piattaforme Hopper e le nascenti Blackwell di Nvidia. Il costo operativo di queste implementazioni sta costringendo gli sviluppatori di IA a fare i conti con la fisica delle interconnessioni dei data center, le infrastrutture di raffreddamento a liquido e i vincoli delle reti elettriche regionali.
Per mantenere un'economia unitaria sostenibile durante un ampio rilascio commerciale, OpenAI non può semplicemente scalare il numero di parametri senza controllo. L'ingegneria dei sistemi moderni impone un'aggressiva ottimizzazione dei parametri, probabilmente sfruttando topologie mixture-of-experts (MoE) che attivano solo una frazione mirata di pesi per ogni dato token, combinata con tecniche di distillazione post-addestramento. Se il prossimo modello raggiungerà benchmark di ragionamento superiori operando all'interno di un footprint di memoria più disciplinato, ciò significherà che il perfezionamento architetturale, piuttosto che lo scaling a forza bruta, ha riconquistato il centro della scena nella ricerca sull'IA di frontiera.
Inoltre, l'adozione aziendale dipende dall'economia dell'inferenza. Il settore enterprise è diventato diffidente verso API fragili con prezzi variabili e latenze di risposta fluttuanti. I clienti industriali ad alto volume richiedono prezzi dei token prevedibili e accordi sui livelli di servizio (SLA) deterministici per giustificare la sostituzione del software deterministico legacy in favore di modelli di fondazione probabilistici. La fattibilità di questo imminente rilascio sarà misurata tanto sul bilancio aziendale quanto sui set di valutazione accademici.
Colmare il vuoto del ragionamento digitale per la robotica fisica
Il vero banco di prova per questa prossima generazione di intelligenza artificiale non è la generazione di codice o il copywriting pubblicitario, ma il mondo fisico. Per anni, il settore della robotica ha lottato con la divisione fondamentale tra ragionamento semantico di alto livello e attuazione motoria di basso livello. L'automazione robotica dei processi tradizionale eccelle nell'eseguire traiettorie ripetitive con precisione sub-millimetrica, ma fallisce completamente quando un ambiente si discosta dalla prevedibilità ingegneristica.
Un modello di frontiera capace di percezione spaziale robusta, ragionamento causale e scomposizione autonoma dei compiti rappresenta l'anello mancante nella manipolazione autonoma e nella robotica mobile. Quando un robot industriale incontra un ostacolo imprevisto sul pavimento di una fabbrica o un orientamento non modellato di un componente in una cella di assemblaggio, non può fare affidamento su vaghe distribuzioni di probabilità. Richiede uno strato cognitivo in grado di formulare ipotesi fisiche, verificare le distanze spaziali e generare piani cinematici sicuri in pochi millisecondi. Se l'architettura in arrivo da parte di OpenAI dimostrerà una coerenza temporale sostenuta e un rigoroso ragionamento fisico, diventerà immediatamente il livello operativo fondamentale per i veicoli a guida autonoma e le piattaforme di manipolazione a doppio braccio di prossima generazione.
Questa convergenza dei modelli di fondazione con i sistemi di controllo fisico sposta anche l'onere della verifica. Nello sviluppo del software, un output di token errato si traduce in un errore del compilatore o in un'eccezione non gestita; in una cella industriale, un'azione non verificata può causare collisioni meccaniche catastrofiche o lesioni umane. Di conseguenza, i settori aerospaziale e manifatturiero sottoporranno le affermazioni di affidabilità di OpenAI a rigorosi stress test empirici prima di dare il via libera a qualsiasi integrazione autonoma.
Affidabilità aziendale rispetto ai benchmark della Silicon Valley
L'industria tecnologica ha trascorso gli ultimi due anni a celebrare trionfi incrementali nei benchmark che spesso non sopravvivono al contatto con la realtà aziendale. I test sintetici come MMLU e HumanEval, sebbene utili per la classificazione accademica comparativa, sono diventati sempre più contaminati e distaccati da ambienti operativi complessi. I dirigenti tecnologici aziendali ora valutano i modelli rispetto a metriche inflessibili: tassi di allucinazione nell'elaborazione di documenti mission-critical, utilizzo deterministico degli strumenti tramite API e aderenza a rigorosi protocolli operativi senza derive.
Affinché OpenAI possa mantenere la promessa di un salto trasformativo, l'architettura in arrivo deve risolvere il problema del fallimento silenzioso. Quando un modello incontra istruzioni ambigue o una serie di vincoli impossibili, deve riconoscere in modo affidabile i propri confini cognitivi e richiedere chiarimenti, piuttosto che generare con sicurezza una falsità plausibile. Questa auto-calibrazione è il requisito di base per distribuire agenti autonomi in settori regolamentati come la gestione della catena di approvvigionamento, la diagnostica medica e l'analisi legale.
Con l'avvicinarsi dell'attesa finestra di lancio estiva, l'industria nel suo complesso si sta preparando a una verifica della realtà. Il divario competitivo tra i laboratori di frontiera proprietari e i modelli open-weights di alto calibro si è notevolmente ridotto nell'ultimo anno. Per giustificare il suo livello premium e sostenere lo slancio commerciale, il prossimo rilascio di OpenAI deve dimostrare che i suoi paradigmi di ragionamento deliberato e i perfezionamenti architetturali si traducano in un'indiscutibile utilità economica attraverso le economie fisiche e digitali.



Comments
No comments yet. Be the first!