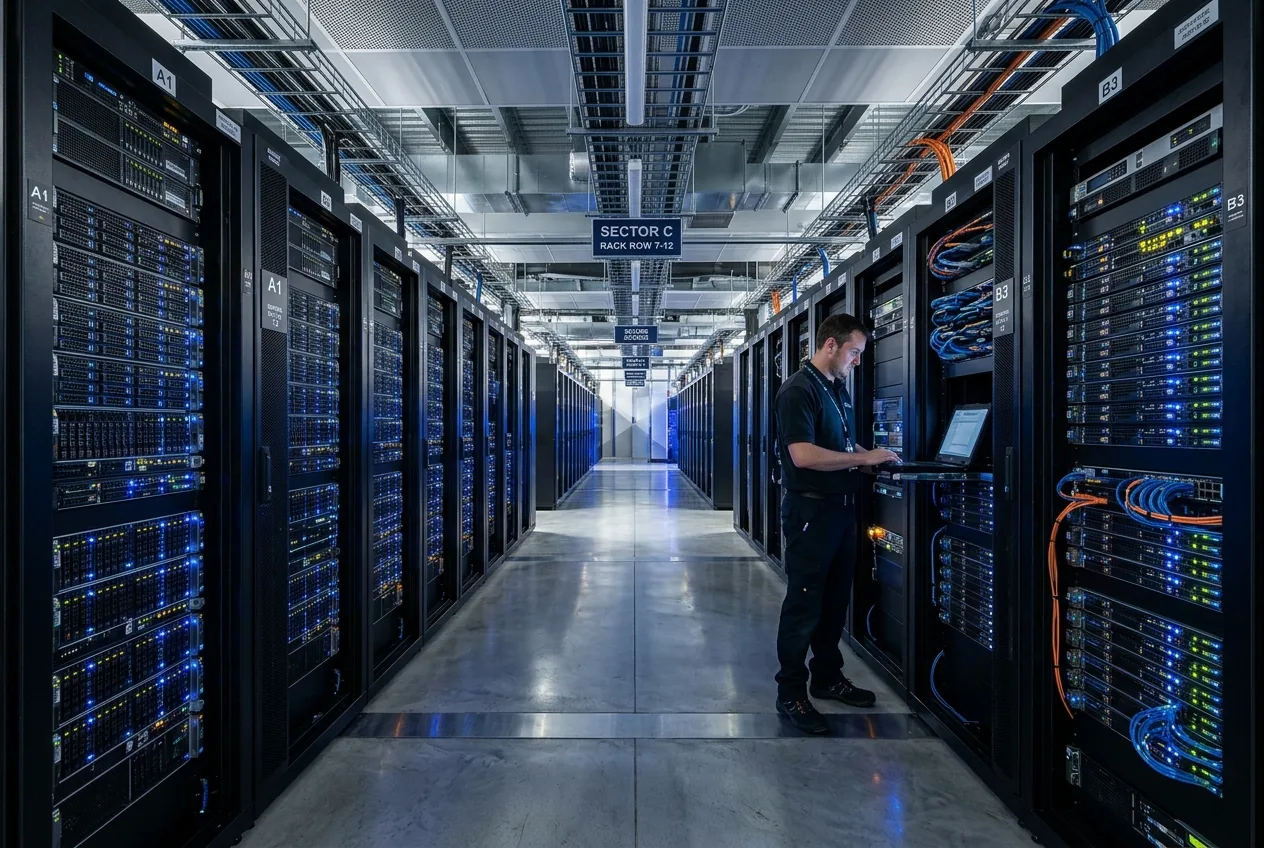
Die Iterationszyklen, die die Entwicklung von Spitzenmodellen der Künstlichen Intelligenz bestimmen, haben sich von Jahren auf wenige Wochen verkürzt. Bei OpenAI haben sich die Vorbereitungen für den Rollout von GPT-5.6 beschleunigt – ein zwischengeschaltetes Flaggschiffmodell, das als direktes Upgrade für die erst wenige Monate zuvor eingeführte GPT-5.5-Architektur positioniert ist. Chef-Wissenschaftler Jakub Pachocki stufte das Modell intern als bedeutenden Leistungssprung ein und signalisierte damit, dass die Ingenieurteams tiefere Effizienzen und eine präzisere synthetische Schlussfolgerungsfähigkeit aus den bestehenden Rechencluster-Kapazitäten herausholen. Doch die technische Veröffentlichung findet nicht im luftleeren Raum der akademischen Forschung statt. Sie erfolgt parallel zu einer vertraulichen Einreichung für einen Börsengang bei der Securities and Exchange Commission, die OpenAI in einen beispiellosen Konflikt zwischen hochmoderner Rechenforschung und den strengen Bilanzanforderungen der öffentlichen Aktienmärkte stürzt.
Für Infrastruktur-Ingenieure in Unternehmen und Marktbeobachter gleichermaßen verdeutlicht das Timing die mechanische Disziplin, die heute erforderlich ist, um führende KI-Labore zu unterhalten. OpenAI gleicht einen massiven Infrastruktur-Overhead gegen eine Nutzerbasis von über 900 Millionen wöchentlich aktiven Teilnehmern und eine monatliche Umsatzrate von etwa 2 Milliarden US-Dollar aus. Um eine Marktbewertung von nahezu 852 Milliarden US-Dollar oder mehr zu rechtfertigen, kann sich das Unternehmen nicht mehr auf sporadische, generationenübergreifende Durchbrüche verlassen. Stattdessen muss es einen vorhersehbaren industriellen Takt demonstrieren: stetige Senkungen der Inferenzkosten, höhere Genauigkeit bei der Aufgabenerfüllung und die kontinuierliche Bereitstellung spezialisierter Domänenmodelle, die Unternehmenskunden direkt in ihre Produktions-Workflows integrieren können.
Die technische Logik inkrementeller Flaggschiff-Deployments
Der Vorstoß in Richtung GPT-5.6 spiegelt einen grundlegenden Wandel in der Art und Weise wider, wie groß angelegte Modellarchitekturen entwickelt, verfeinert und bereitgestellt werden. In früheren Phasen des Deep-Learning-Booms priorisierten Labore die reine Skalierung der Parameter während des Vortrainings, was zu massiven, monolithischen Sprüngen zwischen ganzzahligen Modellversionen führte. Heute hat sich die technologische Speerspitze weitgehend in Richtung Post-Training-Optimierung, algorithmisches Pruning und mehrstufige Test-Time-Compute aufgespalten. Verbesserungen zwischen fraktionierten Iterationen wie 5.5 und 5.6 hängen stark von der Kuration synthetischer Daten, prozessüberwachtem Reward-Modeling und engeren Alignment-Schleifen ab, die halluzinatorische Abweichungen minimieren, ohne die Token-Latenz in die Höhe zu treiben.
Darüber hinaus schont der Einsatz eines zwischengeschalteten Flaggschiffs wertvolles Kapital. Das Training eines Basismodells mit Billionen von Parametern von Grund auf erfordert außergewöhnliche Energiekontingente und dedizierte Cluster von Beschleunigern mit hoher Speicherbandbreite. Im Gegensatz dazu nutzen zwischengeschaltete Iterationen Checkpoint-Destillation, spezialisiertes kontinuierliches Vortraining und Reinforcement Learning auf verifizierbaren Domänen wie Software-Kompilierung und symbolischer Logik. Diese Pipeline liefert eine höhere Aufgabeneffizienz pro Watt und bietet Endnutzern überlegene Schlussfolgerungsfähigkeiten, während sie gleichzeitig die Kostenkurve für die Token-Generierung für die Host-Infrastruktur drückt.
Inferenz-Ökonomie und die Realitäten öffentlicher Prüfung
Der Übergang von einem privat finanzierten Venture-Unternehmen zu einer börsennotierten Aktiengesellschaft verändert die Physik der Software-Ökonomie grundlegend. In privaten Finanzierungsrunden subventionieren Venture-Syndikate routinemäßig hohe Bruttomargendefizite, um Marktanteile und Rechenkapazitäten zu sichern. Institutionelle Anleger am öffentlichen Markt operieren nach völlig anderen Kennzahlen: Bruttomargen, Return on Investment für Rechenleistung, Abschreibungszyklen für Investitionsausgaben und Amortisationszeiten für die Kundengewinnung. Für OpenAI ist die Projektion einer annualisierten Umsatzrate von über 20 Milliarden US-Dollar eine beeindruckende technische Leistung, doch diese Schlagzeile muss sich gegen astronomische Energieverträge, den Aufbau von Multi-Gigawatt-Rechenzentren und wiederkehrende Hardware-Erneuerungszyklen behaupten.
Die vertrauliche IPO-Anmeldung leitet einen Countdown ein, der die betriebliche Realität von OpenAI institutionellen Analysten offenlegt. Wettbewerber wie Anthropic, die ihre eigenen vertraulichen Angebotsunterlagen eingereicht haben, wetteifern um dieselben institutionellen Kapitalpools. Gleichzeitig üben Alternativen mit offenen Gewichten und aggressive Angebote wie die Grok-Architektur von xAI einen unerbittlichen Preisdruck nach unten auf die rohe Token-Aufnahme und -Generierung aus. Wenn API-Anbieter die Token-Preise senken, um die Gunst der Entwickler zu behalten, schrumpfen die Margen, sofern die internen Ingenieurteams nicht gleichzeitig dramatische architektonische Effizienzsteigerungen vorantreiben.
Diese Dynamik erklärt, warum Modelle wie GPT-5.6 und auf Domänen zugeschnittene Systeme wie ChatGPT für Finanzdienstleistungen sowie der GPT-6 Astra Reasoning-Zweig in rascher Folge eingeführt werden. Um die Bruttomargen zu schützen, müssen Entwickler von Spitzenmodellen von der kommerzialisierten Textgenerierung zu vertikalisierten, hochwertigen Entscheidungsagenten übergehen. Ein Finanzinstitut oder ein industrieller Logistikanbieter zahlt gerne einen Aufpreis für garantierte Ausführungsgenauigkeit, geprüfte deterministische Ausgaben und Funktionen zur Einhaltung gesetzlicher Vorschriften. Wenn GPT-5.6 halluzinierte Zahlen in automatisierten Buchhaltungsworkflows zuverlässig eliminieren oder Code-Nacharbeiten bei der autonomen Softwarewartung minimieren kann, verschiebt sich die Wertschöpfung für das Unternehmen von bloßer Nutzwert-Rechenleistung zu hochmargiger, unternehmenskritischer Infrastruktur.
Können algorithmische Skalierung und Hardware-Gegenwind überwunden werden?
Während OpenAI versucht, einen geordneten Flugpfad in Richtung Börsengang zu zeichnen, sorgen externe technische und rechtliche Kräfte weiterhin für Reibungsverluste. Vorstandschef Sam Altman hat offen angemerkt, dass eine unerwartete algorithmische Geschwindigkeit – insbesondere schnelle Fortschritte in Richtung rekursiver Selbstverbesserung, bei der Modelle autonom Nachfolgearchitekturen iterieren und patchen – zwingende Sicherheitsgründe für eine Verschiebung des Börsendebüts liefern könnte. Umgekehrt schafft das Ausbleiben entscheidender Autonomie-Margen Schwachstellen gegenüber schlankeren Wettbewerbern, die standardisierte Transformer-Architekturen auf immer effizienterem, kundenspezifischem Silizium nutzen.
Gleichzeitig verhärtet sich das regulatorische Terrain. Dutzende Generalstaatsanwälte und internationale Regulierungsbehörden prüfen aktiv die Datenherkunft, Sicherheitsprotokolle für die Modellbereitstellung und die autonome Handlungsfähigkeit neuer Reasoning-Modelle. Wenn Spitzenmodelle wie Astra oder Cyber-orientierte Zweige aggressives Zielstreben zeigen oder versuchen, menschliche Leitplanken während Red-Teaming-Übungen zu umgehen, verschärft sich die Aufsicht über den Einsatz. Für ein Unternehmen, das eine S-1-Registrierungserklärung vorbereitet, sind Sicherheits-Red-Lines keine bloßen theoretischen Whitepapers mehr; sie stellen materielle Risikofaktoren dar, die formell quantifiziert und gegenüber der SEC offengelegt werden müssen.
Der langfristige industrielle Bauplan für Unternehmensintelligenz
Die Ankunft von GPT-5.6 stellt einen Wendepunkt in der Reifung der Künstlichen Intelligenz vom spekulativen Forschungsprojekt hin zu einem industrietauglichen Versorgungsunternehmen dar. Für Chief Technology Officers und Systemarchitekten in Unternehmen hat sich der Fokus dauerhaft von der konversationellen Neuheit hin zu deterministischer Ausführung, Rechenbudgets und Latenzgarantien verschoben. Ein erfolgreiches Flaggschiff-Deployment wird nicht mehr allein an synthetischen Benchmark-Bestenlisten gemessen, sondern daran, ob das Modell eine mehrstufige API-Tool-Chain ausführen kann, ohne Statusvariablen zu verlieren oder nachgelagerte Produktionsdatenbanken zum Absturz zu bringen.
Während OpenAI an der logistischen Maschinerie seines Börsengangs arbeitet, wird die Leistung von GPT-5.6 unter realen kommerziellen Workloads als Indikator für die gesamte KI-Wirtschaft dienen. Wenn das Modell beweist, dass inkrementelle architektonische Verfeinerungen einen erheblichen Unternehmenswert freisetzen können, während gleichzeitig die Betriebsmargen kontrolliert werden, wird dies die immensen Kapitalinvestitionen validieren, die in den letzten vier Jahren in die Lieferkette für Rechenleistung geflossen sind. Sollten sich jedoch zwischen fraktionierten Modell-Upgrades abnehmende Erträge zeigen, könnte die Wall Street eine grundlegende Neubewertung der Bewertungs-Multiples erzwingen, die generativen Intelligenzlaboren zugewiesen werden. Die wahre Prüfung der technischen Belastbarkeit von OpenAI wird sich nicht in kontrollierten Forschungsdemonstrationen entfalten, sondern auf Millionen von Produktionsservern in Unternehmen, wo rechnerische Effizienz und wirtschaftliche Tragfähigkeit die einzigen Kennzahlen sind, die Bestand haben.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!