Per anni, la ricerca sull'intelligenza artificiale di frontiera ha operato secondo una tesi lineare: aumentare il numero di parametri, fornire all'architettura più potenza di calcolo e dati, e lasciare che il ragionamento emergente risolvesse problemi complessi. Tuttavia, all'interno dei laboratori di frontiera, i limiti dei singoli modelli linguistici di grandi dimensioni monolitici sono diventati palesemente visibili. Quando chiamati a gestire flussi di lavoro tecnici multi-fase, esecuzione di strumenti a lungo termine o risoluzione di problemi industriali critici, le istanze a modello singolo soffrono inevitabilmente di degrado del contesto, deriva stocastica e propagazione catastrofica degli errori. Per preparare il terreno al suo prossimo modello di punta, provvisoriamente designato GPT-5, OpenAI ha costantemente riprogettato il proprio focus architetturale attorno a sistemi multi-agente distribuiti.
Piuttosto che aspettarsi che un'unica rete neurale massiccia funzioni simultaneamente come pianificatore esecutivo, compilatore di codice, specialista di dominio e motore di verifica, i framework multi-agente aggiornati di OpenAI suddividono il lavoro cognitivo complesso tra sotto-agenti specializzati. Questi agenti leggeri e specifici per ruolo trasmettono variabili di stato, criticano gli output reciproci e operano secondo protocolli di passaggio rigorosi. Questa transizione segna uno spostamento fondamentale: dal considerare l'IA come un oracolo digitale solitario all'ingegnerizzarla come un runtime software coordinato, capace di eseguire operazioni di livello enterprise con precisione deterministica.
La scomposizione dell'inferenza monolitica
Nell'ingegneria dei sistemi classica, nessun singolo controller governa ogni sottosistema di una catena di montaggio automatizzata o di una suite avionica. Al contrario, i controllori logici programmabili distribuiti gestiscono la telemetria localizzata, riportando i dati a un'architettura di controllo di supervisione e acquisizione dati. I modelli transformer monolitici, al contrario, tentano di mantenere un intero mondo operativo all'interno di una singola finestra di attenzione scorrevole. Anche con finestre di contesto che si espandono fino a milioni di token, le prestazioni calano sensibilmente man mano che le catene di ragionamento si allungano — un fenomeno che i ricercatori chiamano "context rot" (degrado del contesto) o distrazione in-context.
Questo perno architetturale affronta direttamente il muro dei rendimenti decrescenti nel semplice scaling del pre-addestramento. Sebbene i dati sintetici e l'apprendimento per rinforzo continuino a migliorare le capacità di inferenza grezza, orchestrare modelli multipli, più piccoli e specializzati, produce un'affidabilità maggiore nei compiti di ragionamento a lungo termine rispetto all'aumento di un ordine di grandezza di un checkpoint monolitico. Per il prossimo salto generazionale verso GPT-5, i passaggi tra agenti fungono da framework strutturale necessario per tradurre l'intelligenza sintetica grezza in un'esecuzione operativa sostenuta e affidabile.
Passaggi di stato e verifica deterministica
Al centro degli aggiornamenti multi-agente di OpenAI c'è un meccanismo di passaggio raffinato, progettato per sostituire le ambigue discussioni in linguaggio naturale tra agenti con transizioni formali tra macchine a stati. Nei primi esperimenti multi-agente del settore, i modelli rimanevano frequentemente bloccati in loop conversazionali circolari, mettendosi in discussione a vicenda senza produrre output azionabili. I protocolli più recenti trattano i passaggi tra agenti con il rigore dei sistemi distribuiti classici, impiegando schemi espliciti, input tipizzati e logiche di instradamento condizionale.
Secondo questo paradigma, un orchestratore valuta un problema in entrata e lo scompone in un grafo diretto aciclico di sotto-attività. Se sorge un calcolo matematico o un compito di refactoring del codice, l'orchestratore delega l'esecuzione a un agente dotato di prompt di sistema specializzati, strumenti deterministici su misura e un inviluppo di contesto ristretto. Fondamentalmente, il sistema incorpora agenti di verifica dedicati la cui unica direttiva è la critica avversariale. Prima che qualsiasi proposta di modifica dello stato aggiorni l'ambiente globale, un modello verifier controlla l'output rispetto a vincoli programmatici, prove formali o test di integrazione.
Questo ciclo di verifica colma il divario tra la previsione probabilistica dei token e l'ingegneria del software deterministica. Nei sistemi meccanici, sensori ridondanti controllano incrociatamente le letture critiche prima che gli attuatori si attivino. OpenAI sta portando esattamente quella filosofia operativa nei modelli generativi. Obbligando gli agenti a concordare attraverso controlli di validazione indipendenti, la probabilità che allucinazioni non forzate scivolino nelle pipeline di produzione diminuisce drasticamente, rendendo l'architettura valida per applicazioni aziendali ad alto rischio.
Automazione industriale e integrazione dei sistemi fisici
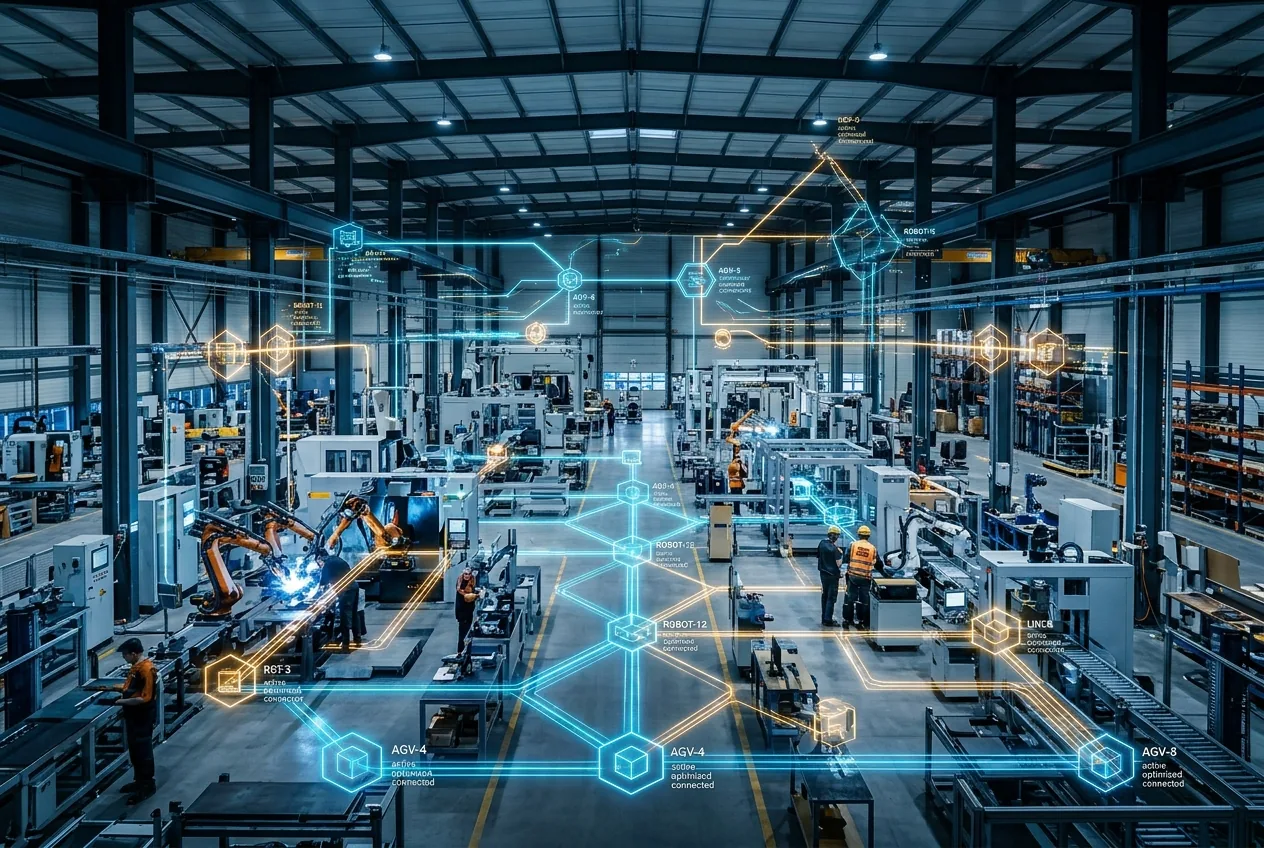
Le implicazioni pratiche del perfezionamento multi-agente di OpenAI vanno ben oltre l'automazione della produttività in ufficio, puntando direttamente all'automazione fisica, alla diagnostica della catena di approvvigionamento e alle flotte robotiche. In un moderno hub logistico o in uno stabilimento di produzione automatizzato, un sistema robotico deve elaborare telemetria visiva, monitorare le soglie di coppia del motore, interfacciarsi con i database di pianificazione delle risorse aziendali e coordinare il percorso con altri veicoli a guida automatica. Un singolo modello che elabora questo flusso sensoriale multivariante incontra rapidamente colli di bottiglia nel calcolo e una latenza di inferenza inaccettabile.
I framework multi-agente, progettati per le famiglie di modelli all'orizzonte come GPT-5, consentono topologie di calcolo gerarchiche dall'edge al cloud. Agenti leggeri e a bassa latenza possono operare vicino all'hardware fisico, gestendo calcoli cinematici in tempo reale, correzioni di traiettoria e rilevamento di anomalie. Contemporaneamente, un agente deliberativo più pesante, ospitato nel cloud, analizza continuamente i cambiamenti operativi a livello macro, come i ritardi nella catena di approvvigionamento in entrata o i cicli di manutenzione dei macchinari, trasmettendo direttive operative riconfigurate agli agenti edge.
Questa separazione delle competenze rispecchia i classici sistemi di controllo industriale a ciclo chiuso. Se un agente edge incontra una condizione fisica anomala — come un nastro trasportatore inceppato o un surriscaldamento in un giunto robotico — non ha bisogno di passare gigabyte di log dei sensori a un massiccio modello di frontiera. Invece, attiva un segnale di interrupt, consentendo a un agente diagnostico intermedio di isolare il guasto, consultare i manuali tecnici e inviare istruzioni di rimedio precise ai tecnici umani o ai robot di manutenzione.
L'equilibrio economico e di latenza
Sebbene i sistemi multi-agente riducano drasticamente i tassi di errore cognitivo, introducono una distinta sfida ingegneristica: il costo computazionale e finanziario dell'inferenza multi-turno. Eseguire tre, cinque o dieci istanze di modello per risolvere un compito che in precedenza era affidato a una sola, moltiplica intrinsecamente il consumo di token. Se ogni decisione minore innesca un esteso dibattito round-robin tra sotto-agenti specializzati, la latenza di inferenza scala rapidamente, creando attrito per le applicazioni in tempo reale rivolte all'utente.
Per rendere questa architettura economicamente sostenibile, le ultime iterazioni di OpenAI puntano molto sull'instradamento eterogeneo del calcolo. Non ogni agente all'interno di uno sciame deve girare su pesi di classe "frontier". I doveri amministrativi di routine, la formattazione dei dati e la validazione della sintassi sono delegati a modelli di utilità ultra-veloci e altamente compressi. L'intelligenza di frontiera, rappresentata da modelli come GPT-5 o motori di ragionamento specializzati, è riservata esclusivamente al ruolo di orchestratore o alla sintesi di casi limite intrattabili.
Costruire le fondamenta per l'infrastruttura autonoma
La progressione verso l'orchestrazione multi-agente riflette un settore che sta uscendo dalla sua fase sperimentale. Poiché i guadagni architetturali grezzi derivanti dal pre-addestramento a forza bruta decelerano a fronte dei limiti dei dati e dei vincoli di disponibilità energetica, l'eleganza ingegneristica nell'orchestrazione del software ha assunto un ruolo centrale. Gli aggiornamenti di OpenAI dimostrano che il percorso verso la capacità di prossima generazione riguarda tanto l'idraulica — come i modelli comunicano, verificano, delegano e falliscono in modo controllato — quanto la capacità grezza della rete neurale stessa.



Comments
No comments yet. Be the first!