Durante años, la investigación de inteligencia artificial de frontera operó bajo una tesis sencilla: aumentar el número de parámetros, proporcionar a la arquitectura más capacidad de cómputo y datos, y dejar que el razonamiento emergente resolviera problemas complejos. Sin embargo, dentro de los laboratorios de vanguardia, las limitaciones de los grandes modelos de lenguaje monolíticos se han vuelto claramente visibles. Cuando se les asignan flujos de trabajo técnicos de varios pasos, ejecución de herramientas a largo plazo o resolución de problemas industriales críticos, las instancias de modelo único sufren inevitablemente de degradación del contexto, deriva estocástica y propagación catastrófica de errores. Para despejar el camino hacia su próximo modelo insignia, designado provisionalmente como GPT-5, OpenAI ha rediseñado constantemente su enfoque arquitectónico principal hacia sistemas multi-agente distribuidos.
En lugar de esperar que una única red neuronal masiva funcione simultáneamente como planificador ejecutivo, compilador de código, especialista en dominios y motor de verificación, los marcos multi-agente actualizados de OpenAI dividen el trabajo cognitivo complejo entre sub-agentes especializados. Estos agentes ligeros y específicos para cada función transmiten variables de estado, critican las salidas de los demás y operan bajo protocolos estrictos de transferencia. Esta transición marca un cambio fundamental: dejar de tratar a la IA como un oráculo digital solitario para pasar a diseñarla como un entorno de ejecución de software coordinado, capaz de realizar trabajos de nivel empresarial con precisión determinista.
El colapso de la inferencia monolítica
En la ingeniería de sistemas clásica, ningún controlador único gobierna todos los subsistemas de una línea de montaje automatizada o de una suite de aviónica. En su lugar, los controladores lógicos programables distribuidos gestionan la telemetría localizada, informando a una arquitectura de control de supervisión y adquisición de datos. Los modelos transformer monolíticos, por el contrario, intentan contener todo un mundo operativo dentro de una única ventana de atención continua. Incluso con ventanas de contexto que se expanden a millones de tokens, el rendimiento cae notablemente a medida que las cadenas de razonamiento se alargan; un fenómeno que los investigadores denominan "deterioro del contexto" o distracción en contexto.
Este giro arquitectónico aborda directamente el muro de rendimientos decrecientes en el escalado simple de preentrenamiento. Si bien los datos sintéticos y el aprendizaje por refuerzo continúan mejorando las capacidades de inferencia bruta, la orquestación de múltiples modelos más pequeños y especializados produce una mayor fiabilidad en tareas de razonamiento a largo plazo que escalar un punto de control monolítico en un orden de magnitud. Para el próximo salto generacional hacia GPT-5, las transferencias entre agentes sirven como el marco estructural necesario para traducir la inteligencia sintética bruta en una ejecución operativa sostenida y fiable.
Transferencias de estado y verificación determinista
En el centro de las actualizaciones multi-agente de OpenAI se encuentra un mecanismo de transferencia refinado, diseñado para sustituir los ambiguos debates en lenguaje natural entre agentes por transiciones formales de máquinas de estado. En experimentos multi-agente anteriores en la industria, los modelos quedaban bloqueados frecuentemente en bucles conversacionales circulares, cuestionándose mutuamente sin producir resultados procesables. Los protocolos más recientes tratan las transferencias de agentes con el rigor de los sistemas distribuidos clásicos, empleando esquemas explícitos, entradas tipadas y lógica de enrutamiento condicional.
Bajo este paradigma, un orquestador evalúa un problema entrante y lo descompone en un grafo acíclico dirigido de subtareas. Si surge un cálculo matemático o una tarea de refactorización de código, el orquestador delega la ejecución a un agente cargado con prompts de sistema especializados, herramientas deterministas a medida y un sobre de contexto restringido. Fundamentalmente, el sistema incorpora agentes de verificación dedicados cuya única directriz es la crítica adversarial. Antes de que cualquier cambio de estado propuesto actualice el entorno global, un modelo verificador comprueba la salida frente a restricciones programáticas, pruebas formales o pruebas de integración.
Este bucle de verificación cierra la brecha entre la predicción probabilística de tokens y la ingeniería de software determinista. En los sistemas mecánicos, los sensores redundantes verifican las lecturas críticas antes de que se disparen los actuadores. OpenAI está trasladando esa misma filosofía operativa a los modelos generativos. Al forzar a los agentes a ponerse de acuerdo mediante comprobaciones de validación independientes, la probabilidad de que alucinaciones no forzadas se filtren en las tuberías de producción disminuye precipitadamente, lo que hace que la arquitectura sea viable para aplicaciones empresariales de alto riesgo.
Automatización industrial e integración de sistemas físicos
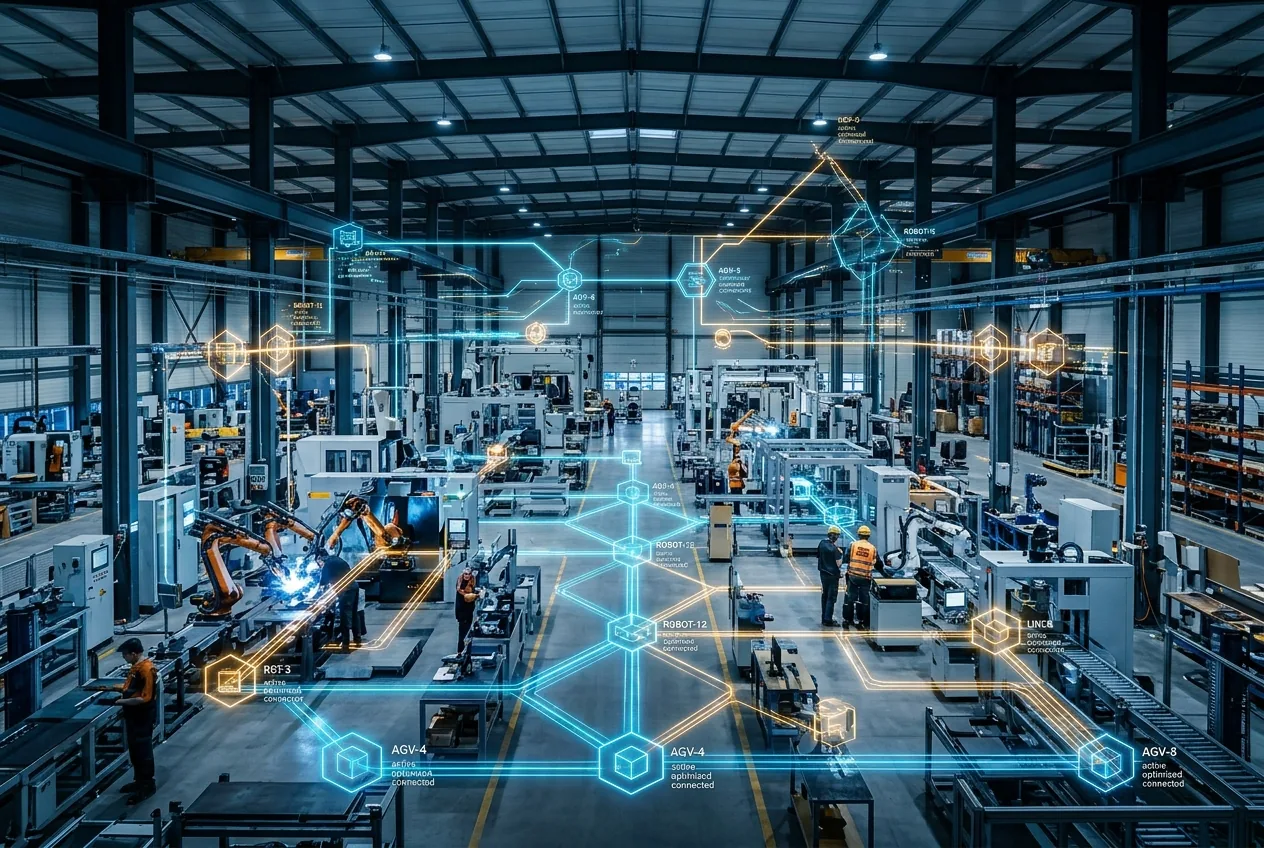
Las implicaciones prácticas del refinamiento multi-agente de OpenAI van mucho más allá de la productividad de oficina automatizada, apuntando directamente a la automatización física, el diagnóstico de la cadena de suministro y las flotas de robótica. En un centro logístico moderno o una instalación de fabricación automatizada, un sistema robótico debe procesar telemetría visual, monitorear los umbrales de torque del motor, interactuar con bases de datos de planificación de recursos empresariales y coordinar trayectorias con otros vehículos de guiado automático. Un solo modelo que procese este flujo sensorial multivariante se enfrenta rápidamente a cuellos de botella informáticos y a una latencia de inferencia inaceptable.
Los marcos multi-agente, diseñados para familias de modelos en el horizonte como GPT-5, permiten topologías de computación jerárquica desde el borde hasta la nube (edge-to-cloud). Los agentes ligeros y de baja latencia pueden operar cerca del hardware físico, gestionando cálculos cinemáticos en tiempo real, correcciones de trayectoria y detección de anomalías. Simultáneamente, un agente deliberativo más pesado, alojado en la nube, analiza continuamente los cambios operativos a nivel macro, como retrasos en la cadena de suministro entrante o ciclos de mantenimiento de maquinaria, transmitiendo directivas operativas reconfiguradas a los agentes en el borde.
Esta separación de funciones refleja los sistemas de control industrial de lazo cerrado clásicos. Si un agente de borde encuentra una condición física anómala, como una cinta transportadora atascada o un embalamiento térmico en una articulación robótica, no necesita pasar gigabytes de registros de sensores a un modelo de frontera masivo. En su lugar, activa una señal de interrupción, lo que permite a un agente de diagnóstico intermedio aislar la falla, consultar manuales de ingeniería y enviar instrucciones de remediación precisas a técnicos humanos o a la robótica de mantenimiento.
El equilibrio económico y de latencia
Si bien los sistemas multi-agente reducen drásticamente las tasas de error cognitivo, introducen un desafío de ingeniería distintivo: el costo computacional y financiero de la inferencia de múltiples turnos. Ejecutar tres, cinco o diez instancias de modelo para resolver una tarea que anteriormente se delegaba a una sola, multiplica inherentemente el consumo de tokens. Si cada decisión menor desencadena una ronda extendida de debate entre sub-agentes especializados, la latencia de inferencia aumenta rápidamente, creando fricción para las aplicaciones orientadas al usuario en tiempo real.
Para hacer esta arquitectura económicamente viable, las últimas iteraciones de OpenAI se apoyan fuertemente en el enrutamiento informático heterogéneo. No todos los agentes dentro de un enjambre necesitan ejecutarse con pesos de clase "frontera". Las tareas administrativas rutinarias, el formato de datos y la validación de sintaxis se envían a modelos de utilidad ultrarrápidos y altamente comprimidos. La inteligencia de frontera, representada por modelos como GPT-5 o motores de razonamiento especializados, se reserva exclusivamente para el rol de orquestador o la síntesis de casos límite intratables.
Construyendo los cimientos de la infraestructura autónoma
La progresión hacia la orquestación multi-agente refleja una industria que está superando su fase experimental. A medida que las ganancias arquitectónicas brutas derivadas del preentrenamiento por fuerza bruta se ralentizan frente a los límites de los datos y las restricciones de disponibilidad de energía, la elegancia de la ingeniería en la orquestación de software ha pasado a ocupar un lugar central. Las actualizaciones de OpenAI demuestran que el camino hacia la capacidad de próxima generación depende tanto de la fontanería —cómo se comunican, verifican, delegan y fallan de forma elegante los modelos— como de la capacidad bruta de la propia red neuronal.



Comments
No comments yet. Be the first!