Pendant des années, la recherche en intelligence artificielle de pointe a reposé sur une thèse simple : augmenter le nombre de paramètres, fournir à l'architecture davantage de puissance de calcul et de données, et laisser le raisonnement émergent résoudre des problèmes complexes. Pourtant, au sein des laboratoires de recherche, les limites des grands modèles de langage monolithiques sont devenues manifestes. Lorsqu'ils sont confrontés à des flux de travail techniques en plusieurs étapes, à l'exécution d'outils sur le long terme ou à la résolution de problèmes industriels critiques, les instances à modèle unique souffrent inévitablement d'une dégradation du contexte, d'une dérive stochastique et d'une propagation catastrophique des erreurs. Pour préparer le terrain à son prochain modèle phare, provisoirement désigné sous le nom de GPT-5, OpenAI a progressivement réorienté son architecture fondamentale vers des systèmes distribués multi-agents.
Plutôt que d'attendre d'un seul réseau de neurones massif qu'il fonctionne simultanément comme un planificateur exécutif, un compilateur de code, un spécialiste de domaine et un moteur de vérification, les frameworks multi-agents mis à jour par OpenAI répartissent le travail cognitif complexe entre des sous-agents spécialisés. Ces agents légers et spécifiques à une tâche transmettent des variables d'état, critiquent les résultats de leurs homologues et opèrent selon des protocoles de transfert stricts. Cette transition marque un changement fondamental : on ne considère plus l'IA comme un oracle numérique isolé, mais on la conçoit comme un runtime logiciel coordonné, capable d'exécuter des tâches de niveau entreprise avec une précision déterministe.
La décomposition de l'inférence monolithique
Dans l'ingénierie des systèmes classiques, aucun contrôleur unique ne régit chaque sous-système d'une ligne d'assemblage automatisée ou d'une suite avionique. Au lieu de cela, des automates programmables distribués gèrent la télémétrie localisée, rendant compte à une architecture de contrôle de surveillance et d'acquisition de données (SCADA). Les modèles de transformateurs monolithiques, en revanche, tentent de maintenir un monde opérationnel entier dans une seule fenêtre d'attention glissante. Même avec des fenêtres de contexte s'étendant sur des millions de jetons, les performances chutent sensiblement à mesure que les chaînes de raisonnement s'allongent — un phénomène que les chercheurs appellent « pourrissement du contexte » (context rot) ou distraction in-context.
Ce pivot architectural répond directement au mur des rendements décroissants de la simple mise à l'échelle du pré-entraînement. Si les données synthétiques et l'apprentissage par renforcement continuent d'améliorer les capacités d'inférence brutes, l'orchestration de plusieurs modèles plus petits et spécialisés offre une fiabilité supérieure sur les tâches de raisonnement à long terme par rapport à la montée en charge d'un point de contrôle monolithique d'un ordre de grandeur. Pour le saut générationnel à venir vers GPT-5, les transferts entre agents servent de cadre structurel nécessaire pour traduire l'intelligence synthétique brute en une exécution opérationnelle durable et fiable.
Transferts d'état et vérification déterministe
Au cœur des mises à jour multi-agents d'OpenAI se trouve un mécanisme de transfert raffiné, conçu pour remplacer les débats ambigus en langage naturel entre agents par des transitions formelles de machines à états. Dans les premières expérimentations industrielles multi-agents, les modèles restaient fréquemment bloqués dans des boucles conversationnelles circulaires, se remettant mutuellement en question sans produire de résultats exploitables. Les protocoles les plus récents traitent les transferts d'agents avec la rigueur des systèmes distribués classiques, en utilisant des schémas explicites, des entrées typées et une logique de routage conditionnel.
Selon ce paradigme, un orchestrateur évalue un problème entrant et le décompose en un graphe orienté acyclique de sous-tâches. Si un calcul mathématique ou une tâche de refactorisation de code se présente, l'orchestrateur délègue l'exécution à un agent doté d'invites système spécialisées, d'outils déterministes sur mesure et d'une enveloppe contextuelle restreinte. Plus important encore, le système intègre des agents de vérification dédiés dont la seule directive est la critique contradictoire. Avant que toute proposition de changement d'état ne mette à jour l'environnement global, un modèle vérificateur contrôle le résultat par rapport à des contraintes programmatiques, des preuves formelles ou des tests d'intégration.
Cette boucle de vérification comble le fossé entre la prédiction probabiliste de jetons et l'ingénierie logicielle déterministe. Dans les systèmes mécaniques, des capteurs redondants vérifient les lectures critiques avant que les actionneurs ne se déclenchent. OpenAI applique cette même philosophie opérationnelle aux modèles génératifs. En obligeant les agents à s'accorder via des contrôles de validation indépendants, la probabilité que des hallucinations non sollicitées se glissent dans les pipelines de production diminue drastiquement, rendant l'architecture viable pour des applications d'entreprise à forts enjeux.
Automatisation industrielle et intégration des systèmes physiques
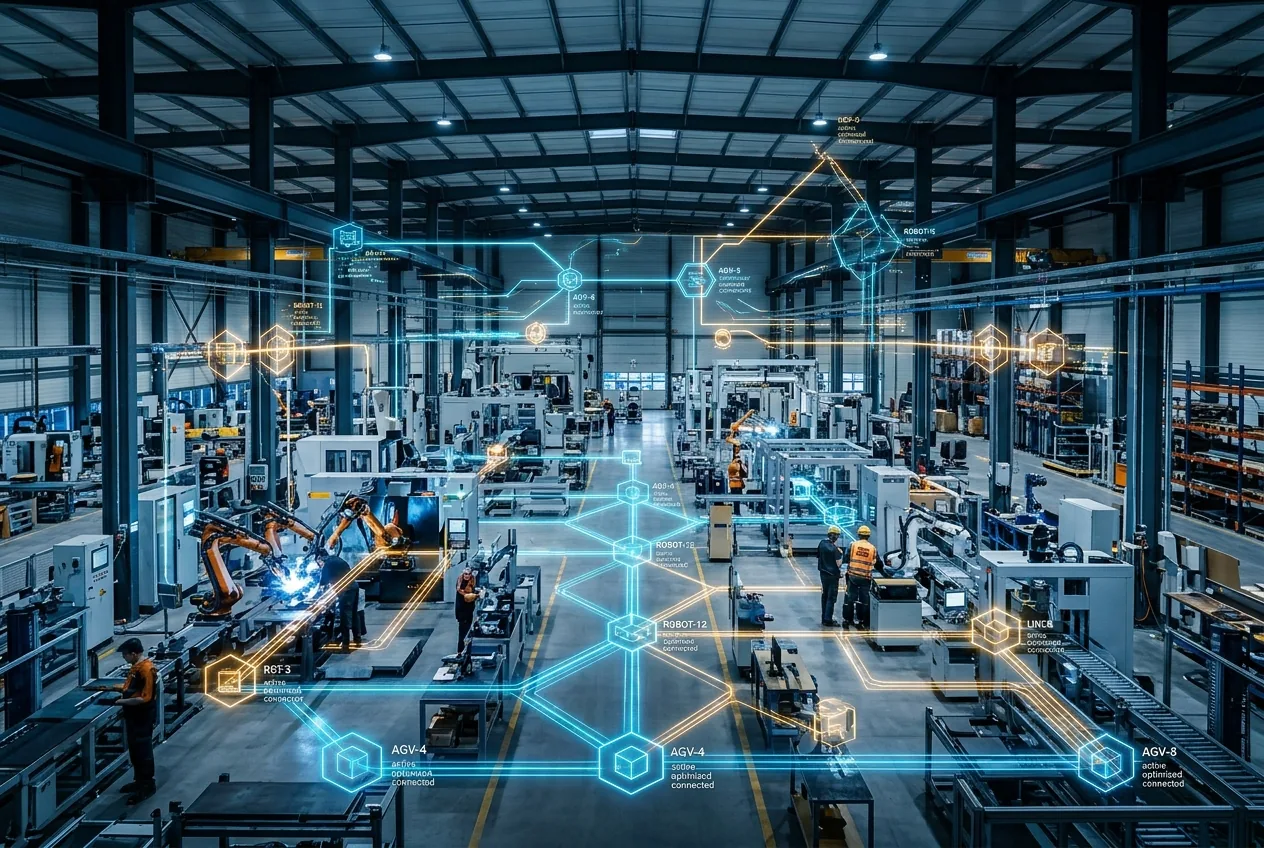
Les implications pratiques du perfectionnement multi-agents d'OpenAI vont bien au-delà de l'automatisation de la productivité de bureau, pointant directement vers l'automatisation physique, les diagnostics de la chaîne d'approvisionnement et les flottes de robotique. Dans un centre logistique moderne ou une installation de fabrication automatisée, un système robotique doit traiter la télémétrie visuelle, surveiller les seuils de couple des moteurs, s'interfacer avec des bases de données de planification des ressources de l'entreprise (ERP) et coordonner les trajectoires avec d'autres véhicules à guidage automatique. Un modèle unique traitant ce flux sensoriel multivariant se heurte rapidement à des goulots d'étranglement informatiques et à une latence d'inférence inacceptable.
Les frameworks multi-agents, conçus pour les familles de modèles à venir comme GPT-5, permettent des topologies de calcul hiérarchiques allant de la périphérie (edge) au cloud. Des agents légers et à faible latence peuvent opérer à proximité du matériel physique, gérant les calculs cinématiques en temps réel, les corrections de trajectoire et la détection d'anomalies. Simultanément, un agent délibératif plus lourd, hébergé dans le cloud, analyse en continu les changements opérationnels macroscopiques, tels que les retards dans la chaîne d'approvisionnement entrante ou les cycles de maintenance des machines, transmettant des directives opérationnelles reconfigurées aux agents périphériques.
Cette séparation des préoccupations reflète les systèmes de contrôle industriel classiques en boucle fermée. Si un agent périphérique rencontre une condition physique anormale — comme un convoyeur bloqué ou une surchauffe dans une articulation robotique — il n'a pas besoin de transmettre des gigaoctets de journaux de capteurs à un modèle de pointe massif. Au lieu de cela, il déclenche un signal d'interruption, permettant à un agent de diagnostic intermédiaire d'isoler la panne, de consulter les manuels d'ingénierie et d'envoyer des instructions de réparation précises aux techniciens humains ou aux robots de maintenance.
L'équilibre économique et de latence
Bien que les systèmes multi-agents réduisent considérablement les taux d'erreurs cognitives, ils introduisent un défi d'ingénierie distinct : le coût computationnel et financier de l'inférence à tours multiples. L'exécution de trois, cinq ou dix instances de modèles pour résoudre une tâche auparavant confiée à un seul modèle multiplie intrinsèquement la consommation de jetons. Si chaque décision mineure déclenche un long débat contradictoire entre des sous-agents spécialisés, la latence d'inférence augmente rapidement, créant une friction pour les applications en temps réel destinées aux utilisateurs.
Pour rendre cette architecture économiquement viable, les dernières itérations d'OpenAI s'appuient fortement sur le routage informatique hétérogène. Tous les agents au sein d'un essaim ne doivent pas nécessairement fonctionner avec des poids de classe « frontière ». Les tâches administratives de routine, le formatage des données et la validation de la syntaxe sont confiés à des modèles utilitaires ultra-rapides et hautement compressés. L'intelligence de pointe, représentée par des modèles comme GPT-5 ou des moteurs de raisonnement spécialisés, est réservée exclusivement au rôle d'orchestrateur ou à la synthèse de cas limites insolubles.
Construire les fondations d'une infrastructure autonome
La progression vers l'orchestration multi-agents reflète une industrie qui sort de sa phase expérimentale. Alors que les gains architecturaux bruts issus du pré-entraînement par force brute ralentissent face aux plafonds de données et aux contraintes de disponibilité de l'énergie, l'élégance de l'ingénierie dans l'orchestration logicielle occupe désormais le devant de la scène. Les mises à jour d'OpenAI montrent que le chemin vers la prochaine génération de capacités dépend autant de la « plomberie » — la façon dont les modèles communiquent, vérifient, délèguent et échouent avec élégance — que de la capacité brute du réseau de neurones lui-même.



Comments
No comments yet. Be the first!