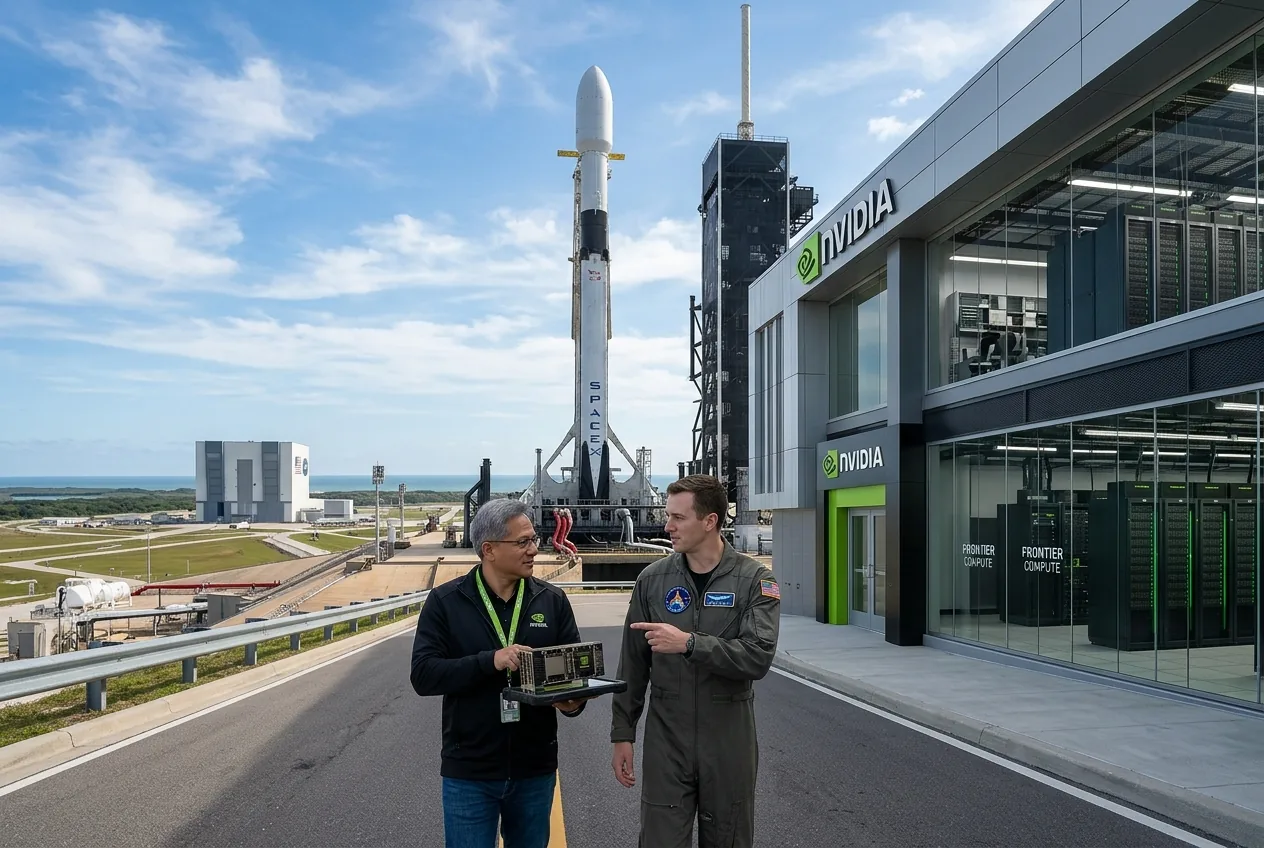
Eine aufsichtsrechtliche Mitteilung an die Securities and Exchange Commission hat enthüllt, dass Nvidia eine 21-Milliarden-Dollar-Beteiligung an SpaceX hält, womit der Luft- und Raumfahrtkonzern von Elon Musk zum zweitgrößten institutionellen Vermögenswert des Chipherstellers aufsteigt. Die Beteiligung, die 122,8 Millionen Aktien der Klasse A umfasst, liegt damit nur hinter Nvidias 22-Milliarden-Dollar-Position bei Intel. Die Transaktion besiegelt eine monumentale industrielle Verbindung: Der weltweit führende Entwickler von paralleler Recheninfrastruktur ist nun grundlegend mit dem primären Betreiber von kommerziellen Startsystemen, orbitalem Satelliten-Breitband und wegweisender künstlicher Intelligenz verflochten.
Die Mechanismen der Transaktion lassen sich auf frühe Kapitalallokationsstrategien innerhalb von Musks industriellem Ökosystem zurückführen. Nvidia investierte ursprünglich 10 Milliarden Dollar in xAI als Teil einer gesamten Finanzierungsrunde von 20 Milliarden Dollar. Als SpaceX anschließend xAI in einer reinen Aktientransaktion im Wert von 1,25 Billionen Dollar integrierte, wandelte sich Nvidias Position direkt in Eigenkapital an dem fusionierten Unternehmen um. Während der reale Marktwert aufgrund von Kursschwankungen mittlerweile bei etwa 17,2 Milliarden Dollar liegt, geht die strategische Tragweite des Deals weit über eine standardmäßige Bilanzierung von Eigenkapital hinaus. Er stellt eine beispiellose industrielle Synthese zwischen Hochleistungs-Computing-Pipelines und hochfrequenter Luft- und Raumfahrtfertigung dar.
Die Silizium-Pipeline zur Befeuerung der orbitalen Automatisierung
Moderne Luft- und Raumfahrttechnik im Maßstab von SpaceX ist im Kern ein Problem der Datentechnik und computergestützten Physik. Die Raketenentwicklung basierte historisch auf langwierigen iterativen Testzyklen, bei denen physische Prototypen gefertigt, druckgetestet und oft zerstört wurden, um Belastungsgrenzen zu validieren. Heute stützt sich der Design-Lebenszyklus komplexer Flugobjekte wie der Starship-Oberstufe und des Super-Heavy-Boosters stark auf Strömungssimulationen der Mehrphysik, Echtzeit-Telemetrieverarbeitung und neuronale, KI-gesteuerte autonome Lenkroutinen.
Die Simulation der aerothermischen Belastungen beim Wiedereintritt in die Atmosphäre erfordert die Auflösung von Überschall-Stoßschichten, Grenzschichtturbulenzen und lokalisierten Wärmegradienten über tausenden aktiven Hitzeschutzkacheln hinweg. Diese Probleme der numerischen Strömungsmechanik (CFD) lassen sich direkt auf die Tensor-lastigen, hochparallelen Architekturen abbilden, die von Nvidia perfektioniert wurden. Durch den Betrieb interner Rechencluster, die mit modernster Silizium-Technologie betrieben werden, können Luft- und Raumfahrtingenieure die Geometrien der Brennkammern für Raptor-Triebwerke über Nacht iterieren und Analysen zur transienten Verbrennungsinstabilität durchführen, für die früher Supercomputerzugänge erforderlich waren, die nationalen Verteidigungslaboren vorbehalten waren.
Jenseits der physischen Design-Iterationen erfordert der operative Aufwand der Starlink-Megakonstellation kontinuierliche algorithmische Eingriffe. Die Verwaltung dynamischer optischer Laserverbindungen zwischen Satelliten, phasengesteuerter Beamforming-Antennen am Boden und der Kollisionsvermeidung im Orbit in Echtzeit über tausende aktive Satelliten im niedrigen Erdorbit hinweg erfordert verteilte Intelligenz sowohl an den Edge-Bodenstationen als auch in zentralen Rechenzentren. Die Zusammenführung dieser Rechenanforderungen mit der für wegweisende KI-Modelle erforderlichen Trainingsinfrastruktur schafft einen unersättlichen internen Bedarf an Durchsatz, den handelsübliche Cloud-Angebote nur schwer wirtschaftlich decken können.
Architekturdetails des Vera-Rubin-Einsatzes
Während der ersten Telefonkonferenz zu den Geschäftszahlen von SpaceX bestätigte die Unternehmensführung, dass das Unternehmen die architektonische Entscheidung getroffen habe, seine interne Rechenzentrumskapazität ausschließlich auf der kommenden Vera-Rubin-Plattform von Nvidia aufzubauen. Darüber hinaus gab das Unternehmen an, sich Zusagen für eine erhebliche Zuteilung von Vera-Rubin-GPUs gesichert zu haben, sobald die Fertigung im nächsten Jahr hochfährt. In einer Ära, die von strukturellen Lieferengpässen bei führenden Halbleitergießereien geprägt ist, stellt die Sicherung vorrangiger Wafer-Zuteilungen einen gewaltigen operativen Vorteil dar.
Die Vera-Rubin-Architektur folgt auf die Blackwell-Generation und führt grundlegende mechanische und elektrische Überarbeitungen ein, die darauf ausgelegt sind, die Rechendichte zu maximieren und gleichzeitig den thermischen Widerstand zu verringern. Rubin integriert High Bandwidth Memory (HBM4) der nächsten Generation und nutzt breitere Speicherschnittstellen sowie monolithische 3D-Packaging-Techniken mittels fortschrittlicher Chiplet-on-Wafer-Substrate. Bei speicherintensiven Arbeitslasten – wie großflächigen strukturellen Finite-Elemente-Analysen und der Optimierung von Transformer-Parametern – verhindert der exponentielle Sprung bei der Speicherbandbreite pro Sockel, dass Rechenkerne während massiver Matrix-Lese-Schreib-Zyklen in den Leerlauf geraten.
Die Verbindungs-Topologie stellt den anderen großen operativen Flaschenhals in Hyperscale-Rechenclustern dar. Die Vera-Rubin-Plattform setzt fortschrittliche NVLink-Switches und optische Hochgeschwindigkeitstransceiver ein, die in der Lage sind, den Knoten-zu-Knoten-Durchsatz auf Multi-Terabit-Bandbreiten zu skalieren. Dies ermöglicht es zehntausenden einzelner Prozessoren, sich mechanisch wie eine einzige, kohärente Rechenmaschine zu verhalten. Für SpaceX ist dieses einheitliche Speicher-Fabric entscheidend: Ob bei der Verteilung der Parametergewichte multimodaler wegweisender Modelle oder bei der Verarbeitung tausender gleichzeitiger Telemetriekanäle von orbitaler Hardware – die Datenlatenz muss strikt deterministisch bleiben.
Bilanzdiplomatie und Lieferketten-Reziprozität
Die Offenlegung veranschaulicht eine aggressive Entwicklung darin, wie Nvidia seine enormen operativen Cashflows einsetzt. Anstatt Kapital lediglich durch standardmäßige Aktienrückkäufe zurückzugeben oder Barmittel in niedrig verzinsten Staatsanleihen liegen zu lassen, praktiziert das Unternehmen zunehmend das, was Branchenanalysten als Bilanzdiplomatie bezeichnen. Durch den Erwerb erheblicher Aktienanteile an wichtigen Plattformbauern – zuerst Intel und nun SpaceX – sichert sich Nvidia die hardwareseitige Exklusivität über Generationen hinweg und profitiert gleichzeitig vom Wachstum des Unternehmenswertes seiner größten Kunden.
Dieser symbiotische Kreislauf schafft bedeutende gegenseitige Vorteile. Für SpaceX garantiert die direkte Partnerschaft mit dem Hauptarchitekten für beschleunigtes Rechnen den bevorzugten Zugang zu Silizium-Zuteilungen, die von Cloud-Hyperscalern stark umkämpft sind. Wenn Rechenzentren bei der Taiwan Semiconductor Manufacturing Company (TSMC) auf physische Volumenbegrenzungen stoßen, kann die vorrangige Verteilung der Packaging-Kapazität den Unterschied zwischen der termingerechten Inbetriebnahme einer fortschrittlichen Trainingseinrichtung oder mehrmonatigen Startverzögerungen bedeuten. Die Kapitalbeteiligung stimmt die Bilanz des Lieferanten direkt auf den operativen Erfolg des Kunden ab.
Für Nvidia garantiert die Vereinbarung eine langfristige Bindung an die Architektur. Sobald eine technische Organisation ihre proprietären Simulationspipelines, Software-Treiber und neuronalen Trainingsskripte auf CUDA und proprietären NVLink-Fabrics standardisiert hat, werden die Umstellungskosten prohibitiv. Durch die Unterstützung der SpaceX-Übernahme von xAI mit direkter Eigenkapitalfinanzierung neutralisierte Nvidia das Risiko, dass Musks Unternehmen auf eine kundenspezifische interne ASIC-Entwicklung umschwenken könnten – ein Ansatz, der von Wettbewerbern im gesamten Hyperscale-Technologiesektor aggressiv verfolgt wird.
Industrieller Maßstab trifft auf die Grenze von Energie und Kühlung
Die Übersetzung theoretischer Rechenleistung in operative Hardware erfordert die Lösung belastender physikalischer Einschränkungen im Rechenzentrum. Der Einsatz von Vera-Rubin-Clustern im Gigawatt-Maßstab erfordert ein komplettes Umdenken bei der Stromverteilung, dem mechanischen Packaging und dem thermodynamischen Management. Herkömmliche luftgekühlte Rechenzentrums-Racks, die historisch bei 15 bis 20 Kilowatt pro Schrank ihr Maximum erreichten, sind völlig unfähig, die thermische Abgabe hochdichter, beschleunigter Rechen-Einschübe abzuführen, die mittlerweile routinemäßig 100 Kilowatt pro Rack überschreiten.
Die Anlagen von SpaceX nutzen industrielle Flüssigkeitskühlsysteme mit direkter Chip-Kühlung, die geschlossene Verteilersysteme verwenden, welche dielektrische oder behandelte Flüssigkeiten direkt über kupferne Kühlplatten leiten, die auf dem GPU-Gehäuse montiert sind. Die ingenieurtechnische Disziplin, die erforderlich ist, um massive Flüssigkeitskreisläufe zuverlässig zu betreiben – die Überwachung auf Mikrolecks, das Management von Kavitationsrisiken und die Aufrechterhaltung präziser Fließgeschwindigkeiten unter variierenden thermischen Lasten – spiegelt die für kryogene Trägerraketen entwickelten Flüssigkeitshandhabungssysteme wider. In vielerlei Hinsicht hat die industrielle Maschinenbaukunst, die erforderlich ist, um einen 100.000-GPU-Cluster betriebsbereit zu halten, mehr DNA mit Hochdruck-Raketenleitungen gemeinsam als mit traditioneller Software-IT-Infrastruktur.
Die Stromversorgung stellt eine ebenso gewaltige Herausforderung dar. Die Herunterspannung von Mittelspannung auf die unter einem Volt liegenden Niveaus, die auf Silizium-Ebene erforderlich sind, verursacht schwere Übertragungsverluste, sofern sie nicht durch hocheffiziente Stromschienen-Architekturen und Siliziumkarbid-Leistungswandlungsstufen gesteuert wird. Die Integration von industrieller Fertigungsexpertise durch SpaceX ermöglicht den schnellen Aufbau lokaler elektrischer Unterstationen, automatisierter Kühltürme und modularer Rechenzentrumshallen, was Bereitstellungszeitpläne beschleunigt, für die kommerzielle Betreiber normalerweise mehrere Jahre benötigen.
Die langfristige Synergie von Rechen- und Startkapazitäten
Über die unmittelbaren Anforderungen an Rechenzentren hinaus deutet die Konsolidierung von Rechen-Dominanz und Schwerlast-Weltraumtransport auf eine längerfristige industrielle Konvergenz hin. Die weltweite Nachfrage nach Rechenleistung kollidiert zunehmend mit terrestrischen Einschränkungen bei der Stromnetz-Kapazität, der Verfügbarkeit von Wasserkühlung und physischen Landrechten. Hochdichte Rechenzentren erfordern den dedizierten Zugang zu hunderten Megawatt an kontinuierlicher Grundlastenergie, was Unternehmensbetreiber dazu veranlasst, unkonventionelle Energielösungen zu untersuchen, die von hinter dem Zähler betriebenen Kernkraftwerken bis hin zur netzunabhängigen Gasstromerzeugung reichen.
Nvidias 21-Milliarden-Dollar-Beteiligung bestätigt, dass sich die Trennung zwischen rein softwaregetriebener künstlicher Intelligenz und schwerer industrieller Maschinerie weitgehend aufgelöst hat. Autonome Fertigung, Raketenproduktionsanlagen, die digitale Zwillingsfabriken betreiben, und orbitale Kommunikationskonstellationen konvergieren zu einem einheitlichen technischen Paradigma. Indem Nvidia seine Silizium-Roadmap an das ehrgeizigste schwerindustrielle Unternehmen der Moderne bindet, positioniert es seine Hardware-Architektur nicht nur als Motor für Softwareanwendungen, sondern als grundlegende Rechenschicht für die physische Luft- und Raumfahrttechnik.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!