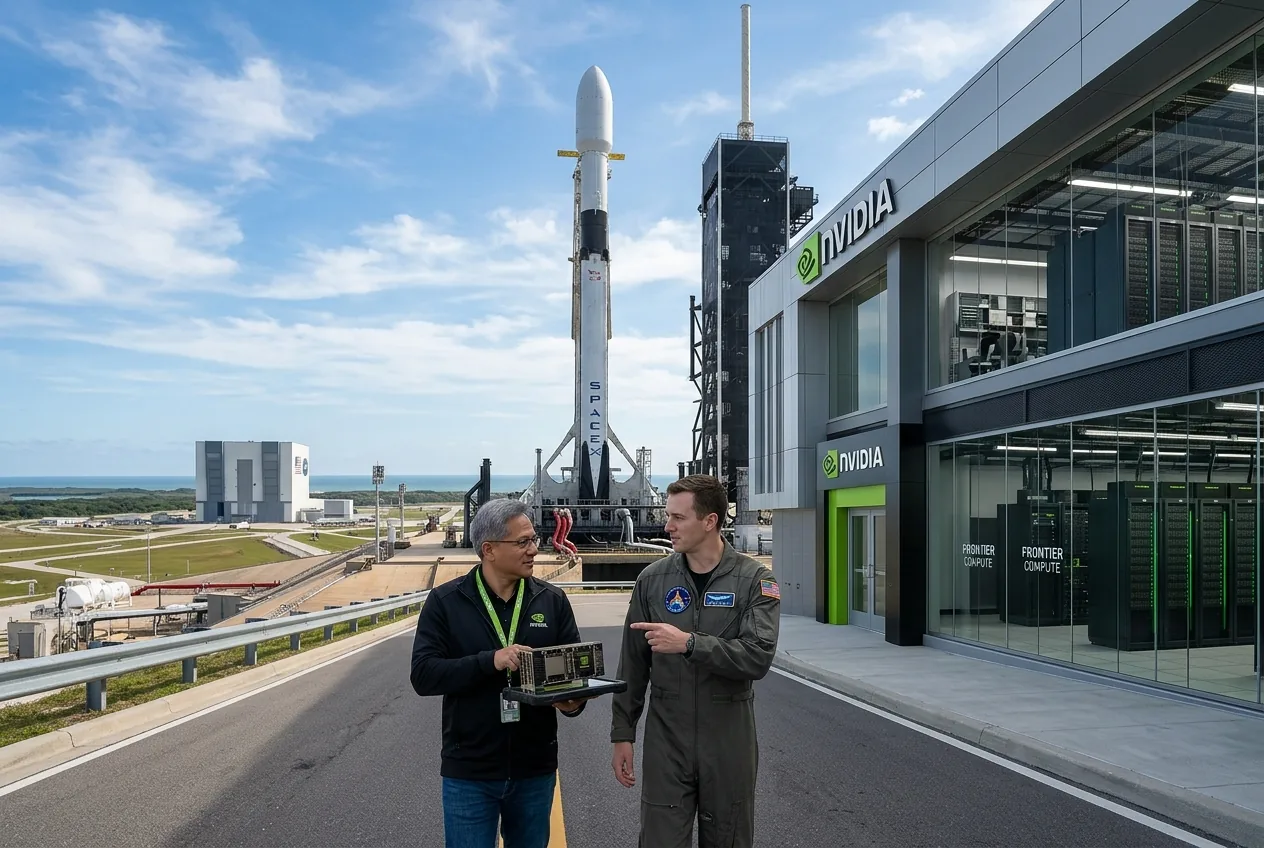
一份提交给美国证券交易委员会(Securities and Exchange Commission)的监管披露文件显示,Nvidia 持有 SpaceX 价值 210 亿美元的股份,这使 Elon Musk 的这家航空航天企业集团成为了这家芯片制造商的第二大机构资产。该持股包含 1.228 亿股 A 类普通股,仅次于 Nvidia 在 Intel 持有的 220 亿美元股份。这笔交易标志着一场具有里程碑意义的工业联姻正式确立:全球最顶尖的并行计算基础设施设计商,现已与商业发射系统、轨道卫星宽带及前沿人工智能领域的主要运营商从根本上深度捆绑。
这笔交易的机制可以追溯到 Musk 工业生态系统早期的资本配置策略。Nvidia 最初向 xAI 投入了 100 亿美元,作为总额 200 亿美元融资轮的一部分。随后,当 SpaceX 以 1.25 万亿美元的全股票交易收购 xAI 时,Nvidia 的持股直接转换为合并后实体的股权。尽管后续的市场价格波动使得该持仓的实时账面价值稳定在 172 亿美元左右,但该交易的战略意义已远远超出了标准的股权会计范畴。它代表了高性能计算流水线与高频次航空航天制造之间前所未有的工业融合。
驱动轨道自动化的硅基管线
达到 SpaceX 这种规模的现代航空航天工程,从根本上来说是一个数据工程和计算物理问题。航空航天研发在历史上依赖冗长的迭代测试周期,即制造物理原型、进行压力测试,并常常通过销毁原型来验证应力极限。如今,诸如 Starship 上级和 Super Heavy 助推器等复杂飞行器的设计生命周期,在很大程度上依赖于多物理场流体动力学模拟、实时遥测处理以及由神经网络驱动的自主引导程序。
模拟大气再入过程中遇到的气动热载荷,需要解析超音速激波层、边界层湍流,以及数千块主动热防护瓦上的局部热梯度。这些计算流体动力学(CFD)问题可以直接映射到由 Nvidia 完善的、张量密集且高度并行的架构上。通过运行由尖端芯片驱动的内部计算集群,航空航天工程师可以在一夜之间迭代 Raptor 发动机的燃烧室几何结构,进行以前需要预留给国防实验室的超级计算机才能完成的瞬态燃烧不稳定性分析。
除了物理设计迭代外,Starlink 巨型卫星星座的运营开销也需要持续的算法干预。管理数千颗在轨低地球轨道卫星之间的动态卫星间光学激光链路、相控阵地面波束导向以及实时轨道防碰撞,需要在边缘地面站和中央处理枢纽之间进行分布式智能处理。将这些计算需求与前沿 AI 模型所需的训练基础设施融合,产生了一种标准商用云服务难以在经济上满足的巨大内部吞吐量需求。
Vera Rubin 部署的架构详情
在 SpaceX 的首次财报电话会议上,公司领导层确认已做出架构决定,将其内部数据中心容量完全构建在 Nvidia 即将推出的 Vera Rubin 平台之上。此外,该公司表示已获得在明年制造规模扩大时获得大量 Vera Rubin GPU 供应的承诺。在领先半导体代工厂面临结构性供应限制的时代,获得优先晶圆分配代表了一项巨大的运营优势。
Vera Rubin 架构是 Blackwell 这一代产品的继任者,引入了根本性的机械和电气改造,旨在最大限度地提高计算密度,同时降低热阻。Rubin 集成了下一代高带宽内存(HBM4),利用更宽的内存接口和通过先进的芯片堆叠(chiplet-on-wafer)基板实现的单片 3D 封装技术。对于受内存带宽限制的工作负载——例如大规模结构有限元分析和 Transformer 参数优化——每个插槽内存带宽的指数级增长,防止了计算核心在海量矩阵读写周期中空转。
互连拓扑是超大规模计算集群中另一个主要的运营瓶颈。Vera Rubin 平台部署了先进的 NVLink 交换机和高速光收发器,能够将节点间的吞吐量扩展至多太比特带宽。这使得数以万计的独立处理器在物理层面能够表现为一个单一的协调计算引擎。对于 SpaceX 而言,这种统一的内存架构至关重要:无论是分发多模态前沿模型的参数权重,还是处理来自在轨硬件的数千个同步遥测通道,数据延迟必须保持严格的确定性。
资产负债表外交与供应链互惠
此次披露展示了 Nvidia 在利用其庞大运营现金流方面的激进演变。该公司没有简单地通过股票回购返还资本,或让现金留存在低收益的主权债券中,而是越来越多地践行行业分析师所称的“资产负债表外交”。通过持有关键平台建设者的大量股权——先是 Intel,现在是 SpaceX——Nvidia 在确保多代硬件排他性的同时,也从其最大客户的企业估值增长中获益。
这种共生循环创造了显著的互惠优势。对于 SpaceX 而言,与加速计算的主要架构师直接合作,保证了其能够优先获得那些被云超大规模运营商争相抢购的硅片配额。当数据中心部署在台积电(TSMC)遇到物理产能限制时,优先分配封装产能可能意味着能否按计划启用先进训练设施,还是面临数季度的投产延迟。股权参与使供应商的资产负债表与客户的运营成功直接挂钩。
对于 Nvidia 而言,该安排保证了长期的架构锁定。一旦工程组织将其专有的模拟管线、软件驱动程序和神经网络训练脚本标准化到 CUDA 和专有的 NVLink 架构上,切换成本就会变得高不可攀。通过以直接股权支持的方式支撑 SpaceX 对 xAI 的收购,Nvidia 消除了 Musk 的公司转向内部定制 ASIC 开发的风险,而这种方法正是超大规模技术领域其他竞争对手正在积极采取的路径。
工业规模与能源及冷却的前沿挑战
将理论计算能力转化为可操作的硬件,需要在数据中心现场解决严苛的物理限制。以吉瓦(gigawatt)规模部署 Vera Rubin 集群,需要彻底重新构想配电、机械封装和热力学管理。传统的风冷数据中心机架历史上最高仅能达到每个机柜 15 到 20 千瓦,已完全无法散发高密度加速计算托盘的热量,后者现在通常超过每个机架 100 千瓦。
SpaceX 的设施采用了工业级直接芯片液体冷却系统,利用闭环歧管将介电或处理过的流体直接循环通过安装在 GPU 封装上的铜制冷板。可靠运行大规模流体回路所需的工程纪律——监测微小泄漏、管理气蚀风险以及在不同热负荷下维持精确的流速——与为低温液体运载火箭开发的流体处理系统如出一辙。在许多方面,维持一个 10 万 GPU 集群运行所需的工业机械工程,其基因与传统软件 IT 基础设施相比,更接近于高压火箭管路系统。
电力输送提出了同样艰巨的挑战。将中压公用电降压至硅片级所需的 1 伏以下水平,如果不是通过超高效的母线架构和碳化硅功率转换级进行管理,将会产生严重的传输损耗。SpaceX 对工业制造专业知识的整合,使其能够快速建设本地化变电站、自动化冷却塔和模块化数据中心大厅,从而加快了那些商业运营商通常需要数年才能完成的部署进度。
计算与发射能力的长远协同效应
放眼眼下的数据中心需求之外,计算优势与重型航天运输能力的整合指向了更长期的工业融合。全球对计算的需求正迅速与陆地上的电网容量限制、水冷却可用性和物理土地权属发生碰撞。高密度数据中心需要专门接入数百兆瓦的持续基荷电力,这促使企业运营商研究非常规的能源解决方案,从表后核电站到离网燃气发电等各种方案。
Nvidia 的 210 亿美元投资证实,纯软件驱动的人工智能与重工业机械之间的界限已基本消失。自主制造、运行数字孪生工厂的火箭生产设施以及轨道通信星座,正在汇聚成一种统一的技术范式。通过将其硅基技术路线图与现代最具雄心的重工业企业挂钩,Nvidia 正在将其硬件架构定位为不仅仅是软件应用的引擎,而是物理航空航天工程的基础计算层。



Comments
No comments yet. Be the first!