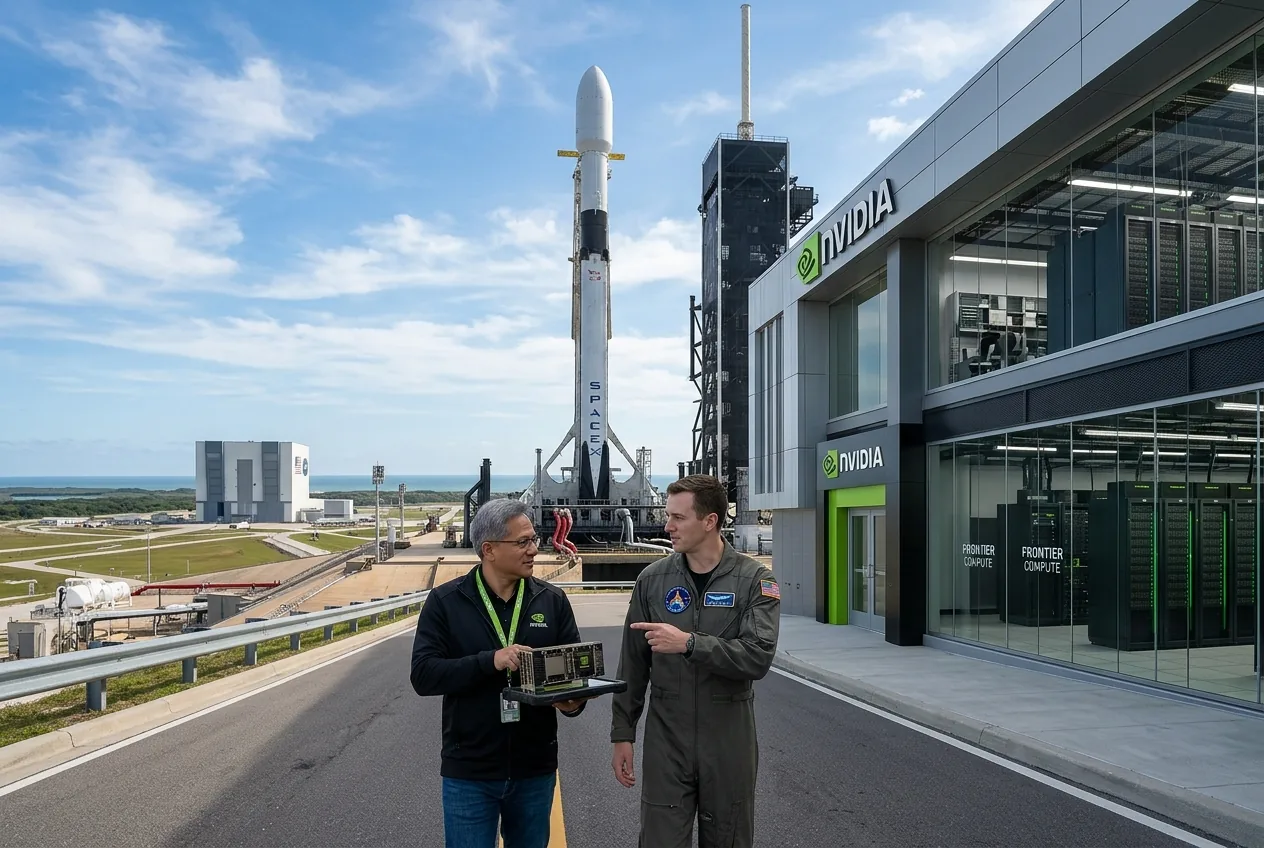
Un documento normativo depositato presso la Securities and Exchange Commission ha rivelato che Nvidia detiene una partecipazione da 21 miliardi di dollari in SpaceX, rendendo il conglomerato aerospaziale di Elon Musk il secondo maggiore asset istituzionale del produttore di chip. Con 122,8 milioni di azioni di Classe A, la quota segue solo la posizione da 22 miliardi di dollari di Nvidia in Intel. La transazione formalizza un monumentale matrimonio industriale: il progettista preminente al mondo di infrastrutture di calcolo parallelo è ora fondamentalmente intrecciato con il principale operatore di sistemi di lancio commerciali, banda larga satellitare orbitale e intelligenza artificiale di frontiera.
Le dinamiche dell'operazione risalgono alle prime strategie di allocazione del capitale all'interno dell'ecosistema industriale di Musk. Nvidia ha originariamente investito 10 miliardi di dollari in xAI come parte di un round di finanziamento complessivo da 20 miliardi di dollari. Quando SpaceX ha successivamente integrato xAI in una transazione interamente azionaria valutata 1,25 trilioni di dollari, la posizione di Nvidia è stata convertita direttamente in capitale nell'entità combinata. Sebbene le successive fluttuazioni dei prezzi di mercato abbiano visto il valore teorico in tempo reale stabilizzarsi intorno ai 17,2 miliardi di dollari, l'impronta strategica dell'accordo si estende ben oltre la contabilità azionaria standard. Rappresenta una sintesi industriale senza precedenti tra pipeline di calcolo ad alte prestazioni e produzione aerospaziale ad alta cadenza.
La pipeline di silicio che alimenta l'automazione orbitale
L'ingegneria aerospaziale moderna su scala SpaceX è fondamentalmente un problema di ingegneria dei dati e fisica computazionale. Storicamente, lo sviluppo dei razzi si è basato su lunghi cicli di test iterativi, in cui i prototipi fisici venivano fabbricati, testati a pressione e spesso distrutti per convalidare i margini di stress. Oggi, il ciclo di vita della progettazione di complessi elementi di volo come lo stadio superiore di Starship e il booster Super Heavy si affida pesantemente a simulazioni di fluidodinamica multi-fisica, elaborazione della telemetria in tempo reale e routine di guida autonoma basate su reti neurali.
Simulare i carichi aerotermici incontrati durante il rientro atmosferico richiede di risolvere strati d'urto supersonici, turbolenze dello strato limite e gradienti di riscaldamento localizzati su migliaia di piastrelle di protezione termica attive. Questi problemi di fluidodinamica computazionale (CFD) si mappano direttamente sulle architetture altamente parallele e pesanti sui tensori perfezionate da Nvidia. Gestendo cluster di calcolo interni alimentati da silicio all'avanguardia, gli ingegneri aerospaziali possono iterare le geometrie della camera di combustione per i motori Raptor durante la notte, eseguendo analisi di instabilità della combustione transitoria che in precedenza richiedevano l'accesso a supercomputer riservati ai laboratori di difesa nazionale.
Oltre all'iterazione del design fisico, l'overhead operativo della megacostellazione Starlink richiede un continuo intervento algoritmico. La gestione di collegamenti laser ottici inter-satellitari dinamici, il beam steering a terra con array di fase e l'evitamento delle collisioni orbitali in tempo reale tra migliaia di satelliti attivi in orbita terrestre bassa richiede un'intelligenza distribuita sia tra le stazioni di terra periferiche che tra gli hub di elaborazione centralizzati. L'unione di queste esigenze computazionali con l'infrastruttura di addestramento richiesta per i modelli di IA di frontiera crea una domanda interna insaziabile di throughput che le offerte cloud commerciali standard faticano a soddisfare economicamente.
Dettagli dell'architettura della distribuzione Vera Rubin
Durante la prima teleconferenza sugli utili di SpaceX, la leadership ha confermato che l'azienda ha preso la decisione architetturale di costruire la propria capacità di data center interna esclusivamente sulla prossima piattaforma Vera Rubin di Nvidia. Inoltre, l'azienda ha indicato di aver ottenuto impegni per un'allocazione significativa di GPU Vera Rubin man mano che la fabbricazione aumenterà il prossimo anno. In un'era segnata da vincoli strutturali di offerta nelle fonderie di semiconduttori all'avanguardia, assicurarsi allocazioni prioritarie di wafer rappresenta un vantaggio operativo formidabile.
L'architettura Vera Rubin succede alla generazione Blackwell, introducendo revisioni meccaniche ed elettriche fondamentali progettate per massimizzare la densità di calcolo mitigando al contempo la resistenza termica. Rubin integra la memoria ad alta larghezza di banda di prossima generazione (HBM4), utilizzando interfacce di memoria più ampie e tecniche di packaging 3D monolitico attraverso substrati avanzati chiplet-on-wafer. Per i carichi di lavoro vincolati dalla memoria, come l'analisi strutturale agli elementi finiti su larga scala e l'ottimizzazione dei parametri dei transformer, il salto esponenziale nella larghezza di banda della memoria per socket impedisce ai core di calcolo di restare inattivi durante i massicci cicli di lettura-scrittura delle matrici.
La topologia di interconnessione rappresenta l'altro principale collo di bottiglia operativo nei cluster di calcolo hyperscale. La piattaforma Vera Rubin implementa switch NVLink avanzati e ricetrasmettitori ottici ad alta velocità in grado di scalare il throughput da nodo a nodo a larghezze di banda multi-terabit. Ciò consente a decine di migliaia di singoli processori di comportarsi meccanicamente come un unico motore di calcolo coerente. Per SpaceX, questo tessuto di memoria unificato è fondamentale: che si tratti di distribuire i pesi dei parametri di modelli multimodali di frontiera o di elaborare migliaia di canali di telemetria simultanei dall'hardware orbitale, la latenza dei dati deve rimanere rigorosamente deterministica.
Diplomazia di bilancio e reciprocità della catena di approvvigionamento
L'informativa illustra un'evoluzione aggressiva nel modo in cui Nvidia sfrutta i suoi immensi flussi di cassa operativi. Piuttosto che limitarsi a restituire capitale attraverso riacquisti di azioni standard o lasciare che la liquidità rimanga in titoli sovrani a basso rendimento, l'azienda ha sempre più praticato quella che gli analisti del settore definiscono diplomazia di bilancio. Assumendo posizioni azionarie sostanziali nei principali costruttori di piattaforme — prima Intel e ora SpaceX — Nvidia si assicura l'esclusività hardware multi-generazionale beneficiando contemporaneamente della crescita della valutazione aziendale dei suoi maggiori clienti.
Questo ciclo simbiotico crea significativi vantaggi reciproci. Per SpaceX, collaborare direttamente con il principale architetto del calcolo accelerato garantisce un accesso preferenziale ad allocazioni di silicio che sono fortemente contese dagli hyperscaler cloud. Quando le implementazioni dei data center incontrano vincoli fisici di volume presso la Taiwan Semiconductor Manufacturing Company (TSMC), la distribuzione prioritaria della capacità di packaging può fare la differenza tra l'attivazione di una struttura di addestramento avanzata nei tempi previsti o l'affrontare ritardi di lancio di diversi trimestri. La partecipazione azionaria allinea direttamente il bilancio del fornitore al successo operativo del cliente.
Per Nvidia, l'accordo garantisce un blocco architetturale a lungo termine. Una volta che un'organizzazione ingegneristica standardizza le sue pipeline di simulazione proprietarie, i driver software e gli script di addestramento neurale su CUDA e sui tessuti NVLink proprietari, i costi di transizione diventano proibitivi. Sostenendo l'acquisizione di xAI da parte di SpaceX con un supporto azionario diretto, Nvidia ha neutralizzato il rischio che le aziende di Musk virassero verso lo sviluppo di ASIC interni personalizzati, un approccio perseguito in modo aggressivo dai peer nel settore tecnologico hyperscale.
La scala industriale incontra la frontiera dell'energia e del raffreddamento
Tradurre la potenza computazionale teorica in hardware operativo richiede di risolvere punitivi vincoli fisici sul pavimento del data center. Implementare cluster Vera Rubin su scala gigawatt richiede una completa reinvenzione della distribuzione energetica, del packaging meccanico e della gestione termodinamica. I tradizionali rack per data center raffreddati ad aria, che storicamente raggiungevano un massimo di 15-20 kilowatt per armadio, sono del tutto incapaci di dissipare l'output termico dei vassoi di calcolo accelerato ad alta densità, che ora superano abitualmente i 100 kilowatt per rack.
Le strutture di SpaceX utilizzano sistemi di raffreddamento a liquido industriale diretto al chip, impiegando collettori a circuito chiuso che fanno circolare fluidi dielettrici o trattati direttamente attraverso piastre fredde in rame montate sul packaging della GPU. La disciplina ingegneristica richiesta per far funzionare in modo affidabile enormi circuiti fluidi — monitorando micro-perdite, gestendo i rischi di cavitazione e sostenendo velocità di flusso precise sotto carichi termici variabili — rispecchia i sistemi di gestione dei fluidi sviluppati per i veicoli di lancio criogenici. Per molti aspetti, l'ingegneria meccanica industriale necessaria per mantenere operativo un cluster da 100.000 GPU condivide più DNA con l'impiantistica dei razzi ad alta pressione che con la tradizionale infrastruttura IT software.
L'erogazione di energia presenta una sfida altrettanto formidabile. Ridurre la potenza di rete a media tensione ai livelli inferiori al volt richiesti a livello di die di silicio comporta gravi perdite di trasmissione se non gestita attraverso architetture a barre colletrici ultra-efficienti e stadi di conversione di potenza al carburo di silicio. L'integrazione da parte di SpaceX dell'esperienza nella produzione industriale consente una rapida costruzione di sottostazioni elettriche localizzate, torri di raffreddamento automatizzate e sale dati modulari, accelerando le tempistiche di implementazione che solitamente richiedono agli operatori commerciali diversi anni per essere completate.
La sinergia a lungo raggio tra calcolo e capacità di lancio
Guardando oltre le immediate esigenze dei data center, il consolidamento del dominio del calcolo e del trasporto spaziale pesante punta verso una convergenza industriale a lungo termine. La domanda globale di calcolo si sta scontrando rapidamente con i limiti terrestri sulla capacità della rete elettrica, la disponibilità di raffreddamento ad acqua e i diritti territoriali fisici. I data center ad alta densità richiedono un accesso dedicato a centinaia di megawatt di potenza di base continua, spingendo gli operatori aziendali a studiare soluzioni energetiche non convenzionali che spaziano dagli impianti nucleari "behind-the-meter" alla generazione di gas off-grid.
La partecipazione da 21 miliardi di dollari di Nvidia conferma che la divisione tra l'intelligenza artificiale puramente guidata dal software e i macchinari industriali pesanti si è in gran parte dissolta. La produzione autonoma, gli impianti di produzione di razzi che gestiscono fabbriche di gemelli digitali e le costellazioni di comunicazione orbitale stanno convergendo in un paradigma tecnico unificato. Ancorando la sua roadmap del silicio all'impresa industriale pesante più ambiziosa dell'era moderna, Nvidia sta posizionando la sua architettura hardware non semplicemente come motore di applicazioni software, ma come lo strato di calcolo fondamentale per l'ingegneria aerospaziale fisica.



Comments
No comments yet. Be the first!