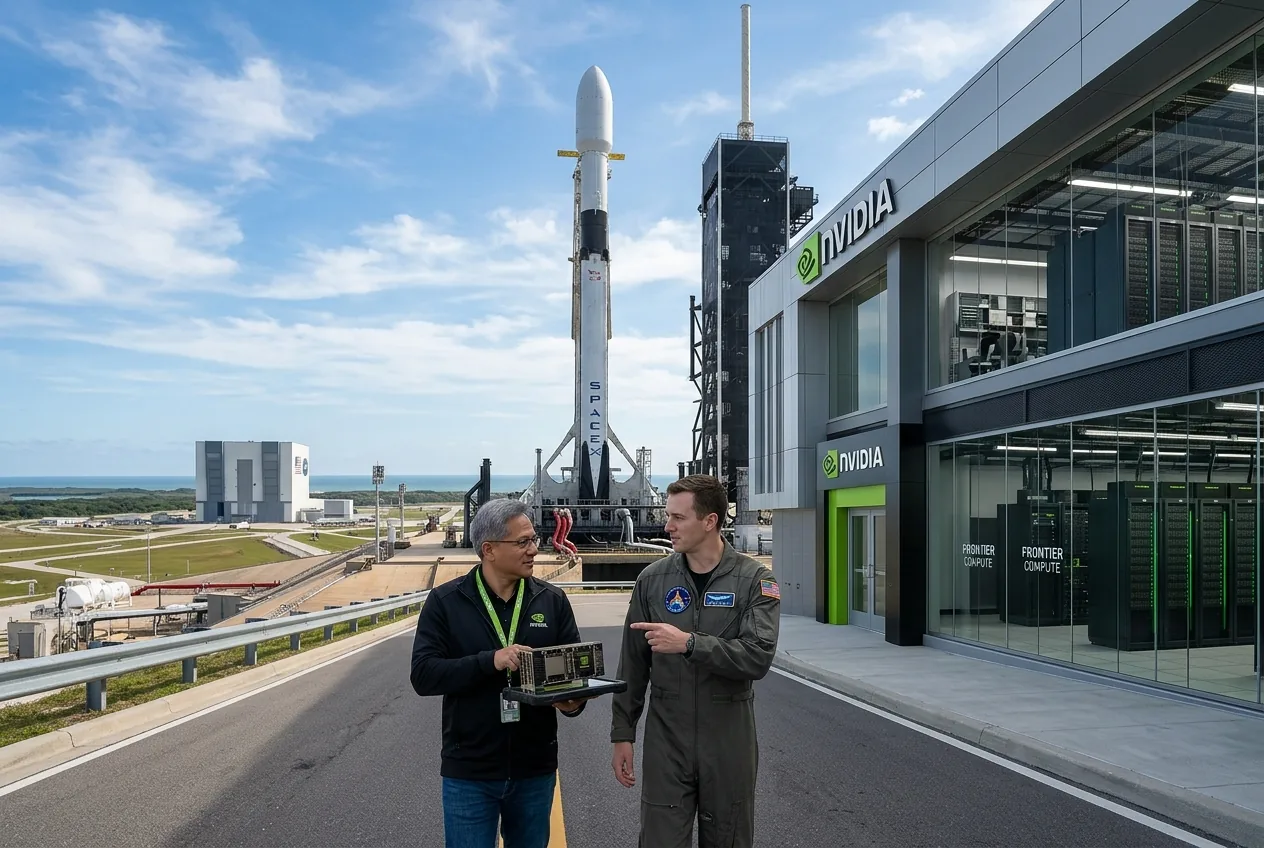
Un document réglementaire déposé auprès de la Securities and Exchange Commission a révélé que Nvidia détient une position de 21 milliards de dollars dans SpaceX, faisant du conglomérat aérospatial d'Elon Musk le deuxième plus grand actif institutionnel du fabricant de puces. Avec 122,8 millions d'actions de classe A, cette participation ne devance que la position de 22 milliards de dollars de Nvidia dans Intel. La transaction officialise un mariage industriel monumental : le concepteur d'infrastructures de calcul parallèle le plus éminent au monde est désormais fondamentalement lié au principal opérateur de systèmes de lancement commerciaux, de haut débit par satellite en orbite et d'intelligence artificielle de pointe.
Les mécanismes de la transaction remontent aux premières stratégies d'allocation de capital au sein de l'écosystème industriel de Musk. Nvidia a initialement investi 10 milliards de dollars dans xAI dans le cadre d'un tour de financement global de 20 milliards de dollars. Lorsque SpaceX a par la suite intégré xAI dans une transaction tout en actions évaluée à 1 250 milliards de dollars, la position de Nvidia a été directement convertie en actions de l'entité combinée. Bien que les fluctuations ultérieures du marché aient ramené la valeur théorique en temps réel autour de 17,2 milliards de dollars, l'empreinte stratégique de l'opération s'étend bien au-delà de la comptabilité des capitaux propres standard. Elle représente une synthèse industrielle sans précédent entre les pipelines de calcul haute performance et la fabrication aérospatiale à haute cadence.
Le pipeline de silicium alimentant l'automatisation orbitale
L'ingénierie aérospatiale moderne à l'échelle de SpaceX est fondamentalement un problème d'ingénierie des données et de physique computationnelle. Le développement de fusées reposait historiquement sur de longs cycles de tests itératifs, où des prototypes physiques étaient fabriqués, soumis à des tests de pression et souvent détruits pour valider les marges de résistance. Aujourd'hui, le cycle de vie de conception d'articles de vol complexes tels que l'étage supérieur du Starship et le booster Super Heavy repose largement sur des simulations de dynamique des fluides multi-physiques, le traitement de télémétrie en temps réel et des routines de guidage autonome pilotées par réseaux neuronaux.
Simuler les charges aérothermiques rencontrées lors de la rentrée atmosphérique nécessite de résoudre les couches de choc supersoniques, la turbulence des couches limites et les gradients de chaleur localisés sur des milliers de tuiles de protection thermique actives. Ces problèmes de dynamique des fluides computationnelle (CFD) correspondent directement aux architectures hautement parallèles et riches en tenseurs perfectionnées par Nvidia. En exploitant des clusters de calcul internes alimentés par du silicium de pointe, les ingénieurs aérospatiaux peuvent itérer les géométries de chambre de combustion des moteurs Raptor pendant la nuit, en exécutant des analyses d'instabilité de combustion transitoire qui nécessitaient auparavant un accès à des superordinateurs réservés aux laboratoires de défense nationale.
Au-delà de l'itération de la conception physique, la charge opérationnelle de la mégaconstellation Starlink exige une intervention algorithmique continue. La gestion des liaisons laser optiques dynamiques inter-satellites, le pilotage de faisceaux au sol à réseau phasé et l'évitement des collisions orbitales en temps réel sur des milliers de satellites en orbite terrestre basse nécessitent une intelligence distribuée à la fois sur les stations au sol en périphérie et sur les hubs de traitement centralisés. Fusionner ces besoins computationnels avec l'infrastructure de formation requise pour les modèles d'IA de pointe établit une demande interne insatiable de débit que les offres cloud marchandes standard peinent à satisfaire de manière économique.
Détails architecturaux du déploiement Vera Rubin
Lors de la première conférence sur les résultats de SpaceX, la direction a confirmé que l'entreprise avait pris la décision architecturale de construire sa capacité de centre de données interne exclusivement sur la plateforme Vera Rubin à venir de Nvidia. De plus, l'entreprise a indiqué avoir obtenu des engagements pour une allocation significative de GPU Vera Rubin à mesure que la fabrication augmentera l'année prochaine. À une époque marquée par des contraintes d'approvisionnement structurelles chez les fonderies de semi-conducteurs de pointe, garantir des allocations de plaquettes prioritaires représente un avantage opérationnel formidable.
L'architecture Vera Rubin succède à la génération Blackwell, introduisant des refontes mécaniques et électriques fondamentales conçues pour maximiser la densité de calcul tout en atténuant la résistance thermique. Rubin intègre la mémoire à large bande passante de nouvelle génération (HBM4), utilisant des interfaces mémoire plus larges et des techniques de packaging 3D monolithique via des substrats avancés de type chiplet-on-wafer. Pour les charges de travail limitées par la mémoire — telles que l'analyse par éléments finis structurels à grande échelle et l'optimisation des paramètres de transformateurs — le saut exponentiel de la bande passante mémoire par socket empêche les cœurs de calcul de rester inactifs pendant les cycles massifs de lecture-écriture de matrices.
La topologie d'interconnexion représente l'autre goulot d'étranglement opérationnel majeur des clusters de calcul hyperscale. La plateforme Vera Rubin déploie des commutateurs NVLink avancés et des émetteurs-récepteurs optiques haute vitesse capables de faire évoluer le débit nœud à nœud vers des bandes passantes multi-térabits. Cela permet à des dizaines de milliers de processeurs individuels de se comporter mécaniquement comme un seul moteur de calcul cohérent. Pour SpaceX, ce tissu mémoire unifié est critique : qu'il s'agisse de distribuer les poids de paramètres de modèles multimodaux de pointe ou de traiter des milliers de canaux de télémétrie simultanés provenant de matériel orbital, la latence des données doit rester strictement déterministe.
Diplomatie du bilan et réciprocité de la chaîne d'approvisionnement
La divulgation illustre une évolution agressive dans la manière dont Nvidia exploite ses immenses flux de trésorerie opérationnels. Plutôt que de simplement restituer du capital par le biais de rachats d'actions standard ou de laisser la trésorerie dormir dans des titres souverains à faible rendement, l'entreprise pratique de plus en plus ce que les analystes industriels appellent la diplomatie du bilan. En prenant des participations substantielles dans des constructeurs de plateformes clés — d'abord Intel, et maintenant SpaceX — Nvidia sécurise une exclusivité matérielle multi-générationnelle tout en bénéficiant simultanément de la croissance de la valorisation d'entreprise de ses plus gros clients.
Cette boucle symbiotique crée des avantages réciproques significatifs. Pour SpaceX, s'associer directement avec l'architecte principal du calcul accéléré garantit un accès préférentiel à des allocations de silicium fortement contestées par les hyperscalers cloud. Lorsque les déploiements de centres de données se heurtent à des contraintes de volume physique chez Taiwan Semiconductor Manufacturing Company (TSMC), la distribution prioritaire de la capacité de packaging peut faire la différence entre l'activation d'une installation de formation avancée dans les délais ou faire face à des retards de lancement de plusieurs trimestres. La participation au capital aligne directement le bilan du fournisseur sur le succès opérationnel du client.
Pour Nvidia, l'accord garantit un verrouillage architectural à long terme. Une fois qu'une organisation d'ingénierie standardise ses pipelines de simulation propriétaires, ses pilotes logiciels et ses scripts d'entraînement neuronaux sur CUDA et les tissus NVLink propriétaires, les coûts de changement deviennent prohibitifs. En soutenant l'acquisition de xAI par SpaceX avec un soutien direct en capital, Nvidia a neutralisé le risque que les entreprises de Musk ne se tournent vers le développement d'ASIC internes personnalisés, une approche agressivement poursuivie par les pairs du secteur technologique hyperscale.
L'échelle industrielle rencontre la frontière de l'énergie et du refroidissement
Traduire la puissance de calcul théorique en matériel opérationnel nécessite de résoudre des contraintes physiques punitives au niveau du sol du centre de données. Le déploiement de clusters Vera Rubin à l'échelle du gigawatt exige une réimagination complète de la distribution d'énergie, du conditionnement mécanique et de la gestion thermodynamique. Les racks de centres de données refroidis par air traditionnels, qui atteignaient historiquement un maximum de 15 à 20 kilowatts par armoire, sont totalement incapables de dissiper la production thermique des plateaux de calcul accéléré haute densité, qui dépassent désormais couramment les 100 kilowatts par rack.
Les installations de SpaceX utilisent des systèmes de refroidissement liquide industriels directement sur la puce, utilisant des collecteurs en boucle fermée qui font circuler des fluides diélectriques ou traités directement sur des plaques froides en cuivre montées sur le packaging du GPU. La discipline d'ingénierie nécessaire pour faire fonctionner des boucles de fluide massives de manière fiable — surveiller les micro-fuites, gérer les risques de cavitation et maintenir des vitesses d'écoulement précises sous des charges thermiques variables — reflète les systèmes de gestion des fluides développés pour les véhicules de lancement cryogéniques. À bien des égards, l'ingénierie mécanique industrielle nécessaire pour maintenir un cluster de 100 000 GPU opérationnel partage plus d'ADN avec la plomberie des fusées haute pression qu'avec l'infrastructure informatique logicielle traditionnelle.
La fourniture d'énergie présente un défi tout aussi redoutable. Abaisser la puissance utilitaire moyenne tension aux niveaux inférieurs au volt requis au niveau de la puce de silicium entraîne de graves pertes de transmission si elle n'est pas gérée par des architectures de barres omnibus ultra-efficaces et des étages de conversion de puissance en carbure de silicium. L'intégration par SpaceX de l'expertise en fabrication industrielle permet une construction rapide de sous-stations électriques localisées, de tours de refroidissement automatisées et de halls de centres de données modulaires, accélérant les délais de déploiement qui prennent généralement plusieurs années aux opérateurs commerciaux.
La synergie à longue portée entre calcul et capacités de lancement
Au-delà des besoins immédiats des centres de données, la consolidation de la domination informatique et du transport spatial lourd pointe vers une convergence industrielle à plus long terme. La demande mondiale en informatique se heurte rapidement aux limitations terrestres en matière de capacité du réseau électrique, de disponibilité du refroidissement par eau et de droits fonciers physiques. Les centres de données haute densité nécessitent un accès dédié à des centaines de mégawatts de puissance de base continue, incitant les opérateurs d'entreprise à étudier des solutions énergétiques non conventionnelles allant des centrales nucléaires derrière le compteur à la production de gaz hors réseau.
La participation de 21 milliards de dollars de Nvidia confirme que la division entre l'intelligence artificielle purement logicielle et les machines industrielles lourdes s'est largement dissoute. La fabrication autonome, les installations de production de fusées exploitant des usines de jumeaux numériques et les constellations de communication orbitale convergent vers un paradigme technique unifié. En ancrant sa feuille de route en silicium à l'entreprise industrielle lourde la plus ambitieuse de l'ère moderne, Nvidia positionne son architecture matérielle non seulement comme le moteur des applications logicielles, mais comme la couche de calcul fondamentale pour l'ingénierie aérospatiale physique.



Comments
No comments yet. Be the first!