Im Maschinenbau gilt rohe Gewalt selten als ingenieurtechnische Glanzleistung; sie ist meist ein Eingeständnis ineffizienten Designs. Bei der Konstruktion eines Antriebsstrangs oder eines automatisierten Portalsystems führt die Montage eines überdimensionierten Motors, wo ein präziser, leichter Servo ausreichen würde, zu parasitärer Masse, thermischer Drosselung und unnötigen Investitionskosten. In den letzten vier Jahren folgte die Spitzenforschung im Bereich der Künstlichen Intelligenz weitgehend der gegenteiligen Philosophie: Man warf maximale Rechenleistung auf einen einzigen, monolithischen Parameterraum, nutzte emergente Fähigkeiten und zwang jedes operative Problem durch denselben rechenintensiven Prozess.
Das Debüt der GPT-5.6-Generation – systematisch unterteilt in die Stufen Sol, Terra und Luna – signalisiert, dass diese Ära der rohen Gewalt ihre ökonomischen und architektonischen Grenzen erreicht hat. OpenAI präsentiert Spitzenintelligenz nicht länger als universellen Hammer. Stattdessen behandelt das Unternehmen die Inferenz als geschichtete mechanische Baugruppe und bietet drei unterschiedliche Profile für Rechenleistung und Latenz an, die alles von tiefer theoretischer Synthese bis hin zu deterministischen Echtzeit-Steuerungsschleifen abdecken.
Für Unternehmensentwickler und Hardware-Ingenieure markiert dieser Übergang den Punkt, an dem generative Modelle aufhören, sich wie spekulative Forschungsobjekte zu verhalten, und beginnen, sich in die strengen Anforderungen physischer Infrastrukturen, industrieller Automatisierung und Edge-to-Cloud-Telemetrie zu integrieren.
Dekonstruktion der Triade: Sol, Terra und Luna
Die GPT-5.6-Veröffentlichung unterteilt die Fähigkeiten entlang expliziter Vektoren: Parameterdichte, Inferenzlatenz, Bandbreiten-Overhead des Speichers und Tokens-pro-Watt-Verbrauch. Anstatt Unternehmen zu zwingen, Kompromisse durch Downsampling auf Prompt-Ebene oder aggressive dynamische Quantisierung bei einem einzigen Flaggschiffmodell einzugehen, hat OpenAI die zugrunde liegenden Gewichte und Ausführungstopologien stratifiziert.
Sol bildet die rechnerische Spitze. Es ist für langfristige Planung, mehrstufige formale Verifikation und intensive symbolische Schlussfolgerungen ausgelegt. Praktisch fungiert Sol als asynchrone Analyse-Engine. Durch den Betrieb mit erweiterten Reasoning-Buffern und fortschrittlichem Mixture-of-Experts (MoE)-Routing tauscht es unmittelbaren Durchsatz gegen algorithmische Präzision. In Tests zu komplexer mechanischer Kinematik, rekursiver Fehler-Modus-Analyse und komplexer Code-Kompilierung in verteilten Systemen repräsentiert Sol den Höhepunkt der synthetischen Denkfähigkeiten von OpenAI. Aufgrund seines hohen Rechenaufwands und Latenzprofils ist es jedoch zwangsläufig auf das Cloud-Segment beschränkt, was es zu einer Engine für Strategie statt für unmittelbare Ausführung macht.
Terra dient als operative Basis – die direkte Antwort auf Unternehmensanfragen nach einem verlässlichen Arbeitstier mit hohem Durchsatz. Durch die Balance zwischen Parameterskala und Ausführungsgeschwindigkeit optimiert Terra die Token-Ökonomie für strukturierte Arbeitsabläufe: Live-Daten-Ingestion, ERP-Automatisierung, synthetische Telemetrie-Überwachung und die Synthese von Zwischendokumenten. Es bewahrt genügend kontextuelle Genauigkeit, um fachspezifische Ontologien zu erfassen, ohne die für Flaggschiff-Netzwerke typischen mehsekündigen Verzögerungen bis zum ersten Token zu verursachen. Für Lieferketten in der Fertigung, die Rohmaterialströme nachverfolgen, oder Logistikzentren, die dynamische Dispositionen verwalten, bietet Terra den pragmatischen Mittelweg zwischen kognitiver Tiefe und operativer Geschwindigkeit.
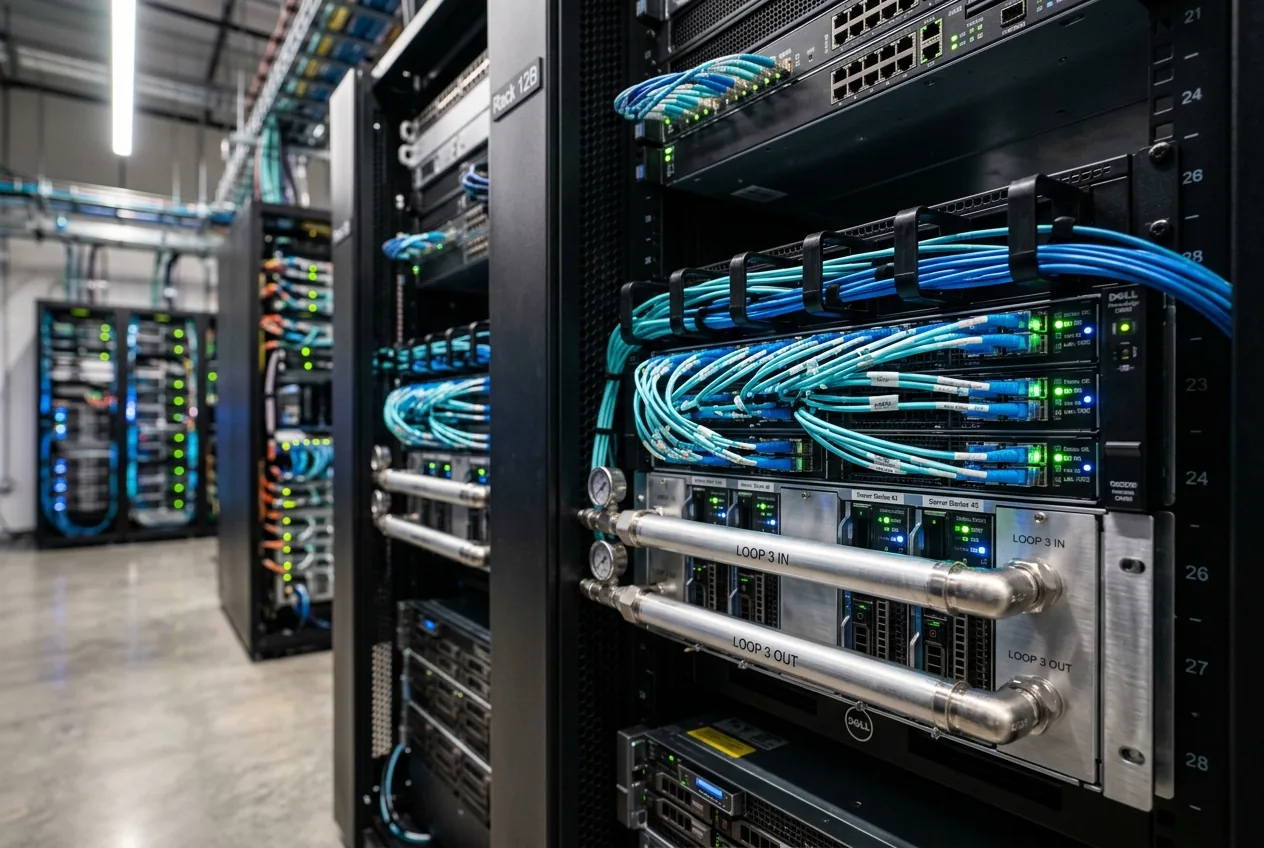
Luna stellt die kritischste taktische Verschiebung für eingebettete und physische Systeme dar. Befreit von überflüssigem Parameterballast und optimiert für extreme Quantisierung – voraussichtlich bis hinunter auf 4-Bit- und 8-Bit-Ausführungsprofile – ist Luna für Aufgaben mit geringer Latenz und hoher Frequenz konzipiert. Mit Antwortzeiten, die konsequent auf die Schwelle unter 50 Millisekunden abzielen, ist dieses Modell für den Betrieb auf lokalen Hardware-Beschleunigern, Rack-Servern in der Fertigung und robusten Edge-Appliances ausgelegt. Luna ist nicht dazu gebaut, philosophische Abhandlungen zu verfassen; es ist auf sofortige Klassifizierung, Echtzeit-Sensoranomalieerkennung, Sprachschnittstellen-Mediation und geschlossene Roboter-Steuerungsbefehle kalibriert.
Die Realität der Speicherbandbreite und Inferenzökonomie
Um zu verstehen, warum OpenAI GPT-5.6 in drei verschiedene Engines aufgeteilt hat, muss man über Software-Benchmarks hinaus die Realität der Silizium-Hardware betrachten. Der limitierende Faktor der modernen Spitzen-KI ist nicht die Rechenleistung im Abstrakten; es ist die Speicherbandbreite. Moderne Beschleuniger-Cluster – ob auf Basis von Nvidias H100-, H200- oder den neueren Blackwell B200-Plattformen – sind bei der sequenziellen Generierung von Token grundlegend durch den Durchsatz des High-Bandwidth Memory (HBM) eingeschränkt.
Wenn eine Roboterzelle oder ein automatisiertes Lagerverwaltungssystem einen kontinuierlichen Telemetriestrom an ein monolithisches Modell sendet, muss die Hardware für jedes einzelne generierte Token Billionen von Parametern aus dem Speicher lesen. Dies auf einem Sol-Netzwerk für einfache Statusüberprüfungen durchzuführen, ist ökonomisch nicht tragbar. Es belastet Stromnetze, verbraucht Kühlkapazitäten und treibt die API-Kosten auf ein Niveau, das die Rentabilitätsberechnungen für Industrieinvestitionen zunichtemacht.
Wird Multi-Tier-Orchestrierung fragile industrielle Pipelines zerstören?
Obwohl die architektonische Logik der GPT-5.6-Familie schlüssig ist, bringt die Übersetzung eines gestuften Modell-Ökosystems in zuverlässigen Produktionscode schwerwiegende Integrationsherausforderungen mit sich. In der Softwaretechnik ist die Statusverwaltung über verschiedene Systeme hinweg bekanntermaßen fragil. Die Verteilung von Reasoning auf Luna, Terra und Sol erfordert eine Orchestrierungsschicht, die in der Lage ist, Abfragen dynamisch zu routen, ohne selbst zum Single Point of Failure zu werden.
Wenn eine Fertigungsstraße auf Luna für unmittelbare sensorische Analysen angewiesen ist, müssen Entwickler deterministische Übergabeprotokolle definieren. Ab welchem Punkt führt eine Fehlerschwelle dazu, dass Luna eine Aufgabe an Terra eskaliert? Wenn Terra auf einen mehrdeutigen Zustand stößt und an Sol delegiert, wie bewältigt das System die Latenzdifferenz, ohne dass mechanische Hardware auf eine Antwort warten muss und dabei stillsteht? In physischen Systemen kann eine inkonsistente Zeitgebung – bekannt als Jitter – katastrophal sein. Erlebt eine automatisierte Fertigungslinie unvorhersehbare Verzögerungen bei der Token-Generierung während des Wechsels zwischen den Modellen, muss die physische Linie entweder verlangsamt werden oder sie riskiert mechanische Kollisionen.
Darüber hinaus bleibt die Prompt- und Kontext-Parität zwischen den Stufen eine ungelöste Herausforderung. Ein Prompt, der für das nuancierte Verständnis von Sol mit hohen Parametern optimiert ist, kann versagen oder Halluzinationen erzeugen, wenn er gekürzt und von Lunas destillierter Architektur verarbeitet wird. Ingenieurteams werden für jede einzelne Modellebene unterschiedliche Prompt-Sets, Schemata und Sicherheitsvorgaben validieren müssen, was die Pipelines für Continuous Integration und Deployment verkompliziert.
Die Reifung vom Forschungsphänomen zum Industriestandard
Für Technologieführer erfordert das Aufkommen dieser gestuften Architektur eine Neubewertung aktueller KI-Roadmaps. Die erfolgreichsten Systeme werden nicht diejenigen sein, die einfach die größten und teuersten verfügbaren API-Endpunkte abonnieren. Vielmehr wird der Wettbewerbsvorteil bei den Ingenieuren liegen, die die Modell-Orchestrierung beherrschen – sie routen die richtigen Token zum richtigen Zeitpunkt auf das richtige Silizium und balancieren Kosten, Geschwindigkeit und Intelligenz mit mechanischer Präzision aus.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!