En ingeniería mecánica, la fuerza bruta rara vez es un logro de ingeniería; suele ser una admisión de diseño ineficiente. Al diseñar una transmisión o un sistema de pórtico automatizado, instalar un motor sobredimensionado donde bastaría un servomotor preciso y ligero introduce masa parasitaria, estrangulamiento térmico y gastos de capital innecesarios. Durante los últimos cuatro años, la inteligencia artificial de frontera ha operado en gran medida bajo la filosofía opuesta: aplicar la máxima potencia de cálculo a un espacio de parámetros singular y monolítico, recolectar capacidades emergentes y forzar cada problema operativo a través del mismo conducto computacionalmente costoso.
El debut de la generación GPT-5.6 —dividida sistemáticamente en los niveles Sol, Terra y Luna— señala que esta época de fuerza bruta está alcanzando sus límites económicos y arquitectónicos. OpenAI ya no presenta la inteligencia de frontera como un martillo universal. En cambio, la empresa está tratando la inferencia como un ensamblaje mecánico por capas, ofreciendo tres perfiles distintos de cómputo y latencia diseñados para dar cabida a todo, desde la síntesis teórica profunda hasta los bucles de control deterministas en tiempo real.
Para los desarrolladores empresariales y los ingenieros de sistemas de hardware, esta transición marca el punto en el que los modelos generativos dejan de comportarse como artefactos de investigación especulativa y comienzan a integrarse en las estrictas restricciones de la infraestructura física, la automatización industrial y la telemetría del borde a la nube (edge-to-cloud).
Deconstruyendo la tríada: Sol, Terra y Luna
El lanzamiento de GPT-5.6 divide las capacidades en vectores explícitos: densidad de parámetros, latencia de inferencia, sobrecarga de ancho de banda de memoria y consumo de tokens por vatio. En lugar de obligar a las empresas a aceptar concesiones mediante el muestreo descendente (downsampling) a nivel de prompt o la cuantización dinámica agresiva en un único modelo insignia, OpenAI ha estratificado los pesos subyacentes y las topologías de ejecución.
Sol ocupa el vértice computacional. Está diseñado para la planificación a largo plazo, la verificación formal de múltiples pasos y el razonamiento simbólico intensivo. En términos prácticos, Sol funciona como un motor analítico asíncrono. Al operar con búferes de razonamiento extendidos y un enrutamiento avanzado de mezcla de expertos (MoE), intercambia el rendimiento inmediato por fidelidad algorítmica. En pruebas que involucran cinemática mecánica compleja, análisis recursivo de modos de falla y compilación de código complejo en sistemas distribuidos, Sol representa la cima de las capacidades de razonamiento sintético de OpenAI. Sin embargo, su alta huella computacional y perfil de latencia lo confinan inherentemente al nivel de nube, convirtiéndolo en un motor de estrategia más que de ejecución inmediata.
Terra sirve como la base operativa: la respuesta directa a las solicitudes empresariales de un caballo de batalla confiable y de alto rendimiento. Equilibrando la escala de parámetros con la velocidad de ejecución, Terra optimiza la economía de tokens para flujos de trabajo estructurados: ingesta de datos en vivo, automatización de ERP empresarial, monitoreo de telemetría sintética y síntesis de documentos intermedios. Mantiene suficiente fidelidad contextual para comprender ontologías específicas del dominio sin incurrir en los retrasos de varios segundos para el primer token que caracterizan a las redes de razonamiento insignia. Para las cadenas de suministro de fabricación que rastrean el enrutamiento de materias primas o los centros logísticos que gestionan el despacho dinámico, Terra ofrece el punto medio pragmático entre la profundidad cognitiva y la velocidad operativa.
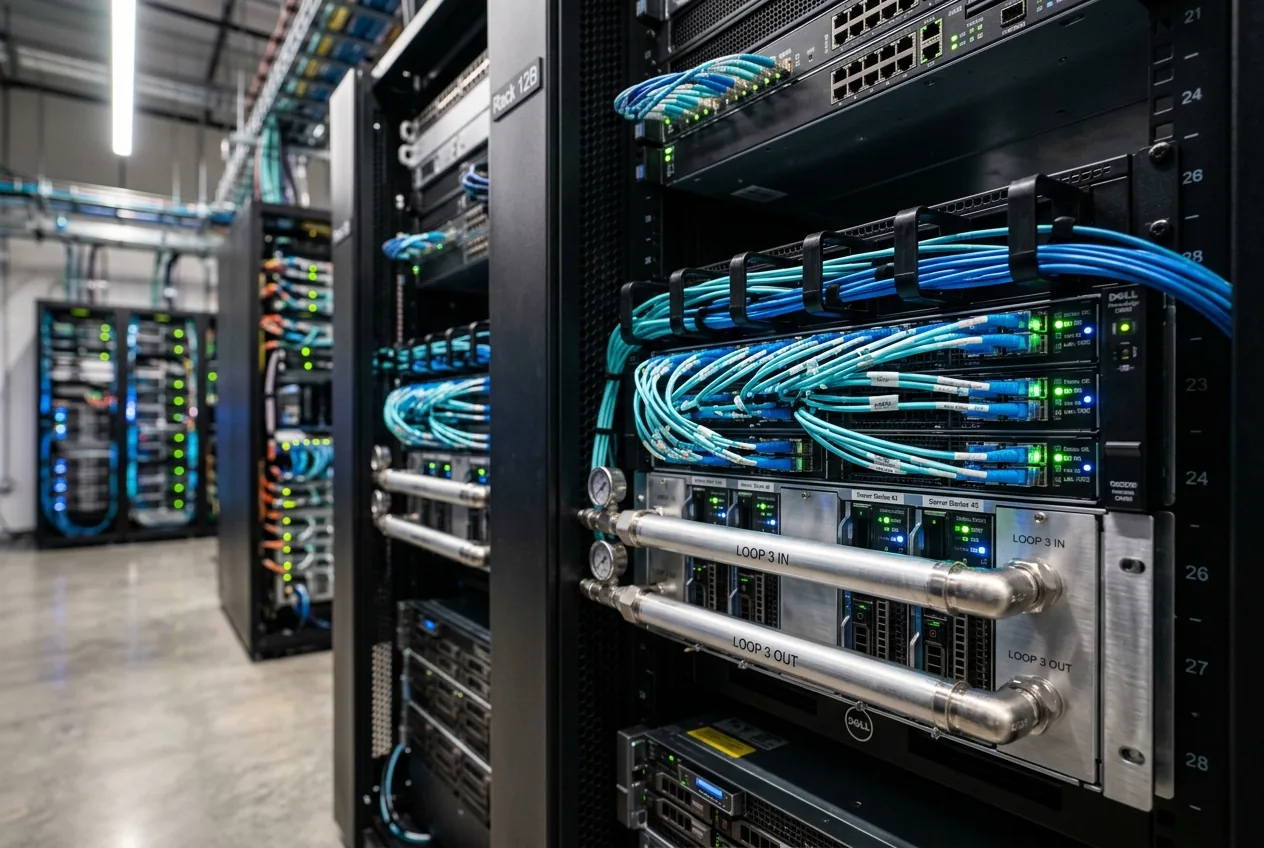
Luna representa el cambio táctico más crítico para los sistemas embebidos y físicos. Despojado de carga de parámetros extraña y optimizado para una cuantización extrema (probablemente hasta perfiles de ejecución de 4 y 8 bits), Luna está construido para tareas de baja latencia y alta frecuencia. Con envolventes de respuesta dirigidas directamente al umbral inferior a los 50 milisegundos, este modelo está diseñado para operar en aceleradores de hardware locales, servidores de planta de fábrica montados en bastidores y dispositivos de borde (edge) reforzados. Luna no está construido para escribir tratados filosóficos; está calibrado para la clasificación instantánea, la detección de anomalías de sensores en tiempo real, la mediación de interfaces de voz y los comandos de supervisión de robots de bucle cerrado.
La realidad del ancho de banda de memoria y la economía de la inferencia
Para entender por qué OpenAI dividió GPT-5.6 en tres motores distintos, hay que mirar más allá de los benchmarks de software y examinar las realidades del silicio. El factor limitante en la IA de frontera moderna no es el cómputo en abstracto; es el ancho de banda de memoria. Los clústeres de aceleradores modernos —ya sea impulsados por las plataformas H100, H200 de Nvidia o las más recientes Blackwell B200— están fundamentalmente limitados por el rendimiento de la memoria de alto ancho de banda (HBM) al generar tokens secuencialmente.
Cuando una celda robótica o un sistema de gestión de almacenes automatizado envía un flujo continuo de telemetría a un modelo monolítico, el hardware debe leer billones de parámetros de la memoria por cada token generado. Hacer esto en una red de clase Sol para una simple verificación de estado es económicamente insostenible. Sobrecarga las redes eléctricas, consume la capacidad de enfriamiento e infla los costos de la API a niveles que colapsan los cálculos de retorno de inversión industrial.
¿La orquestación multinivel romperá los frágiles conductos industriales?
Si bien la lógica arquitectónica de la familia GPT-5.6 es sólida, traducir un ecosistema de modelos escalonados en código de producción confiable introduce graves desafíos de integración. En ingeniería de software, la gestión de estados en sistemas distintos es notoriamente frágil. Distribuir el razonamiento entre Luna, Terra y Sol requiere una capa de orquestación capaz de enrutar consultas dinámicamente sin introducir su propio punto de falla computacional.
Si una planta de fábrica depende de Luna para el análisis sensorial inmediato, los desarrolladores deben definir protocolos de traspaso deterministas. ¿En qué punto un umbral de falla incita a Luna a escalar una tarea a Terra? Si Terra encuentra un estado ambiguo y se remite a Sol, ¿cómo gestiona el sistema la discrepancia de latencia sin bloquear el hardware mecánico a la espera de una respuesta? En los sistemas físicos, una sincronización inconsistente —conocida como jitter— puede ser catastrófica. Si una línea de ensamblaje automatizada experimenta retrasos impredecibles en la generación de tokens mientras cambia entre modelos, la línea física debe reducir la velocidad o arriesgarse a una colisión mecánica.
Además, la paridad de prompt y contexto entre los niveles sigue siendo un desafío no resuelto. Un prompt optimizado para la comprensión matizada y de altos parámetros de Sol puede fallar silenciosamente o producir alucinaciones cuando se trunca y procesa mediante la arquitectura destilada de Luna. Los equipos de ingeniería necesitarán validar conjuntos de prompts, esquemas y protecciones distintos para cada nivel de modelo individual, complicando los conductos de integración y despliegue continuos.
La maduración: de fenómeno de investigación a estándar industrial
Para los líderes tecnológicos, el surgimiento de esta arquitectura escalonada exige una reevaluación de las hojas de ruta de IA actuales. Los sistemas ganadores no serán aquellos que simplemente se suscriban a los puntos finales de API más grandes y costosos disponibles. En cambio, la ventaja competitiva pertenecerá a los ingenieros que dominen la orquestación de modelos: enrutar los tokens correctos a través del silicio adecuado en el momento preciso en que se necesitan, equilibrando el costo, la velocidad y la inteligencia con precisión mecánica.



Comments
No comments yet. Be the first!