En ingénierie mécanique, la force brute est rarement une prouesse d'ingénierie ; c'est généralement l'aveu d'une conception inefficace. Lors de la conception d'une transmission ou d'un système de portique automatisé, fixer un moteur surdimensionné là où un servomoteur précis et léger suffirait introduit une masse parasite, une limitation thermique et des dépenses d'investissement inutiles. Au cours des quatre dernières années, l'intelligence artificielle de pointe a largement fonctionné selon la philosophie inverse : consacrer un maximum de puissance de calcul à un espace de paramètres singulier et monolithique, récolter des capacités émergentes et forcer chaque problème opérationnel à passer par le même pipeline coûteux en calcul.
Les débuts de la génération GPT-5.6 — divisée systématiquement en niveaux Sol, Terra et Luna — signalent que cette époque de la force brute atteint ses limites économiques et architecturales. OpenAI ne présente plus l'intelligence de pointe comme un marteau universel. Au lieu de cela, l'entreprise traite l'inférence comme un assemblage mécanique multicouche, offrant trois profils distincts de calcul et de latence conçus pour tout gérer, de la synthèse théorique approfondie aux boucles de contrôle déterministes en temps réel.
Pour les développeurs d'entreprise et les ingénieurs en systèmes matériels, cette transition marque le moment où les modèles génératifs cessent de se comporter comme des artefacts de recherche spéculatifs pour commencer à s'intégrer aux contraintes rigoureuses de l'infrastructure physique, de l'automatisation industrielle et de la télémétrie de la périphérie vers le cloud.
Déconstruction de la triade : Sol, Terra et Luna
La version GPT-5.6 divise les capacités selon des vecteurs explicites : densité des paramètres, latence d'inférence, surcharge de la bande passante mémoire et consommation de jetons par watt. Plutôt que de forcer les entreprises à accepter des compromis via un sous-échantillonnage au niveau du prompt ou une quantification dynamique agressive sur un seul modèle phare, OpenAI a stratifié les poids sous-jacents et les topologies d'exécution.
Sol occupe le sommet computationnel. Il est conçu pour la planification à long terme, la vérification formelle en plusieurs étapes et le raisonnement symbolique intensif. En termes pratiques, Sol fonctionne comme un moteur analytique asynchrone. Opérant avec des tampons de raisonnement étendus et un routage avancé de type mélange d'experts (MoE), il échange un débit immédiat contre une fidélité algorithmique. Lors de tests impliquant une cinématique mécanique complexe, une analyse récursive des modes de défaillance et une compilation de code complexe sur des systèmes distribués, Sol représente le summum des capacités de raisonnement synthétique d'OpenAI. Cependant, son empreinte computationnelle élevée et son profil de latence le confinent intrinsèquement au niveau du cloud, ce qui en fait un moteur de stratégie plutôt que d'exécution immédiate.
Terra sert de base opérationnelle — la réponse directe aux demandes des entreprises pour un cheval de bataille fiable et à haut débit. Équilibrant l'échelle des paramètres et la vitesse d'exécution, Terra optimise l'économie des jetons pour les flux de travail structurés : ingestion de données en direct, automatisation ERP d'entreprise, surveillance télémétrique synthétique et synthèse de documents intermédiaire. Il conserve suffisamment de fidélité contextuelle pour saisir des ontologies spécifiques à un domaine sans encourir les délais de plusieurs secondes avant le premier jeton, caractéristiques des réseaux de raisonnement phares. Pour les chaînes d'approvisionnement manufacturières suivant l'acheminement des matières premières ou les centres logistiques gérant la répartition dynamique, Terra offre le juste milieu pragmatique entre profondeur cognitive et vitesse opérationnelle.
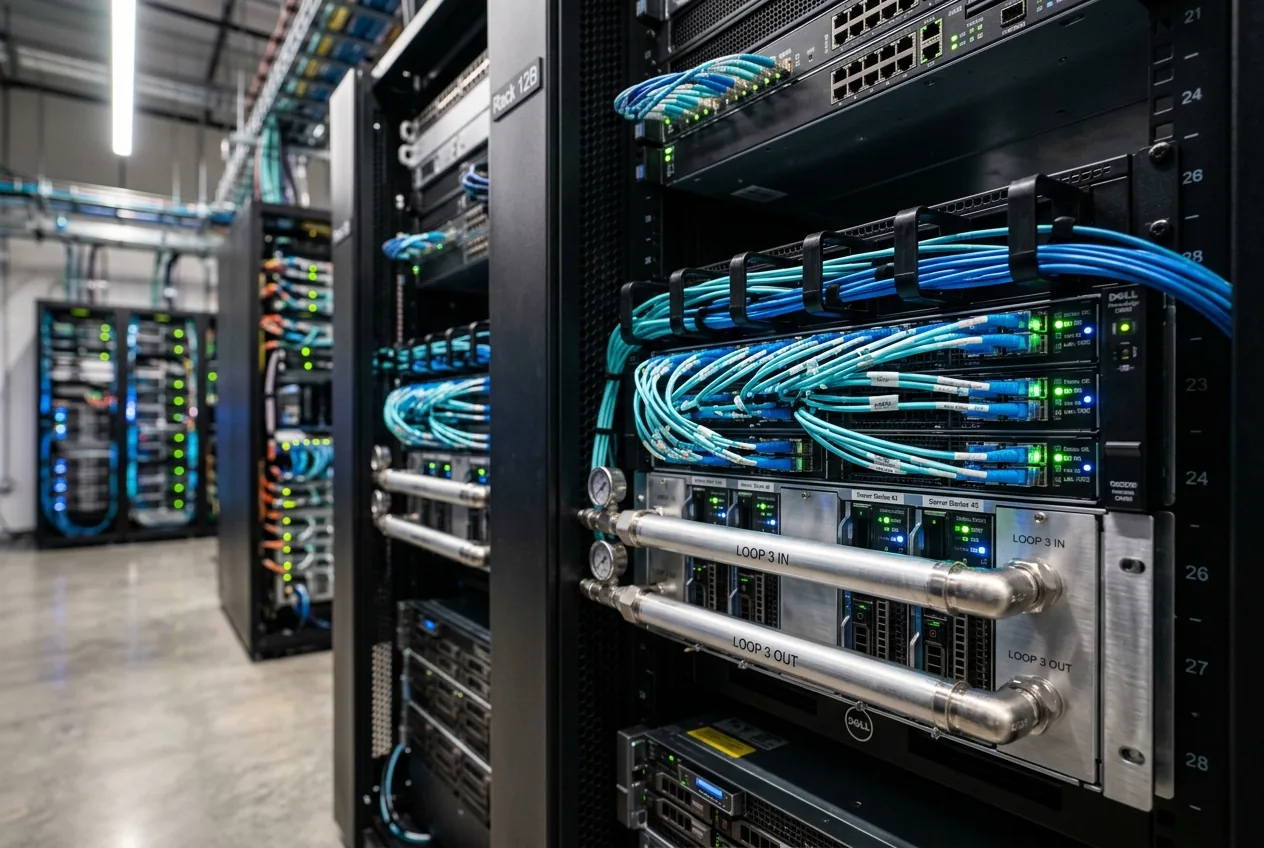
Luna représente le changement tactique le plus critique pour les systèmes embarqués et physiques. Dépouillé des paramètres inutiles et optimisé pour une quantification extrême — probablement jusqu'à des profils d'exécution 4 bits et 8 bits —, Luna est conçu pour des tâches à faible latence et à haute fréquence. Avec des enveloppes de réponse visant directement le seuil des 50 millisecondes, ce modèle est conçu pour fonctionner sur des accélérateurs matériels locaux, des serveurs montés en rack dans les usines et des équipements de périphérie renforcés. Luna n'est pas conçu pour rédiger des traités philosophiques ; il est calibré pour la classification instantanée, la détection d'anomalies par capteurs en temps réel, la médiation par interface vocale et les commandes de supervision de robots en boucle fermée.
La réalité de la bande passante mémoire et de l'économie de l'inférence
Pour comprendre pourquoi OpenAI a divisé GPT-5.6 en trois moteurs distincts, il faut regarder au-delà des benchmarks logiciels et examiner les réalités du silicium. Le facteur limitant de l'IA de pointe moderne n'est pas le calcul dans l'abstrait, c'est la bande passante mémoire. Les clusters d'accélérateurs modernes — qu'ils soient pilotés par les plateformes H100, H200 de Nvidia ou les nouvelles Blackwell B200 — sont fondamentalement contraints par le débit de la mémoire à haute bande passante (HBM) lors de la génération séquentielle de jetons.
Lorsqu'une cellule robotisée ou un système de gestion d'entrepôt automatisé envoie un flux continu de télémétrie à un modèle monolithique, le matériel doit lire des billions de paramètres depuis la mémoire pour chaque jeton généré. Faire cela sur un réseau de type Sol pour une simple vérification d'état est économiquement insoutenable. Cela sollicite les réseaux électriques, épuise la capacité de refroidissement et gonfle les coûts d'API à des niveaux qui font s'effondrer les calculs de retour sur investissement industriel.
L'orchestration multi-niveaux brisera-t-elle les fragiles pipelines industriels ?
Bien que la logique architecturale de la famille GPT-5.6 soit solide, la traduction d'un écosystème de modèles hiérarchisé en code de production fiable introduit des défis d'intégration sévères. En génie logiciel, la gestion de l'état entre différents systèmes est notoirement fragile. Distribuer le raisonnement entre Luna, Terra et Sol nécessite une couche d'orchestration capable d'acheminer les requêtes dynamiquement sans introduire son propre point de défaillance computationnelle.
Si un atelier d'usine repose sur Luna pour une analyse sensorielle immédiate, les développeurs doivent définir des protocoles de transfert déterministes. À quel moment un seuil de défaillance pousse-t-il Luna à escalader une tâche vers Terra ? Si Terra rencontre un état ambigu et s'en remet à Sol, comment le système gère-t-il la divergence de latence sans bloquer le matériel mécanique en attente d'une réponse ? Dans les systèmes physiques, une synchronisation incohérente — connue sous le nom de gigue — peut être catastrophique. Si une chaîne de montage automatisée subit des délais de génération de jetons imprévisibles lors du basculement entre les modèles, la ligne physique doit soit ralentir, soit risquer une collision mécanique.
De plus, la parité entre les invites et le contexte entre les niveaux reste un défi non résolu. Une invite optimisée pour la compréhension nuancée et riche en paramètres de Sol peut échouer silencieusement ou produire des hallucinations lorsqu'elle est tronquée et traitée par l'architecture distillée de Luna. Les équipes d'ingénierie devront valider des ensembles d'invites, des schémas et des garde-fous distincts pour chaque niveau de modèle individuel, compliquant ainsi les pipelines d'intégration et de déploiement continus.
La maturation, d'un phénomène de recherche à un standard industriel
Pour les leaders technologiques, l'émergence de cette architecture hiérarchisée exige une réévaluation des feuilles de route actuelles en matière d'IA. Les systèmes gagnants ne seront pas ceux qui s'abonnent simplement aux points de terminaison d'API les plus grands et les plus coûteux disponibles. Au contraire, l'avantage concurrentiel appartiendra aux ingénieurs qui maîtriseront l'orchestration des modèles — acheminant les bons jetons à travers le bon silicium au moment précis où ils sont nécessaires, équilibrant coût, vitesse et intelligence avec une précision mécanique.



Comments
No comments yet. Be the first!