Der monolithische Ansatz bei der Spitzen-KI nähert sich seinem endgültigen Ende. Berichte, wonach OpenAI beabsichtigt, seine nächste große Iteration, GPT-5.6, unter einem dreigliedrigen Rahmenwerk namens Sol, Terra und Luna zu veröffentlichen, unterstreichen eine längst überfällige Wende in der Branche. Anstatt ein einzelnes, schwerfälliges Modell zu liefern, das alles von Algebra der Oberstufe bis hin zu komplexer Systemtechnik bewältigen muss, wird die Architektur direkt auf der Bereitstellungsebene segmentiert. Das anvisierte Datum vom 9. Juli signalisiert, dass der Wettlauf um rohe Parameterskalierung offiziell den Realitäten der Inferenzökonomie, den thermischen Schwellenwerten von Server-Racks und den betrieblichen Anforderungen industrieller Hardware gewichen ist.
Für Unternehmensentwickler und Hardware-Ingenieure ist der Wechsel zu einem gestuften Paradigma – das astronomische Maßstäbe widerspiegelt: Sol als Flaggschiff, Terra als terrestrisches Arbeitstier und Luna als kompakter, hocheffizienter Satellit – nicht bloß ein Marketing-Rebranding. Es stellt einen technischen Kompromiss dar, der durch die physikalischen Grenzen der aktuellen Rechenzentrumsinfrastruktur erzwungen wurde. Da das Token-Volumen weltweit weiter zunimmt, ist der Betrieb von Mixture-of-Experts-Modellen mit Billionen von Parametern für wenig komplexe, deterministische Aufgaben ökonomisch nicht mehr vertretbar. GPT-5.6 scheint darauf ausgelegt zu sein, starre operative Grenzen für die Zuweisung von Rechenkapazitäten zu schaffen und spezifische FLOP-Budgets an den tatsächlichen kognitiven Anforderungen verschiedener Arbeitslasten auszurichten.
Analyse der Triade: Apex-Reasoning, Enterprise-Skalierung und Edge-Nutzen
Während OpenAI bezüglich der internen Nomenklatur striktes offizielles Schweigen bewahrt, offenbaren Leaks zur Konfiguration von Sol, Terra und Luna unterschiedliche Hardware-Ziele. Sol bildet die Spitze des Clusters und ist explizit für mehrstufiges Schlussfolgern, dichte wissenschaftliche Simulationen und offene generative Programmierung ausgelegt. Es wird erwartet, dass dieses Modell Mechanismen für tiefgreifende Test-Time-Compute-Berechnungen integriert und seine Chain-of-Thought-Verarbeitung dynamisch an den Schwierigkeitsgrad des Problems anpasst. Für computergestützte Strömungsmechanik, strukturelle Belastungsmodellierungen und hochsensible Finanztelemetrie bietet Sol das tiefe Reservoir an Parametern, das notwendig ist, um die Halluzinationsraten unter kritische Unternehmensschwellenwerte zu drücken.
Terra besetzt die Mitte und fungiert als geplanter Ersatz für aktuelle High-Throughput-API-Endpunkte. Basierend auf einem aggressiv optimierten Mixture-of-Experts (MoE)-Backbone gleicht Terra Latenz mit semantischer Genauigkeit aus und zielt direkt auf Unternehmenssoftware-Pipelines, groß angelegtes Dokumenten-Parsing und Echtzeit-Kundenintegrationen ab. Indem Terra bei jedem Forward-Pass nur einen kleinen Bruchteil seiner gesamten Parameterbasis aktiviert, minimiert es die Speicherkonflikte auf hochdichten Beschleunigerknoten, was es Cloud-Anbietern ermöglicht, die gleichzeitigen Benutzeranfragen pro Megawatt Stromverbrauch zu maximieren.
Die aus Sicht der industriellen Automatisierung überzeugendste Stufe ist Luna. Auf extreme Geschwindigkeit und geringen Speicherbedarf ausgelegt, gilt Luna allgemein als stark destilliertes Modell, das für die Edge-Bereitstellung oder die lokale Ausführung mit nahezu null Latenz geeignet ist. In modernen Fertigungslinien und automatisierten Logistikzentren ist es inakzeptabel, Hunderte von Millisekunden auf einen externen Cloud-Server zu warten, um ein Inferenz-Token zu erhalten. Luna scheint so konzipiert zu sein, dass es problemlos innerhalb der Speicherumgebungen von Workstation-Klasse-Hardware und eingebetteten Edge-Beschleunigern operieren kann und unmittelbares kontextuelles Verständnis an der physischen Schnittstelle zwischen Software und Industriemaschinen bietet.
Die thermischen Realitäten und die Ökonomie der Rechenzentrumsleistung
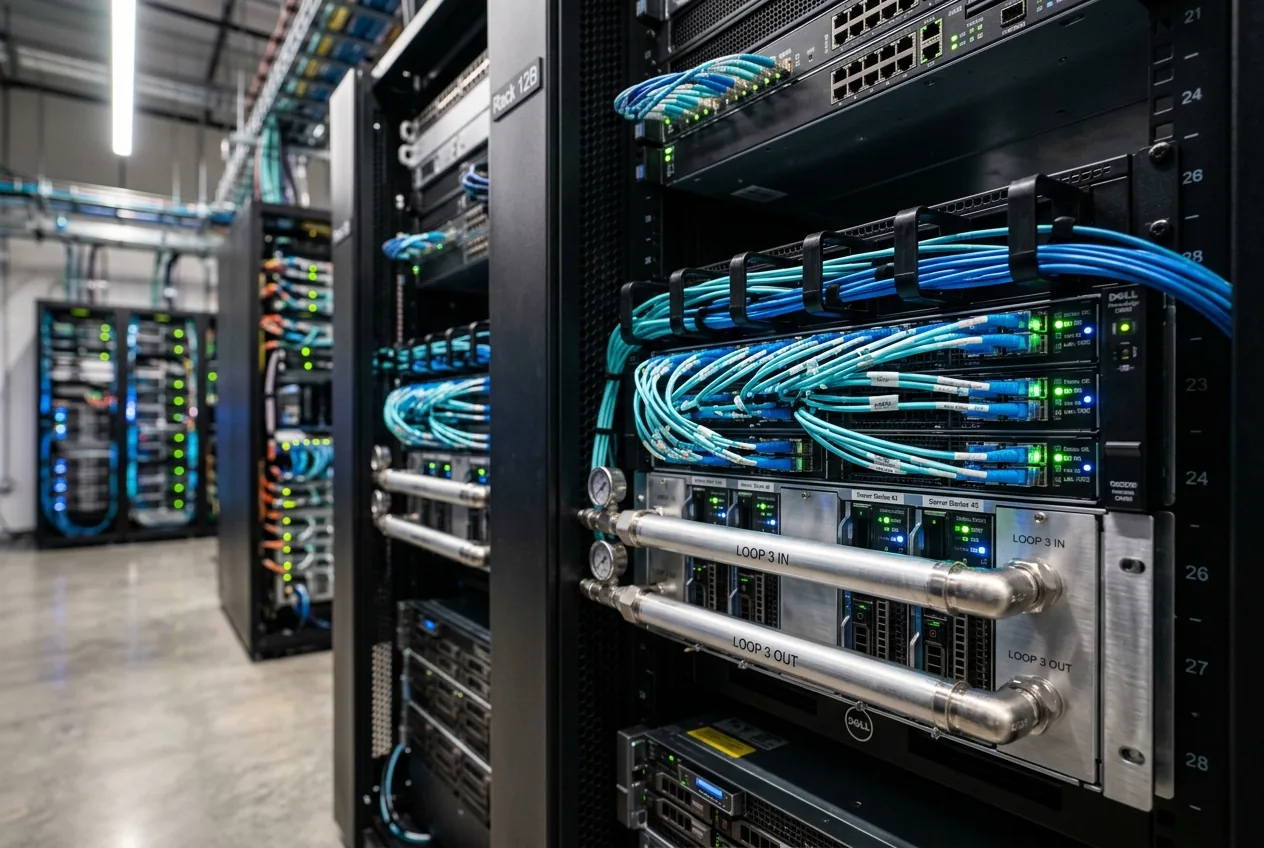
Um zu verstehen, warum OpenAI diese gestufte Einführung verfolgt, muss man die mechanischen Einschränkungen moderner Rechenzentren betrachten. Frontier-Trainingscluster und Inferenz-Serverfarmen stoßen direkt an ihre Kühlungsgrenzen und die Kapazitätsgrenzen lokaler Stromnetze. Die Ära, in der Parameterzahlen blindlings ohne Rücksicht auf den Energieverbrauch skaliert wurden, ist mit den elektrischen Grenzen der kommunalen Infrastruktur und den Fertigungsengpässen bei fortschrittlichen Flüssig-zu-Luft-Wärmetauschern kollidiert. Hyperscaler können es nicht länger rechtfertigen, rohe elektrische Leistung in ein einzelnes, schwergewichtiges Spitzenmodell zu investieren, wenn achtzig Prozent der Unternehmensanfragen nur moderate syntaktische Manipulation erfordern.
Inferenzkosten, nicht Trainingskosten, dominieren heute die Bilanzen fortschrittlicher KI-Operationen. Jede Millisekunde, die eine Grafikprozessoreinheit damit verbringt, Key-Value (KV)-Caches für eine inaktive oder langsam generierende Verbindung im High-Bandwidth-Memory (HBM) zu halten, stellt entgangene Einnahmen dar. Durch die Entkoppelung der Arbeitslasten in Sol, Terra und Luna kann OpenAI eine hyper-aggressive KV-Cache-Quantisierung und spekulative Dekodierung über die gesamte Flotte hinweg implementieren. In diesem Setup kann die leichtgewichtige Luna-Stufe als spekulative Entwurfs-Engine fungieren, die Token-Sequenzen vorhersagt, welche dann parallel von den leistungsfähigeren Terra- oder Sol-Stufen validiert werden, was sowohl die Ende-zu-Ende-Latenz als auch die Energiekosten pro abgeschlossener Antwort drastisch senkt.
Darüber hinaus erzwingen Unternehmensbilanzen ein Maß an rechnerischer Disziplin, das während des frühen Investitionszyklus für generative KI nicht existierte. Chief Information Officers sind nicht mehr bereit, ergebnisoffene Inferenz-Rechnungen für interne Tools zu subventionieren. Gestufte Modellfamilien ermöglichen es Unternehmen, deterministische Routing-Pipelines zu konstruieren: billige Triage-Aufgaben über Luna, komplexe Logik über Terra und die Reservierung von Sol ausschließlich für hochwertige strategische Synthesen oder autonome technische Verifizierungen, wodurch die Computerausgaben direkt an den Geschäftswert gekoppelt bleiben.
Implikationen für eingebettete Systeme und industrielle Robotik
In den Bereichen Robotik, Lieferkettenoptimierung und automatisierte Qualitätssicherung ist das Latenzprofil eines KI-Modells ebenso wichtig wie seine Benchmark-Genauigkeit. Ein Roboterarm, der in einer Hochgeschwindigkeits-Sortieranlage oder einer kollaborativen Montagezelle arbeitet, kann nicht für Cloud-basierte Paket-Roundtrips pausieren, wenn er seine kinematischen Flugbahnen an ein unerwartetes Hindernis anpasst. Vision-Language-Action (VLA)-Pipelines erfordern eine sofortige sensorische Integration, die in strengen, deterministischen Echtzeitschleifen im einstelligen Millisekundenbereich arbeitet.
Wenn die Luna-Stufe die Parametereffizienz liefert, die frühe technische Leaks nahelegen, könnte sie als grundlegende semantische Schicht für die nächste Generation fahrerloser Transportfahrzeuge (FTS) und autonomer mobiler Roboter (AMR) dienen. Durch den Betrieb auf lokalisierten Compute-Stacks – wie etwa industriellen Onboard-Modulen, die weniger als einhundert Watt verbrauchen – könnte Luna räumliche Szenenbeschreibungen interpretieren, hochsprachliche Anweisungen in räumliche Koordinaten-Wegpunkte übersetzen und Anomalien im Systemzustand direkt in der Fertigungshalle überwachen, ohne dass eine aktive Weitverkehrsnetzverbindung erforderlich ist.
Diese Fähigkeit verändert grundlegend die Wartungs- und Bereitstellungsprofile industrieller Automatisierungssysteme. Anstatt sich auf starre, vorprogrammierte Ablauffolgen oder teure, fragile klassische Computer-Vision-Routinen zu verlassen, können Ingenieure adaptive Systeme einsetzen, die physische Abweichungen an Montagelinien bewältigen können. Die Integration von Luna an der physischen Edge, unterstützt durch asynchrone, stapelverarbeitete Aufsicht durch Cloud-basierte Terra- oder Sol-Instanzen für die flottenweite Telemetrieanalyse, entwirft den Bauplan für eine wahrhaft skalierbare cyber-physische Architektur.
Der strategische Schwenk zu Test-Time Compute statt bloßer Skalierung
Das Bereitstellungsdatum vom 9. Juli erwischt OpenAI, falls es realisiert wird, in einem kritischen Moment des architektonischen Wandels. Die grundlegenden Skalierungsgesetze, die im letzten halben Jahrzehnt aufgestellt wurden – die besagten, dass die bloße Hinzufügung von mehr Token und Parametern zu kontinuierlichen, vorhersehbaren Sprüngen an Intelligenz führen würde – sind auf das unvermeidliche Plateau abnehmender Erträge gestoßen. Hochwertige, von Menschen generierte Trainingsdaten sind weitgehend erschöpft, was Modellarchitekten dazu zwingt, sich auf komplexe synthetische Daten-Pipelines, Reinforcement-Learning-Umgebungen und Sucharchitekturen zur Inferenzzeit zu verlassen.
Sol stellt die physische Manifestation dieser neuen philosophischen Ausrichtung dar. Anstatt Milliarden an Investitionsausgaben zu verbrennen, nur um das vortrainierte Parameterfundament zu verbreitern, hat sich der Schwerpunkt auf Laufzeit-Suchalgorithmen verlagert. Indem dem Modell der Rechenraum gegeben wird, um mehrere Argumentationspfade zu testen, kontrafaktische Hypothesen zu bewerten und sich selbst zu korrigieren, bevor eine endgültige Antwort ausgegeben wird, kann Sol Durchbrüche bei der technischen Problemlösung erzielen, ohne einen Parameterbedarf zu benötigen, der die elektrischen Umspannwerke seiner Host-Rechenzentren zum Schmelzen bringt.
Diese architektonische Verschiebung ebnet das Spielfeld und erhöht gleichzeitig die Eintrittsbarriere für die Unternehmensintegration. Die Entwicklung von Systemen, die Rechenkapazitäten zur Test-Zeit intelligent basierend auf der Schwierigkeit einer eingehenden Aufgabe zuweisen können, ist außerordentlich komplex. Wenn es GPT-5.6 gelingt, diese dynamische Zuweisung über Sol, Terra und Luna hinweg zu standardisieren, wird dies konkurrierende Frontier-Labore dazu zwingen, ihre simplen, uniformen API-Paradigmen aufzugeben und ähnliche Multi-Tier-Laufzeitumgebungen einzuführen, um kommerziell wettbewerbsfähig zu bleiben.
Das Unternehmenskalkül vor dem Juli-Horizont
Während das geplante Veröffentlichungsdatum näher rückt, müssen Führungskräfte der Unternehmen ihre Infrastrukturen auf einen stärker segmentierten Integrationsprozess vorbereiten. Die Zeiten, in denen man eine Anwendung einfach auf einen einzigen Modellendpunkt ausrichtete und sich nicht weiter darum kümmerte, sind vorbei. Die Implementierung von GPT-5.6 wird eine gründliche Überprüfung interner Datenpipelines erfordern, um genau zu bestimmen, wo das logische Schlussfolgern von Sol mit hoher Latenz und hohen Kosten tatsächlich gerechtfertigt ist und wo die optimierten Effizienzen von Terra und Luna die operativen Margen steigern können.
Für Systemingenieure und technische Architekten ist die Ankunft von Sol, Terra und Luna ein pragmatisches Eingeständnis der Realität. Intelligenz in Software kann nicht unabhängig von Silizium, Kupfer und der Kühlflüssigkeit existieren, die sie aufrechterhält. Durch die Aufteilung seiner Spitzenkapazitäten in gezielte operative Klassen scheint OpenAI bereit zu sein, eine Architektur zu liefern, die nicht nur auf theoretischen kognitiven Benchmarks basiert, sondern auf den praktischen, kalten Realitäten der industriellen Rechenleistung.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!