L'approccio monolitico all'intelligenza artificiale di frontiera sta giungendo a una conclusione definitiva. Le notizie secondo cui OpenAI intende lanciare la sua prossima importante iterazione, denominata GPT-5.6, nell'ambito di una struttura tripartita chiamata Sol, Terra e Luna, evidenziano una svolta del settore attesa da tempo. Piuttosto che fornire un unico modello ingombrante incaricato di gestire tutto, dall'algebra del liceo alla complessa ingegneria dei sistemi, l'architettura viene segmentata direttamente al livello di distribuzione. L'obiettivo fissato per il 9 luglio segnala che la corsa alla pura scala dei parametri ha formalmente ceduto il passo alle realtà dell'economia dell'inferenza, alle soglie termiche dei rack dei server e alle esigenze operative dell'hardware industriale.
Per gli sviluppatori aziendali e gli ingegneri hardware, il passaggio a un paradigma a livelli—che rispecchia la scala astronomica con Sol come fiore all'occhiello, Terra come cavallo di battaglia terrestre e Luna come satellite compatto ad alta efficienza—non è solo un rebranding di marketing. Rappresenta un compromesso ingegneristico imposto dai limiti fisici dell'attuale infrastruttura dei data center. Con l'aumento del volume di token a livello globale, eseguire modelli "mixture of experts" da mille miliardi di parametri per attività deterministiche a bassa complessità è diventato economicamente insostenibile. GPT-5.6 sembra progettato per stabilire rigidi confini operativi attorno alle allocazioni di calcolo, allineando specifici budget FLOP ai requisiti cognitivi effettivi dei diversi carichi di lavoro.
Dissezionare la triade: Ragionamento di vertice, scala aziendale e utilità edge
Sebbene OpenAI abbia mantenuto uno stretto riserbo ufficiale riguardo alla nomenclatura interna, le indiscrezioni sulla configurazione di Sol, Terra e Luna rivelano target hardware distinti. Sol si colloca all'apice del cluster, progettato esplicitamente per il ragionamento multi-step, la simulazione scientifica densa e la programmazione generativa a scopo aperto. Si prevede che questo modello integri profondi meccanismi di calcolo in fase di test, scalando dinamicamente il suo processo di "catena di pensiero" (chain-of-thought) in base alla difficoltà del problema. Per la fluidodinamica computazionale, la modellazione dello stress strutturale e la telemetria finanziaria ad alto rischio, Sol fornisce il profondo serbatoio di parametri necessario per ridurre i tassi di allucinazione al di sotto delle soglie aziendali critiche.
Terra occupa la posizione intermedia, fungendo da sostituto previsto per gli attuali endpoint API ad alto throughput. Costruito su una dorsale "mixture-of-experts" (MoE) ottimizzata in modo aggressivo, Terra bilancia la latenza con la fedeltà semantica, puntando direttamente alle pipeline software aziendali, all'analisi di documenti su larga scala e alle integrazioni con i clienti in tempo reale. Attivando solo una frazione ridotta della sua base totale di parametri per passaggio in avanti, Terra riduce al minimo la contesa del bus di memoria sui nodi acceleratori ad alta densità, consentendo ai provider cloud di massimizzare le query degli utenti simultanee per megawatt di potenza assorbita.
Il livello più interessante dal punto di vista dell'automazione industriale è Luna. Dimensionato per una velocità estrema e un ingombro di memoria ridotto, Luna è ampiamente considerato un modello fortemente distillato in grado di essere distribuito su edge o per l'esecuzione locale a latenza quasi zero. Nelle moderne linee di produzione e negli hub logistici automatizzati, attendere centinaia di millisecondi affinché un server cloud esterno restituisca un token di inferenza è inaccettabile. Luna sembra progettato per operare comodamente all'interno degli inviluppi di memoria dell'hardware aziendale di classe workstation e degli acceleratori edge integrati, fornendo una comprensione contestuale immediata al confine fisico in cui il software incontra i macchinari industriali.
Le realtà termiche e l'economia del calcolo nei data center
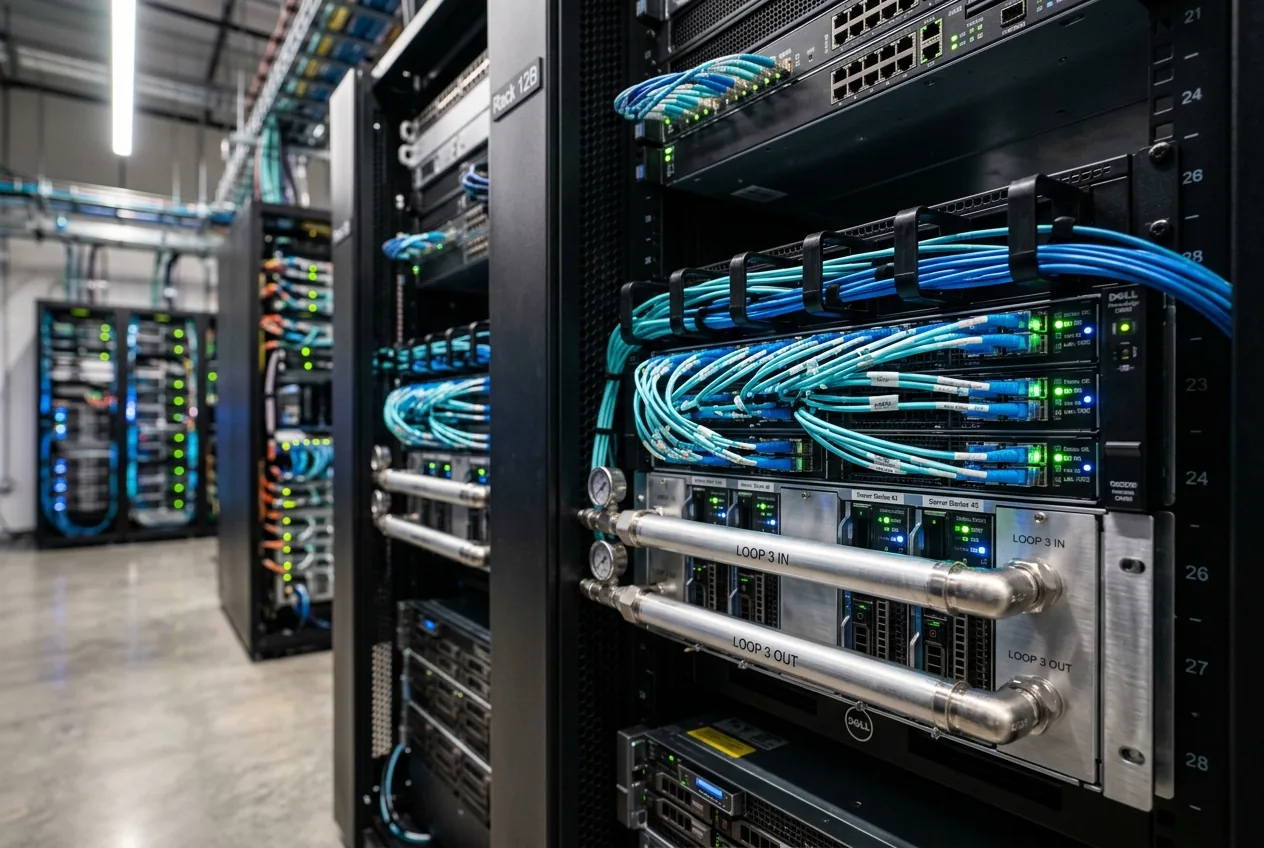
Per capire perché OpenAI stia perseguendo questo rilascio stratificato, bisogna guardare ai vincoli meccanici all'interno dei moderni data center. I cluster di addestramento di frontiera e le server farm di inferenza si stanno scontrando direttamente con i limiti di raffreddamento e i vincoli della rete elettrica locale. L'era del ridimensionamento cieco del numero di parametri senza riguardo per il consumo energetico si è scontrata con i limiti elettrici delle infrastrutture municipali e i colli di bottiglia produttivi degli avanzati scambiatori di calore liquido-aria. Gli hyperscaler non possono più giustificare l'impiego di energia elettrica grezza in un unico modello di frontiera pesante quando l'ottanta percento delle query aziendali richiede solo una moderata manipolazione sintattica.
I costi di inferenza, piuttosto che quelli di addestramento, dominano ora i bilanci delle operazioni di IA avanzata. Ogni millisecondo che un'unità di elaborazione grafica (GPU) trascorre a mantenere le cache chiave-valore (KV) nella memoria a larghezza di banda elevata (HBM) per una connessione inattiva o a generazione lenta rappresenta un mancato guadagno. Decoppiando i carichi di lavoro in Sol, Terra e Luna, OpenAI può implementare una quantizzazione iper-aggressiva della cache KV e una decodifica speculativa in tutta la flotta. In questa configurazione, il livello ultraleggero Luna può fungere da motore di bozza speculativa, prevedendo sequenze di token che vengono poi convalidate in parallelo dai livelli più capaci Terra o Sol, riducendo sia la latenza end-to-end che il costo energetico per risposta completata.
Inoltre, i bilanci aziendali stanno imponendo un livello di disciplina computazionale che non esisteva durante il primo ciclo di investimenti nell'IA generativa. I chief information officer non sono più disposti a finanziare fatturazioni di inferenza a tempo indeterminato per strumenti interni. Le famiglie di modelli stratificati consentono alle organizzazioni di costruire pipeline di routing deterministiche: indirizzando le attività di triage meno costose attraverso Luna, la logica complessa attraverso Terra e riservando Sol rigorosamente per la sintesi strategica ad alto valore o per la verifica ingegneristica autonoma, mantenendo così le spese di calcolo legate direttamente al valore aziendale.
Implicazioni per i sistemi integrati e la robotica industriale
Nei campi della robotica, dell'ottimizzazione della supply chain e del controllo qualità automatizzato, il profilo di latenza di un modello di IA è critico quanto la sua precisione di benchmark. Un braccio robotico che opera all'interno di un impianto di smistamento ad alta velocità o di una cella di assemblaggio collaborativo non può fermarsi per i viaggi di andata e ritorno dei pacchetti basati su cloud quando deve regolare le proprie traiettorie cinematiche in presenza di un ostacolo imprevisto. Le pipeline di visione-linguaggio-azione (VLA) richiedono un'integrazione sensoriale istantanea, operando su rigorosi cicli deterministici in tempo reale misurati in pochi millisecondi.
Se il livello Luna fornisce l'efficienza dei parametri suggerita dalle prime indiscrezioni tecniche, potrebbe fungere da livello semantico fondamentale per la prossima generazione di veicoli a guida automatica (AGV) e robot mobili autonomi (AMR). Eseguendo su stack di calcolo localizzati—come i moduli industriali di bordo che assorbono meno di cento watt—Luna potrebbe interpretare le descrizioni spaziali della scena, tradurre direttive in linguaggio naturale di alto livello in waypoint di coordinate spaziali e monitorare le anomalie dello stato del sistema direttamente in fabbrica senza una connessione attiva a una rete geografica (WAN).
Questa capacità cambia radicalmente i profili di manutenzione e distribuzione dei sistemi di automazione industriale. Piuttosto che fare affidamento su una logica ladder rigida e pre-programmata o su costose e fragili routine di visione artificiale classica, gli ingegneri possono implementare sistemi adattivi in grado di gestire le varianti fisiche sulle linee di assemblaggio. L'integrazione di Luna al limite fisico, supportata da una supervisione asincrona e batch elaborata da istanze Terra o Sol basate su cloud per l'analisi della telemetria dell'intera flotta, delinea il progetto per un'architettura cyber-fisica veramente scalabile.
La svolta strategica verso il calcolo in fase di test rispetto alla scala bruta
La data di distribuzione del 9 luglio, se realizzata, coglie anche OpenAI in un momento critico di transizione architettonica. Le leggi di scala fondamentali stabilite negli ultimi cinque anni—che stabilivano che il semplice aggiungere più token e più parametri avrebbe prodotto salti continui e prevedibili nell'intelligenza—hanno incontrato l'inevitabile plateau dei rendimenti decrescenti. Il testo di addestramento di alta qualità generato dall'uomo è stato in gran parte esaurito, costringendo gli architetti dei modelli a fare affidamento su complesse pipeline di dati sintetici, ambienti di apprendimento per rinforzo e architetture di ricerca in fase di inferenza.
Sol rappresenta la manifestazione fisica di questa nuova direzione filosofica. Invece di bruciare miliardi di dollari in spese in conto capitale semplicemente per ampliare la base dei parametri pre-addestrati, l'enfasi si è spostata verso gli algoritmi di ricerca in fase di runtime. Dando al modello lo spazio computazionale per testare molteplici traiettorie di ragionamento, valutare ipotesi controfattuali e autocorreggersi prima di produrre una risposta finale, Sol può ottenere scoperte nella risoluzione di problemi tecnici senza bisogno di un ingombro di parametri che faccia fondere le sottostazioni elettriche dei data center che lo ospitano.
Questo cambiamento architettonico livella il campo di gioco, alzando contemporaneamente la barriera all'ingresso per l'integrazione aziendale. Sviluppare sistemi in grado di allocare in modo intelligente il calcolo in fase di test in base alla difficoltà ambientale di un compito in arrivo è straordinariamente complesso. Se GPT-5.6 riuscisse a standardizzare questa allocazione dinamica tra Sol, Terra e Luna, costringerà i laboratori di frontiera concorrenti ad abbandonare i paradigmi API semplici e uniformi e ad adottare ambienti di runtime multi-livello simili per rimanere commercialmente competitivi.
Il calcolo aziendale prima dell'orizzonte di luglio
Con l'avvicinarsi della data di rilascio prevista, i leader della tecnologia aziendale devono preparare le proprie infrastrutture a un processo di integrazione più segmentato. I giorni in cui bastava puntare un'applicazione verso un singolo endpoint del modello e lasciar perdere sono finiti. L'implementazione di GPT-5.6 richiederà un controllo rigoroso delle pipeline di dati interne per determinare esattamente dove il ragionamento ad alta latenza e alto costo di Sol sia veramente giustificato e dove le efficienze semplificate di Terra e Luna possano guidare i margini operativi.
Per gli ingegneri di sistema e gli architetti tecnici, l'arrivo di Sol, Terra e Luna è un riconoscimento pragmatico della realtà. L'intelligenza nel software non può esistere indipendentemente dal silicio, dal rame e dal fluido di raffreddamento che la sostiene. Dividendo le sue capacità di frontiera in classi operative mirate, OpenAI sembra pronta a fornire un'architettura basata non solo su benchmark cognitivi teorici, ma sulle realtà fredde e pratiche del calcolo su scala industriale.



Comments
No comments yet. Be the first!