El enfoque monolítico hacia la inteligencia artificial de vanguardia está llegando a un final definitivo. Los informes que indican que OpenAI tiene la intención de lanzar su próxima gran iteración, denominada GPT-5.6, bajo un marco tripartito bautizado como Sol, Terra y Luna, destacan un giro industrial que ya debería haberse producido. En lugar de ofrecer un único modelo difícil de manejar encargado de gestionar todo, desde el álgebra de bachillerato hasta la ingeniería de sistemas compleja, la arquitectura se está segmentando directamente en la capa de despliegue. El objetivo programado para el 9 de julio señala que la carrera por la escala de parámetros brutos ha cedido formalmente ante las realidades de la economía de inferencia, los umbrales térmicos de los bastidores de servidores y las demandas operativas del hardware industrial.
Para los desarrolladores empresariales y los ingenieros de hardware, el cambio a un paradigma escalonado —que refleja la escala astronómica con Sol como buque insignia, Terra como el caballo de batalla terrestre y Luna como el satélite compacto de alta eficiencia— no es simplemente un cambio de marca comercial. Representa un compromiso de ingeniería forzado por los límites físicos de la infraestructura actual de los centros de datos. A medida que el volumen de tokens continúa aumentando globalmente, ejecutar mezclas de expertos de billones de parámetros para tareas deterministas de baja complejidad se ha vuelto económicamente insostenible. GPT-5.6 parece diseñado para establecer límites operativos rígidos en torno a las asignaciones de cómputo, alineando presupuestos específicos de FLOP con los requisitos cognitivos reales de distintas cargas de trabajo.
Disección de la tríada: razonamiento de vértice, escala empresarial y utilidad en el borde
Aunque OpenAI ha mantenido un estricto silencio oficial respecto a la nomenclatura interna, las filtraciones sobre la configuración de Sol, Terra y Luna revelan objetivos de hardware distintos. Sol se sitúa en el vértice del clúster, diseñado explícitamente para el razonamiento de varios pasos, la simulación científica densa y la programación generativa abierta. Se espera que este modelo integre mecanismos profundos de cómputo en tiempo de prueba, escalando dinámicamente su procesamiento de cadena de pensamiento en función de la dificultad del problema. Para la dinámica de fluidos computacional, el modelado de tensión estructural y la telemetría financiera de alto riesgo, Sol proporciona la reserva profunda de parámetros necesaria para suprimir las tasas de alucinación por debajo de los umbrales empresariales críticos.
Terra ocupa el terreno intermedio, funcionando como el reemplazo previsto para los puntos finales de API de alto rendimiento actuales. Construido sobre una base de mezcla de expertos (MoE) agresivamente optimizada, Terra equilibra la latencia con la fidelidad semántica, apuntando directamente a los conductos de software corporativo, el análisis de documentos a gran escala y las integraciones de clientes en tiempo real. Al activar solo una pequeña fracción de su base total de parámetros por paso hacia adelante, Terra minimiza la contención del bus de memoria en nodos aceleradores de alta densidad, lo que permite a los proveedores de la nube maximizar las consultas de usuarios simultáneos por megavatio de energía consumida.
El nivel más atractivo desde la perspectiva de la automatización industrial es Luna. Dimensionado para una velocidad extrema y bajas huellas de memoria, se entiende ampliamente que Luna es un modelo fuertemente destilado capaz de despliegue en el borde o ejecución local con latencia casi nula. En las líneas de fabricación modernas y los centros de logística automatizados, esperar cientos de milisegundos a que un servidor en la nube devuelva un token de inferencia es inaceptable. Luna parece diseñado para operar cómodamente dentro de los límites de memoria del hardware empresarial de clase estación de trabajo y aceleradores de borde integrados, proporcionando una comprensión contextual inmediata en el límite físico donde el software se encuentra con la maquinaria industrial.
Las realidades térmicas y la economía del cómputo en centros de datos
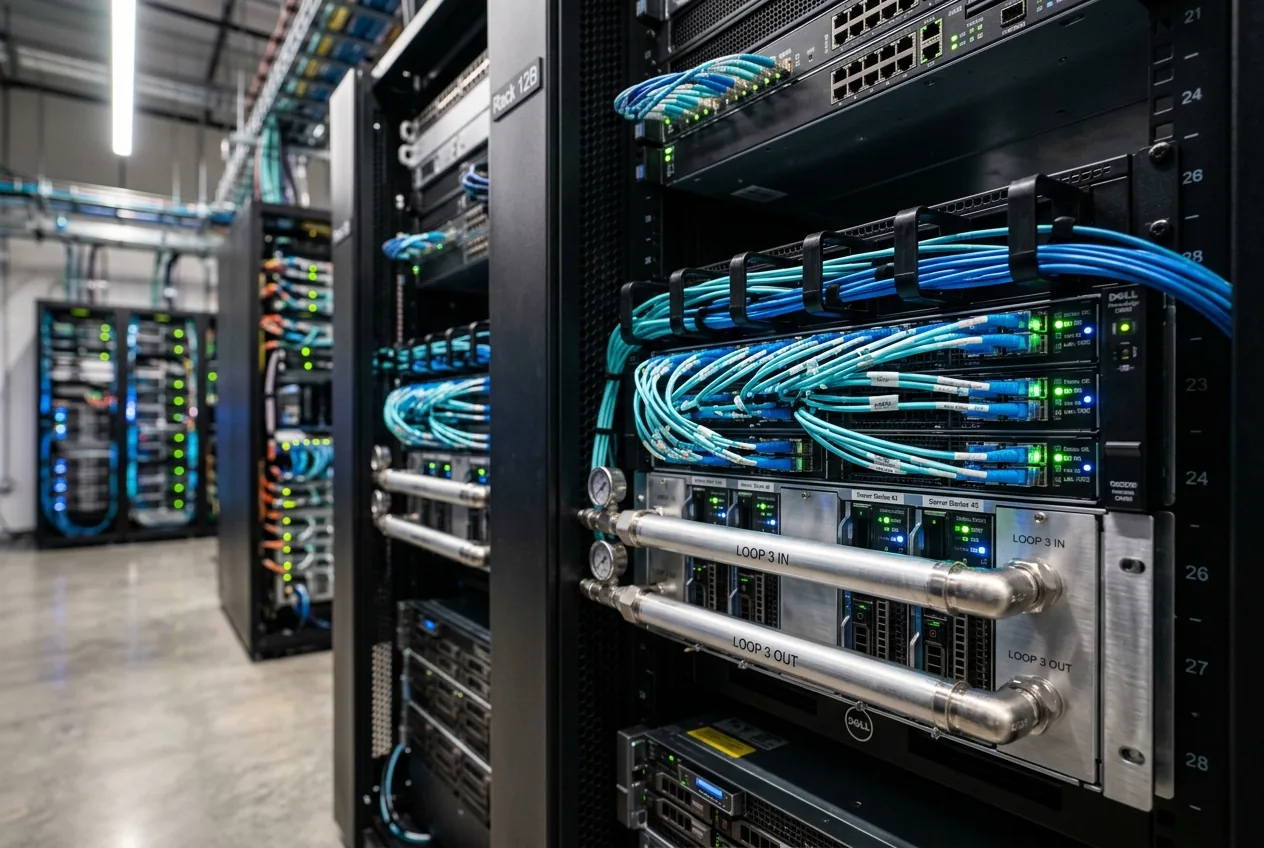
Para entender por qué OpenAI está buscando este lanzamiento estratificado, hay que observar las limitaciones mecánicas dentro de los centros de datos modernos. Los clústeres de entrenamiento de vanguardia y las granjas de servidores de inferencia se están topando directamente con los techos de refrigeración y las limitaciones de la red eléctrica local. La era de escalar ciegamente los conteos de parámetros sin tener en cuenta el consumo de energía ha chocado con los límites eléctricos de la infraestructura municipal y los cuellos de botella de fabricación de los avanzados intercambiadores de calor de líquido a aire. Los hiperescaladores ya no pueden justificar el vertido de energía eléctrica bruta en un modelo de vanguardia único y pesado cuando el ochenta por ciento de las consultas empresariales solo requieren una manipulación sintáctica moderada.
Los costes de inferencia, más que los costes de entrenamiento, dominan ahora los balances de las operaciones de IA avanzadas. Cada milisegundo que una unidad de procesamiento gráfico pasa manteniendo cachés clave-valor (KV) en memoria de alto ancho de banda (HBM) para una conexión inactiva o de generación lenta representa una pérdida de ingresos. Al desacoplar las cargas de trabajo en Sol, Terra y Luna, OpenAI puede implementar una cuantificación de caché KV hiperagresiva y una decodificación especulativa en toda la flota. En esta configuración, el nivel ligero Luna puede actuar como un motor de redacción especulativa, prediciendo secuencias de tokens que luego son validadas en paralelo por los niveles más capaces, Terra o Sol, recortando tanto la latencia de extremo a extremo como el coste energético por respuesta completada.
Además, los balances empresariales están imponiendo un nivel de disciplina computacional que no existía durante el ciclo inicial de inversión en IA generativa. Los directores de información ya no están dispuestos a suscribir facturas de inferencia abiertas para herramientas internas. Las familias de modelos estratificados permiten a las organizaciones construir conductos de enrutamiento deterministas: enrutando tareas de triaje baratas a través de Luna, lógica compleja a través de Terra y reservando a Sol estrictamente para síntesis estratégica de alto valor o verificación de ingeniería autónoma, manteniendo así los gastos de cómputo vinculados directamente al valor del negocio.
Implicaciones para los sistemas embebidos y la robótica industrial
En los campos de la robótica, la optimización de la cadena de suministro y el aseguramiento de calidad automatizado, el perfil de latencia de un modelo de IA es tan crítico como su precisión de referencia. Un brazo robótico que opera dentro de una instalación de clasificación de alta velocidad o una celda de ensamblaje colaborativo no puede hacer una pausa para viajes de ida y vuelta de paquetes basados en la nube al ajustar sus trayectorias cinemáticas ante un obstáculo inesperado. Los conductos de visión-lenguaje-acción (VLA) requieren una integración sensorial instantánea, operando en bucles deterministas estrictos en tiempo real medidos en milisegundos de un solo dígito.
Si el nivel Luna ofrece la eficiencia de parámetros que sugieren las primeras filtraciones técnicas, podría servir como la capa semántica fundamental para la próxima generación de vehículos guiados automatizados (AGV) y robots móviles autónomos (AMR). Ejecutándose en pilas de cómputo localizadas —como módulos industriales a bordo que consumen menos de cien vatios—, Luna podría interpretar descripciones espaciales de escenas, traducir directivas de lenguaje natural de alto nivel en puntos de referencia de coordenadas espaciales y monitorear anomalías de salud del sistema directamente en la planta de fábrica sin una conexión de red de área amplia activa.
Esta capacidad cambia fundamentalmente los perfiles de mantenimiento y despliegue de los sistemas de automatización industrial. En lugar de depender de una lógica de escalera rígida y preprogramada o de rutinas de visión artificial clásica costosas y frágiles, los ingenieros pueden desplegar sistemas adaptativos capaces de manejar variaciones físicas en las líneas de montaje. La integración de Luna en el borde físico, respaldada por una supervisión asíncrona procesada por lotes desde instancias de Terra o Sol basadas en la nube para el análisis de telemetría de toda la flota, dibuja el modelo para una arquitectura ciberfísica verdaderamente escalable.
El giro estratégico hacia el cómputo en tiempo de prueba sobre la escala bruta
La fecha de despliegue del 9 de julio, si se materializa, también captura a OpenAI en un momento crítico de transición arquitectónica. Las leyes de escala fundamentales establecidas durante la última media década —que dictaban que simplemente añadir más tokens y más parámetros produciría saltos continuos y predecibles en la inteligencia— han encontrado la inevitable meseta de rendimientos decrecientes. El texto de entrenamiento de alta calidad generado por humanos se ha agotado en gran medida, obligando a los arquitectos de modelos a confiar en complejos conductos de datos sintéticos, entornos de aprendizaje por refuerzo y arquitecturas de búsqueda durante la inferencia.
Sol representa la manifestación física de esta nueva dirección filosófica. En lugar de quemar miles de millones de dólares en gastos de capital simplemente para ampliar la base de parámetros preentrenados, el énfasis se ha desplazado hacia los algoritmos de búsqueda en tiempo de ejecución. Al dar al modelo el espacio computacional para probar múltiples trayectorias de razonamiento, evaluar hipótesis contrafactuales y autocorregirse antes de generar una respuesta terminal, Sol puede lograr avances en la resolución de problemas técnicos sin necesidad de una huella de parámetros que derrita las subestaciones eléctricas de sus centros de datos anfitriones.
Este cambio arquitectónico nivela el campo de juego mientras eleva simultáneamente la barrera de entrada para la integración empresarial. Desarrollar sistemas que puedan asignar inteligentemente el cómputo en tiempo de prueba en función de la dificultad ambiental de una tarea entrante es extraordinariamente complejo. Si GPT-5.6 estandariza con éxito esta asignación dinámica en Sol, Terra y Luna, obligará a los laboratorios de vanguardia competidores a abandonar los paradigmas de API uniformes y simplistas y a adoptar entornos de tiempo de ejecución de múltiples niveles similares para seguir siendo comercialmente competitivos.
El cálculo empresarial ante el horizonte de julio
A medida que se acerca la fecha de lanzamiento prevista, los líderes de tecnología empresarial deben preparar sus infraestructuras para un proceso de integración más segmentado. Los días de simplemente apuntar una aplicación a un único punto final de modelo y olvidarse han terminado. Desplegar GPT-5.6 requerirá una auditoría rigurosa de los conductos de datos internos para determinar exactamente dónde está realmente justificado el razonamiento de alta latencia y alto coste de Sol, y dónde pueden las eficiencias optimizadas de Terra y Luna impulsar los márgenes operativos.
Para los ingenieros de sistemas y arquitectos técnicos, la llegada de Sol, Terra y Luna es un reconocimiento pragmático de la realidad. La inteligencia en el software no puede existir independientemente del silicio, el cobre y el fluido refrigerante que la sustenta. Al dividir sus capacidades de vanguardia en clases operativas dirigidas, OpenAI parece listo para ofrecer una arquitectura basada no solo en referentes cognitivos teóricos, sino en las realidades prácticas y frías del cómputo a escala industrial.



Comments
No comments yet. Be the first!