L'approche monolithique de l'intelligence artificielle de pointe touche à sa fin. Les rapports indiquant qu'OpenAI a l'intention de lancer sa prochaine itération majeure, désignée GPT-5.6, selon un cadre tripartite baptisé Sol, Terra et Luna, soulignent un tournant industriel attendu depuis longtemps. Plutôt que de fournir un modèle unique et encombrant chargé de tout gérer, de l'algèbre du lycée à l'ingénierie système complexe, l'architecture est segmentée directement au niveau de la couche de déploiement. L'objectif fixé au 9 juillet marque le fait que la course à l'échelle brute des paramètres a officiellement cédé la place aux réalités de l'économie de l'inférence, aux seuils thermiques des baies de serveurs et aux exigences opérationnelles du matériel industriel.
Pour les développeurs d'entreprise et les ingénieurs matériel, le passage à un paradigme à plusieurs niveaux — reflétant une échelle astronomique avec Sol en tant que vaisseau amiral, Terra comme cheval de bataille terrestre et Luna en tant que satellite compact à haute efficacité — n'est pas qu'un simple rebranding marketing. Cela représente un compromis d'ingénierie imposé par les limites physiques de l'infrastructure actuelle des centres de données. Alors que le volume de jetons continue d'augmenter à l'échelle mondiale, l'exécution de modèles "mixture-of-experts" (Mélange d'experts) à mille milliards de paramètres pour des tâches déterministes à faible complexité est devenue économiquement intenable. GPT-5.6 semble conçu pour établir des limites opérationnelles rigides autour des allocations de calcul, en alignant des budgets de FLOP spécifiques sur les exigences cognitives réelles de différentes charges de travail.
Dissociation de la triade : Raisonnement de pointe, échelle entreprise et utilité en périphérie (Edge)
Bien qu'OpenAI ait maintenu un silence officiel strict concernant sa nomenclature interne, les fuites entourant la configuration de Sol, Terra et Luna révèlent des cibles matérielles distinctes. Sol se situe au sommet du cluster, conçu explicitement pour le raisonnement en plusieurs étapes, la simulation scientifique dense et la programmation générative ouverte. Ce modèle devrait intégrer des mécanismes profonds de calcul au moment du test (test-time compute), adaptant dynamiquement son traitement de la chaîne de pensée en fonction de la difficulté du problème. Pour la dynamique des fluides computationnelle, la modélisation des contraintes structurelles et la télémétrie financière à haut risque, Sol fournit le réservoir profond de paramètres nécessaire pour réduire les taux d'hallucination en dessous des seuils critiques des entreprises.
Terra occupe la position médiane, servant de remplacement prévu pour les points de terminaison d'API à haut débit actuels. Construit sur une base « mixture-of-experts » (MoE) agressivement optimisée, Terra équilibre la latence et la fidélité sémantique, visant directement les pipelines logiciels d'entreprise, l'analyse de documents à grande échelle et les intégrations clients en temps réel. En n'activant qu'une fraction légère de sa base totale de paramètres par passage direct, Terra minimise la contention du bus mémoire sur les nœuds accélérateurs haute densité, permettant aux fournisseurs cloud de maximiser les requêtes utilisateur simultanées par mégawatt d'énergie consommée.
Le niveau le plus convaincant du point de vue de l'automatisation industrielle est Luna. Dimensionné pour une vitesse extrême et une faible empreinte mémoire, Luna est largement perçu comme un modèle fortement distillé, capable d'être déployé en périphérie (edge) ou d'une exécution locale à latence quasi nulle. Dans les lignes de fabrication modernes et les centres logistiques automatisés, attendre des centaines de millisecondes qu'un serveur cloud externe renvoie un jeton d'inférence est inacceptable. Luna semble conçu pour fonctionner confortablement dans les enveloppes mémoire du matériel d'entreprise de classe station de travail et des accélérateurs de périphérie embarqués, fournissant une compréhension contextuelle immédiate à la limite physique où le logiciel rencontre la machinerie industrielle.
Les réalités thermiques et économiques du calcul en centre de données
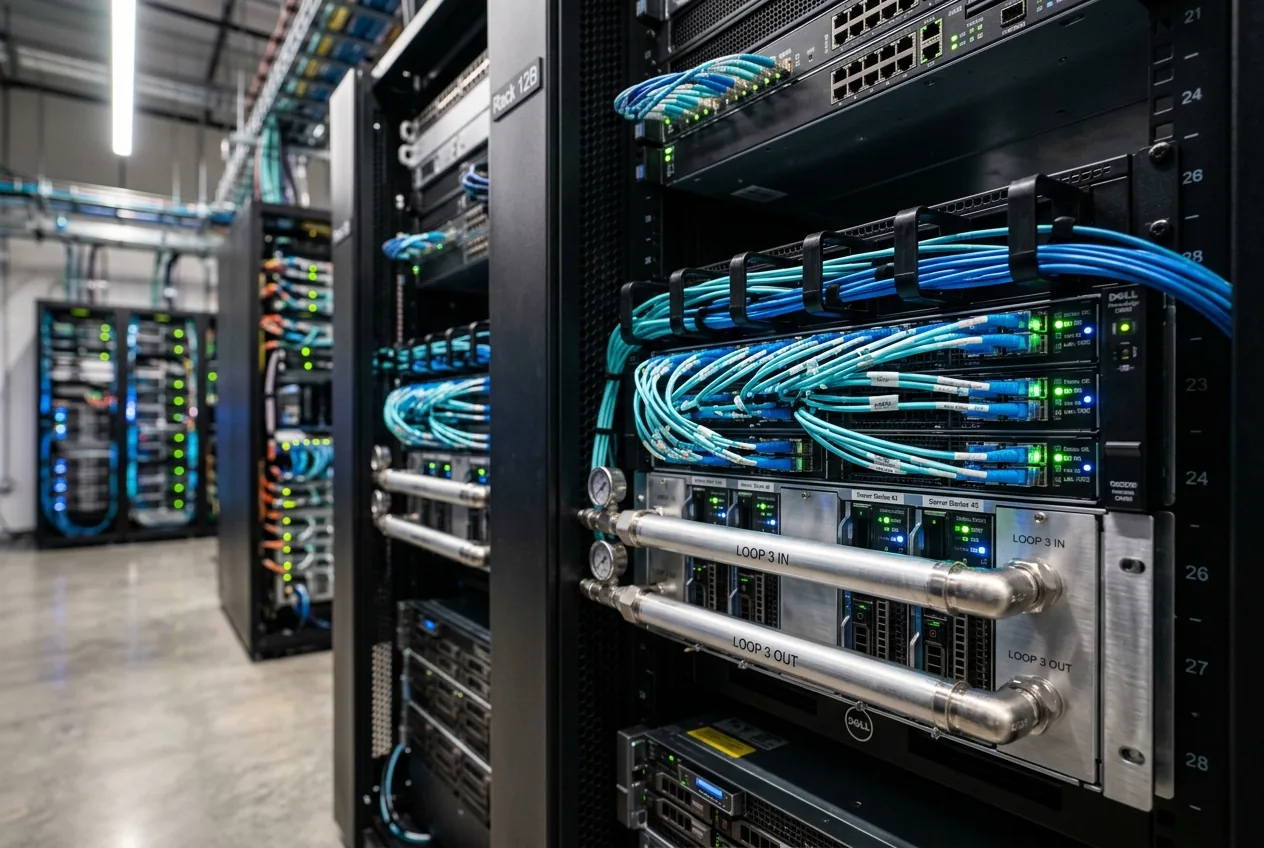
Pour comprendre pourquoi OpenAI poursuit ce déploiement stratifié, il faut examiner les contraintes mécaniques au sein des centres de données modernes. Les clusters d'entraînement de pointe et les fermes de serveurs d'inférence se heurtent directement aux plafonds de refroidissement et aux contraintes locales du réseau électrique. L'ère de l'augmentation aveugle du nombre de paramètres sans égard pour la consommation d'énergie s'est heurtée aux limites électriques de l'infrastructure municipale et aux goulots d'étranglement de fabrication des échangeurs thermiques avancés liquide-air. Les hyperscalers ne peuvent plus justifier le gaspillage d'énergie électrique brute dans un modèle unique et lourd, alors que quatre-vingts pour cent des requêtes des entreprises ne nécessitent qu'une manipulation syntaxique modérée.
Les coûts d'inférence, plutôt que les coûts d'entraînement, dominent désormais les bilans des opérations d'IA avancées. Chaque milliseconde qu'une unité de traitement graphique (GPU) passe à maintenir des caches clé-valeur (KV) dans une mémoire à large bande passante (HBM) pour une connexion inactive ou lente représente un manque à gagner. En découplant les charges de travail en Sol, Terra et Luna, OpenAI peut mettre en œuvre une quantification hyper-agressive des caches KV et un décodage spéculatif sur l'ensemble de la flotte. Dans cette configuration, le niveau léger Luna peut agir comme un moteur de brouillon spéculatif, prédisant des séquences de jetons qui sont ensuite validées en parallèle par les niveaux plus performants Terra ou Sol, réduisant ainsi à la fois la latence de bout en bout et le coût énergétique par réponse complétée.
En outre, les bilans des entreprises imposent un niveau de discipline computationnelle qui n'existait pas lors du premier cycle d'investissement dans l'IA générative. Les directeurs des systèmes d'information ne sont plus disposés à souscrire à une facturation d'inférence illimitée pour les outils internes. Les familles de modèles stratifiés permettent aux organisations de construire des pipelines de routage déterministes : acheminer les tâches de triage bon marché via Luna, la logique complexe via Terra, et réserver Sol strictement pour la synthèse stratégique à haute valeur ajoutée ou la vérification d'ingénierie autonome, liant ainsi les dépenses de calcul directement à la valeur métier.
Implications pour les systèmes embarqués et la robotique industrielle
Dans les domaines de la robotique, de l'optimisation de la chaîne d'approvisionnement et de l'assurance qualité automatisée, le profil de latence d'un modèle d'IA est tout aussi critique que sa précision de référence. Un bras robotique fonctionnant dans une installation de tri à haute vitesse ou une cellule d'assemblage collaborative ne peut pas faire de pause pour des allers-retours de paquets basés sur le cloud lors de l'ajustement de ses trajectoires cinématiques face à un obstacle inattendu. Les pipelines vision-langage-action (VLA) nécessitent une intégration sensorielle instantanée, fonctionnant sur des boucles déterministes en temps réel mesurées en quelques millisecondes.
Si le niveau Luna offre l'efficacité de paramètres suggérée par les premières fuites techniques, il pourrait servir de couche sémantique fondamentale pour les véhicules à guidage automatique (AGV) et les robots mobiles autonomes (AMR) de nouvelle génération. Fonctionnant sur des piles de calcul localisées — telles que des modules industriels embarqués consommant moins de cent watts — Luna pourrait interpréter des descriptions spatiales de scènes, traduire des directives en langage naturel de haut niveau en points de coordonnées spatiaux, et surveiller les anomalies de santé du système directement dans l'usine sans connexion réseau étendu active.
Cette capacité modifie fondamentalement les profils de maintenance et de déploiement des systèmes d'automatisation industrielle. Plutôt que de s'appuyer sur une logique Ladder rigide et préprogrammée ou sur des routines de vision par ordinateur classiques coûteuses et fragiles, les ingénieurs peuvent déployer des systèmes adaptatifs capables de gérer les variances physiques sur les lignes d'assemblage. L'intégration de Luna à la périphérie physique, soutenue par une surveillance asynchrone traitée par lots provenant d'instances cloud Terra ou Sol pour l'analyse de télémétrie à l'échelle de la flotte, dessine le plan d'une architecture cyber-physique véritablement évolutive.
Le pivot stratégique vers le calcul au moment du test plutôt que l'échelle brute
La date de déploiement du 9 juillet, si elle se concrétise, capture également OpenAI à un moment critique de transition architecturale. Les lois d'échelle fondamentales établies au cours de la dernière demi-décennie — qui dictaient que le simple ajout de jetons et de paramètres produirait des sauts continus et prévisibles d'intelligence — ont rencontré l'inévitable plateau des rendements décroissants. Les textes d'entraînement de haute qualité générés par les humains ont été largement épuisés, obligeant les architectes de modèles à s'appuyer sur des pipelines de données synthétiques complexes, des environnements d'apprentissage par renforcement et des architectures de recherche au moment de l'inférence.
Sol représente la manifestation physique de cette nouvelle direction philosophique. Au lieu de brûler des milliards de dollars en dépenses d'investissement simplement pour élargir la base de paramètres pré-entraînés, l'accent a été mis sur les algorithmes de recherche à l'exécution. En donnant au modèle l'espace computationnel pour tester plusieurs trajectoires de raisonnement, évaluer des hypothèses contrefactuelles et s'autocorriger avant de fournir une réponse terminale, Sol peut réaliser des percées dans la résolution de problèmes techniques sans avoir besoin d'une empreinte de paramètres qui ferait fondre les sous-stations électriques de ses centres de données hôtes.
Ce changement architectural uniformise les règles du jeu tout en élevant la barrière à l'entrée pour l'intégration en entreprise. Développer des systèmes capables d'allouer intelligemment le calcul au moment du test en fonction de la difficulté ambiante d'une tâche entrante est extrêmement complexe. Si GPT-5.6 réussit à normaliser cette allocation dynamique à travers Sol, Terra et Luna, il forcera les laboratoires concurrents à abandonner les paradigmes d'API simples et uniformes pour adopter des environnements d'exécution multi-niveaux similaires afin de rester commercialement compétitifs.
Le calcul d'entreprise avant l'horizon de juillet
À l'approche de la date de sortie prévue, les dirigeants de la technologie d'entreprise doivent préparer leurs infrastructures à un processus d'intégration plus segmenté. L'époque où il suffisait de pointer une application vers un point de terminaison de modèle unique est révolue. Le déploiement de GPT-5.6 exigera un audit rigoureux des pipelines de données internes pour déterminer exactement où le raisonnement à haute latence et à coût élevé de Sol est réellement justifié, et où les efficacités rationalisées de Terra et Luna peuvent améliorer les marges opérationnelles.
Pour les ingénieurs système et les architectes techniques, l'arrivée de Sol, Terra et Luna est une reconnaissance pragmatique de la réalité. L'intelligence logicielle ne peut exister indépendamment du silicium, du cuivre et du fluide de refroidissement qui la soutient. En divisant ses capacités de pointe en classes opérationnelles ciblées, OpenAI semble prêt à fournir une architecture ancrée non seulement dans des repères cognitifs théoriques, mais aussi dans les réalités pratiques et froides du calcul à échelle industrielle.



Comments
No comments yet. Be the first!