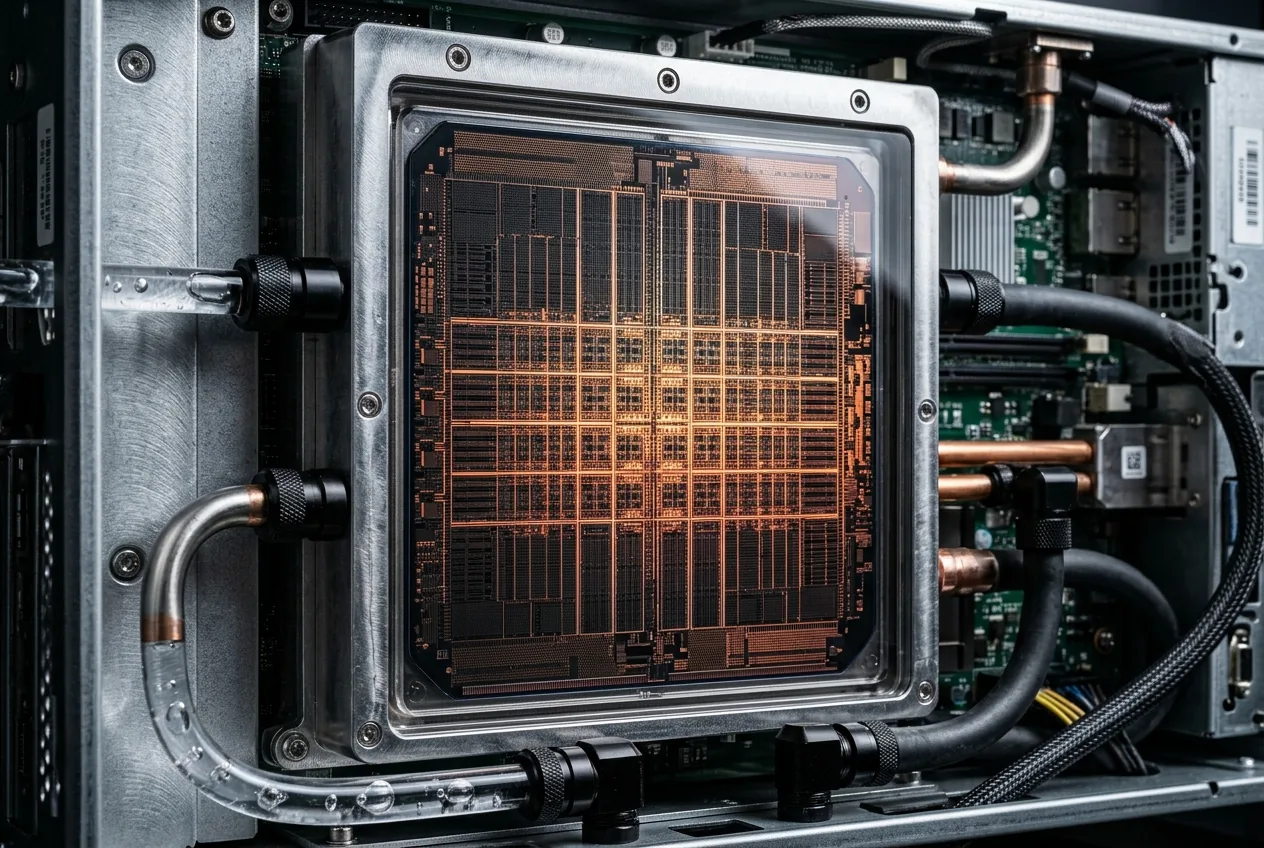
In der Machine-Learning-Infrastruktur gleicht das Spannungsfeld zwischen der logischen Schlussfolgerungsfähigkeit eines Modells und der operativen Latenz seit Langem einem Erhaltungssatz: Wer echtzeitfähige, deterministische Antworten benötigte, musste das Modell durch Komprimierung, Quantisierung oder Destillation auf leichtgewichtige Architekturen reduzieren. Wer hingegen logische Kapazitäten auf Spitzenniveau erforderte, nahm den Latenzaufschlag speichergebundener GPU-Cluster in Kauf. Die Vorschau von OpenAI auf den „Ultrafast“-Modus für das Flaggschiffmodell GPT-5.6 Sol greift diesen Kompromiss systematisch an. Mit einer bis zu 14-mal höheren Geschwindigkeit als bei Standard-Produktionsumgebungen generiert die neue Stufe bis zu 750 Output-Token pro Sekunde und schließt damit die Lücke zwischen Spitzenintelligenz und synchroner Ausführung in Maschinengeschwindigkeit.
Die Ankündigung verlagert die technische Debatte von der reinen Parameterskalierung hin zur Mechanik des Inferenzdurchsatzes. Statt auf inkrementelle Optimierungen bestehender tensorparalleler Server-Racks zu setzen, wird die neue Geschwindigkeitsklasse durch eine direkte Hardware-Integration mit dem Chiphersteller Cerebras ermöglicht. Die Bereitstellung von 750 Token pro Sekunde verwandelt generative Modelle von kontemplativen, schrittweisen Systemen in kontinuierliche Datenpipelines, die mit der Bandbreite menschlicher Dialoge, quantitativen Handelsumgebungen und autonomen industriellen Kontrollschleifen mithalten können.
Überwindung der autoregressiven „Memory Wall“
Um zu verstehen, warum ein 14-facher Geschwindigkeitssprung von Bedeutung ist, muss man den technischen Flaschenhals der autoregressiven Token-Generierung analysieren. Die Inferenz von großen Sprachmodellen ist in der Generierungsphase notorisch eher durch die Speicherbandbreite als durch die Rechenleistung limitiert. Während die anfängliche Aufnahme des Prompts die Matrixmultiplikationen über Tausende von Tensorkernen parallelisieren kann, erfolgt die Generierung der Output-Token sequenziell: Jedes neue Token erfordert das Auslesen des gesamten Modellgewichts und des Key-Value (KV) Caches aus dem Speicher. Bei herkömmlichen Clustern, die aus diskreten GPUs bestehen, welche über PCIe-Busse und NVLink-Switches verbunden sind, erzeugt die physikalische Übertragungszeit zwischen High-Bandwidth-Memory (HBM)-Stacks und der Rechenlogik eine unüberwindbare Latenzuntergrenze.
Für ein Modell mit der Komplexität von GPT-5.6 Sol eliminiert die Ausführung auf diesem Wafer-Scale-Gewebe den Serialisierungsaufwand. Das Ergebnis ist eine Inferenzumgebung, in der die Speicherübertragungsgeschwindigkeiten mit den arithmetischen Ausführungsraten übereinstimmen. Diese strukturelle Veränderung ermöglicht es OpenAI, 750 Token pro Sekunde zu liefern, ohne Modellschichten beschneiden, die Gleitkommapräzision auf ein unbrauchbares Niveau senken oder das kontextuelle Verständnis opfern zu müssen.
Schließung des Regelkreises in Industrie- und Digitalsystemen
Im Maschinenbau und in industriellen Systemen bestimmt die Latenz die Regelungstreue. Ein System, das fünf Sekunden benötigt, um Telemetriedaten zu analysieren, kann nicht an einem geschlossenen Regelkreis teilnehmen; es ist auf ein passives Post-Mortem-Logging beschränkt. Durch die Senkung der Latenz auf eine nahezu unmittelbare Ausgabe demonstrierte OpenAI, wie der Ultrafast-Modus funktionale, interaktive 3D-Lagersimulationen direkt aus beschreibenden Text-Prompts in Echtzeit generiert. Standard-Inferenzstufen bauen Umgebungen schrittweise auf und stottern bei räumlichen Berechnungen und Asset-Deklarationen; Ultrafast rendert die programmatische Logik und räumliche Geometrie mit Geschwindigkeiten, die mit einer nativen Grafik-Pipeline beim Kompilieren von Code vergleichbar sind.
Diese Geschwindigkeit verändert die Interaktion autonomer Software mit physischen und digitalen Assets. Bei OpenAI setzen die Engineering-Teams Ultrafast innerhalb automatisierter Incident-Response-Workflows ein. Bei komplexen Produktionsausfällen, wenn sich verteilte Telemetrie, Speicher-Traces und Fehlerprotokolle dynamisch verändern, entscheiden Sekunden über den Schadensradius. Anstatt darauf zu warten, dass ein Ingenieur einen langwierigen diagnostischen Inferenzzyklus durchläuft, erfasst die Ultrafast-Engine die Telemetrie aus mehreren Quellen, formuliert Hypothesen, führt Verifizierungsskripte aus und entwirft Korrektur-Patches, während die Anomalie noch aktiv voranschreitet.
Die gleiche Mechanik gilt für physische Lieferketten und automatisierte Anlagen. Wenn Roboterflotten auf Fehler bei der Kommissionierung oder räumliche Blockaden stoßen, erfordert die Lösung des Trajektoriekonflikts die Synthese von Sensordaten, kinematischen Beschränkungen und Lagerzustandstabellen. Ein Modell, das mit 750 Token pro Sekunde arbeitet, kann den unstrukturierten Fehlermodus analysieren, praktikable Neuberechnungen anstellen und Korrekturbefehle innerhalb der Standard-Zeitvorgaben industrieller speicherprogrammierbarer Steuerungen ausgeben.
Enterprise-Stresstests und Latenzeliminierung
Tests im Rahmen eines frühen Zugangs bei externen Unternehmenskunden zeigen, wie der Inferenzdurchsatz das Design kommerzieller Software verändert. Die quantitative Handelsfirma Jane Street hat die Ultrafast-Stufe in entwicklerorientierte Programmierumgebungen integriert und damit die Latenzbarriere beseitigt, die normalerweise die Konzentration von Programmierern bei komplexen, dateiübergreifenden Codetransformationen unterbricht. Wenn Codevervollständigungen und vollständige architektonische Refactorings schneller generiert werden, als ein Ingenieur sie scannen kann, bleibt die kognitive Schleife ungebrochen.
Bei Sprachanwendungen lösen die Latenzverbesserungen eine noch härtere strukturelle Einschränkung. Die Kommunikationsplattform Podium hat GPT-5.6 Sol Ultrafast in ihren produktiven Voice-Stack integriert. Historisch gesehen mussten konversationelle Sprachassistenten auf winzige, hochspezialisierte Modelle setzen, um die Antwortlatenz unter 500 Millisekunden zu halten – der Schwelle, ab der menschliche Konversation als unterbrochen und unnatürlich empfunden wird. Ultrafast ermöglicht es Entwicklern, tiefgehende Modelle mit vollen Parametern innerhalb der Audio-Streaming-Schleife ohne konversationelle Verzögerungen auszuführen, was es den Agenten ermöglicht, komplexe Anfragen zu analysieren, externe Datenbanken zu referenzieren und gesprochene Antworten ohne unangenehme Pausen zu synthetisieren.
Finanzforschungsplattformen wie Rogo und Workflow-Automatisierungsunternehmen wie Basis berichten von ähnlichen strukturellen Veränderungen. Komplexe, mehrstufige Dokumentenaggregationen, Finanzmodellierungen und die deterministische Nutzung von Tools erhöhen normalerweise die Latenz bei jedem Sub-Agent-Aufruf. Wenn ein Analyse-Agent ein halbes Dutzend Tools nacheinander aufrufen muss, macht eine 10-sekündige Verzögerung pro Schritt die interaktive Recherche unpraktikabel. Bei 750 Token pro Sekunde schließen Multi-Agenten-Orchestrierungen ihre End-to-End-Logikketten in Sekundenbruchteilen ab und wandeln eine stapelbasierte Datenextraktion in einen kontinuierlichen analytischen Dialog um.
Das ökonomische Kalkül maßgeschneiderter Wafer-Scale-Inferenz
Während die Leistungswerte des Ultrafast-Modus einen unbestreitbaren technischen Sprung darstellen, werfen sie auch komplexe infrastrukturelle und wirtschaftliche Fragen auf. Der Hyperscale-KI-Markt hat sich weitgehend auf standardisierte modulare Rack-Architekturen mit handelsüblichen GPUs konsolidiert. Der Einsatz von Wafer-Scale-Silizium erfordert eine maßgeschneiderte Stromverteilung, individuelle Flüssigkeitskühlsysteme und dedizierte Compiler-Toolchains, die in der Lage sind, massive Rechengraphen über einen gesamten Silizium-Wafer hinweg abzubilden, ohne auf Standard-Cluster-Routing angewiesen zu sein.
Die Investitionsrechnung für den Betrieb von Spitzenmodellen mit 14-facher Geschwindigkeit hängt vollständig von der Auslastungsdichte ab. Wafer-Scale-Engines weisen im Vergleich zu einzelnen modularen Dies, die aus Standard-300-mm-Ingots geschnitten werden, eine hohe Verpackungs- und Fertigungskomplexität auf. Da jedoch jeder Wafer Dutzende diskreter Serverknoten ersetzen kann und dabei weniger Watt pro geliefertem Token verbraucht, können die Betriebskosten der hochdichten Inferenz bei entsprechender Skalierung vorteilhaft werden. Wenn ein Unternehmen einen Premium-API-Preis für Ultrafast zahlt, dieser Tarif jedoch die Leerlaufzeiten der Mitarbeiter eliminiert, die Recheninfrastruktur konsolidiert und bisher unmögliche Echtzeitprodukte ermöglicht, verschieben sich die Gesamtbetriebskosten deutlich zugunsten von Hochdurchsatz-Silizium.
Kapazitätsengpässe werden das Einführungstempo bestimmen. OpenAI startet Ultrafast in einer eingeschränkten Vorschau-Stufe, gerade weil die Kapazität auf Wafer-Ebene nicht über Nacht in allgemeinen Colocation-Einrichtungen aufgebaut werden kann. Während die Fertigung bei Cerebras skaliert und OpenAI dedizierte Low-Latency-Cluster ausbaut, wird die Verfügbarkeit von 750-Token-pro-Sekunde-Spitzenmodellen testen, ob das breitere Technologie-Ökosystem bereit ist, seine Softwarearchitekturen um unmittelbare generative Intelligenz herum neu aufzubauen.
Der Wandel zur synchronen Maschinenintelligenz
Der Übergang von Standard-Inferenzgeschwindigkeiten zu Ultrafast markiert das Ende einer Ära, in der Maschinenintelligenz als asynchrone Beratungsebene behandelt wurde. Im ersten Jahrzehnt des kommerziellen Deep Learnings behandelten Softwareingenieure neuronale Netze wie Remote-Datenbankabfragen: Prompt absenden, Serialisierung abwarten und den Rest der Anwendung um den unvermeidlichen Latenzaufschlag herum strukturieren. Systemdesigns wurden darauf optimiert, diese Verzögerung durch Ladeanzeigen, progressives Rendering und spekulatives Vorabrufen zu verbergen.
Bei 750 Token pro Sekunde wird dieses gesamte Design-Paradigma obsolet. Spitzenmodelle sind keine entfernten Batch-Prozessoren mehr; sie sind synchrone Rechenprimitive, die in der Lage sind, komplexe symbolische Schlussfolgerungen innerhalb der operativen Taktzyklen moderner geschäftlicher und industrieller Software auszuführen. Während OpenAI und Cerebras den Zugang über die anfängliche Vorschau-Gruppe hinaus erweitern, wird sich der Wettbewerbsvorteil von der Frage, wer Zugang zu den intelligentesten Gewichten hat, auf die Frage verlagern, wer Systeme entwickeln kann, die rohe, ungefilterte Rechengeschwindigkeit vollständig ausschöpfen.



Kommentare
Noch keine Kommentare. Seien Sie der Erste!