En la infraestructura de aprendizaje automático, la tensión entre la capacidad de razonamiento de los modelos y la latencia operativa ha funcionado durante mucho tiempo como una ley de conservación: si se necesitaban respuestas deterministas en tiempo real, se recurría a la compresión, cuantización o destilación hacia arquitecturas ligeras. Si se requería un razonamiento de nivel avanzado, se aceptaba el impuesto de latencia impuesto por los clústeres de GPU limitados por la memoria. La vista previa de OpenAI del modo Ultrafast para su modelo insignia GPT-5.6 Sol ataca sistemáticamente ese compromiso. Con una velocidad de hasta 14 veces superior a las implementaciones de producción estándar, el nuevo nivel genera hasta 750 tokens de salida por segundo, cerrando la brecha entre la inteligencia de vanguardia y la ejecución sincrónica a velocidad de máquina.
El anuncio traslada el debate técnico de la escala bruta de parámetros a la mecánica del rendimiento de inferencia. En lugar de depender de optimizaciones incrementales de los racks de servidores con paralelismo de tensores existentes, esta categoría de velocidad se logra mediante una integración directa de hardware con el fabricante de chips Cerebras. Alcanzar 750 tokens por segundo transforma los modelos generativos de sistemas contemplativos y por turnos en tuberías de datos continuas capaces de seguir el ritmo de diálogos humanos de alto ancho de banda, entornos de comercio cuantitativo y bucles de control industrial autónomos.
Superar el muro de memoria autorregresivo
Para entender por qué es importante un salto de velocidad de 14 veces, uno debe analizar el cuello de botella de ingeniería de la generación de tokens autorregresivos. La inferencia de modelos de lenguaje extensos está notoriamente limitada por el ancho de banda de la memoria más que por el cómputo durante la fase de generación. Si bien la ingesta inicial de la instrucción puede paralelizar las multiplicaciones de matrices a través de miles de núcleos tensoriales, la generación de tokens de salida ocurre de manera secuencial: cada nuevo token requiere leer todos los pesos del modelo y la memoria caché de clave-valor (KV) de la memoria. En los clústeres convencionales compuestos por GPU discretas conectadas a través de buses PCIe y conmutadores NVLink, el tiempo de tránsito físico entre las pilas de memoria de alto ancho de banda (HBM) y la lógica de cómputo crea un límite de latencia inquebrantable.
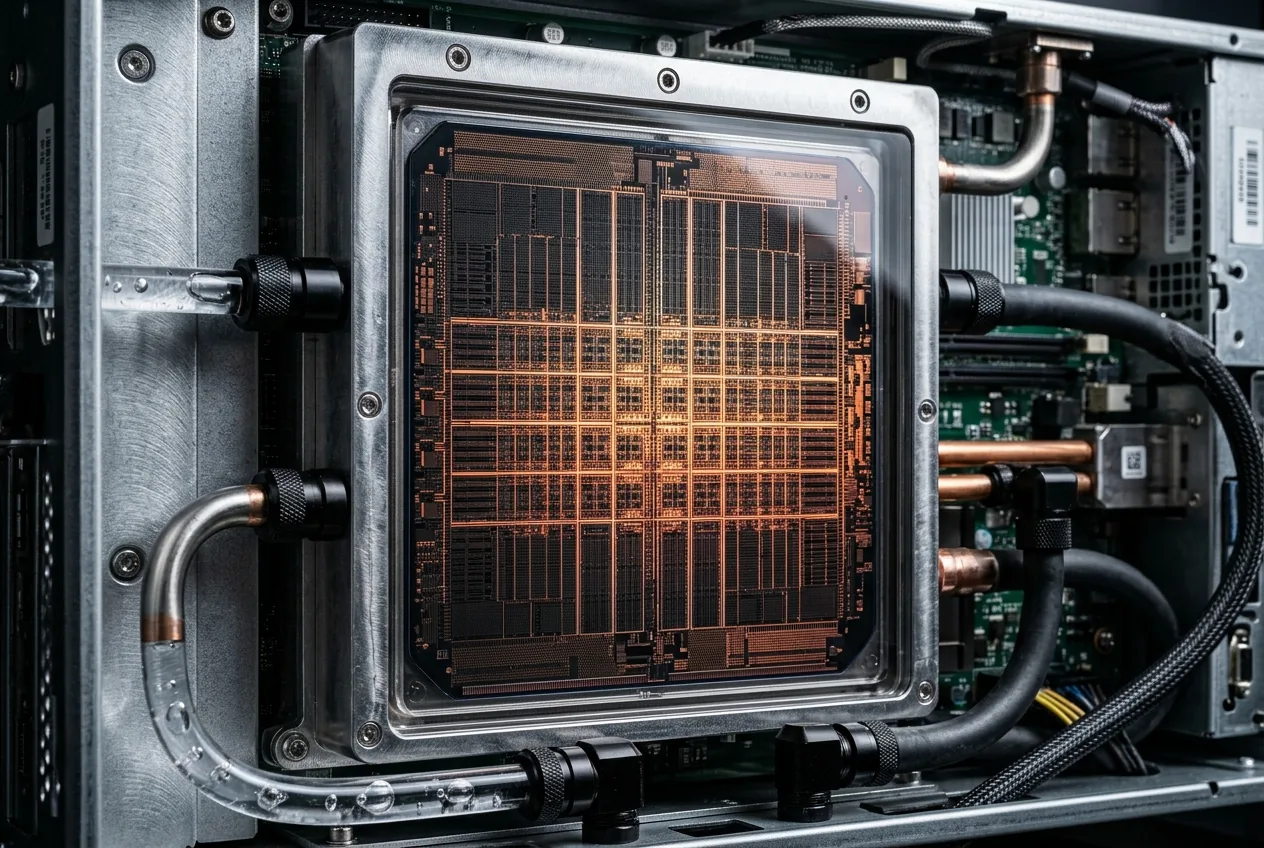
Para un modelo con la complejidad de GPT-5.6 Sol, ejecutarlo a través de esta estructura a escala de oblea elimina los gastos generales de serialización. El resultado es un entorno de inferencia donde las velocidades de transferencia de memoria coinciden con las tasas de ejecución aritmética. Este cambio estructural permite a OpenAI ofrecer 750 tokens por segundo sin necesidad de podar capas del modelo, degradar la precisión de punto flotante a niveles inoperables o sacrificar la comprensión contextual.
Cierre del bucle de control en sistemas industriales y digitales
En la ingeniería mecánica y los sistemas industriales, la latencia dicta la fidelidad del control. Un sistema que tarda cinco segundos en analizar la telemetría no puede participar en un control de supervisión de bucle cerrado; queda relegado al registro pasivo posterior. Al reducir la latencia a una salida casi instantánea, OpenAI demostró que el modo Ultrafast genera simulaciones de almacén en 3D funcionales e interactivas directamente a partir de instrucciones de texto descriptivas en tiempo real. Los niveles de inferencia estándar crean entornos de forma incremental, tartamudeando a través de cálculos espaciales y declaraciones de activos; Ultrafast renderiza la lógica programática y las geometrías espaciales a velocidades comparables a las de una canalización gráfica nativa compilando código.
Esta velocidad altera la forma en que el software autónomo interactúa con activos físicos y digitales. Dentro de OpenAI, los equipos de ingeniería han implementado Ultrafast en flujos de trabajo de respuesta a incidentes automatizados. Durante cortes de producción complejos, cuando la telemetría distribuida, los rastros de memoria y los registros de errores cambian dinámicamente, los segundos determinan el radio de impacto. En lugar de que un ingeniero espere a través de un ciclo de inferencia de diagnóstico prolongado, el motor Ultrafast ingiere telemetría de múltiples fuentes, formula hipótesis, ejecuta scripts de verificación y redacta parches correctivos mientras la anomalía aún se está propagando activamente.
La misma mecánica se aplica a las cadenas de suministro físicas y las instalaciones automatizadas. Cuando las flotas robóticas se encuentran con fallos de selección de casos límite o bloqueos espaciales, resolver el conflicto de trayectoria requiere sintetizar entradas de sensores, restricciones cinemáticas y tablas de estado de almacén. Un modelo que funciona a 750 tokens por segundo puede analizar el modo de fallo no estructurado, calcular recálculos viables y emitir comandos correctivos dentro de los umbrales de tiempo operativo estándar de los controladores lógicos programables industriales.
Pruebas de estrés empresarial y eliminación de latencia
Las pruebas de acceso temprano entre socios empresariales externos demuestran cómo la inferencia de alto rendimiento cambia el diseño de software comercial. La firma de comercio cuantitativo Jane Street ha integrado el nivel Ultrafast en entornos de programación orientados al desarrollador, colapsando la barrera de latencia que tradicionalmente rompe el enfoque del programador durante transformaciones de código complejas de múltiples archivos. Cuando las finalizaciones de código y las refactorizaciones arquitectónicas completas se generan más rápido de lo que un ingeniero puede escanearlas, el bucle cognitivo permanece ininterrumpido.
En las aplicaciones de voz, las mejoras de latencia resuelven una restricción estructural aún más dura. La plataforma de comunicación Podium integró GPT-5.6 Sol Ultrafast en su pila de voz de producción. Históricamente, los agentes de voz conversacionales tenían que depender de modelos pequeños y altamente especializados para mantener las latencias de respuesta de ida y vuelta por debajo de los 500 milisegundos, el umbral más allá del cual la conversación humana se siente rota y antinatural. Ultrafast permite a los desarrolladores ejecutar modelos de razonamiento profundo y de parámetros completos dentro del bucle de transmisión de audio sin fluctuaciones conversacionales, lo que permite a los agentes analizar consultas complejas, realizar referencias cruzadas de bases de datos externas y sintetizar respuestas habladas sin pausas incómodas.
Las plataformas de investigación financiera como Rogo y las empresas de automatización de flujos de trabajo como Basis reportan cambios estructurales similares. La agregación compleja de documentos en varios pasos, el modelado financiero y el uso de herramientas deterministas suelen aumentar la latencia con cada invocación de subagente. Cuando un agente analítico debe llamar a media docena de herramientas de forma secuencial, un retraso de 10 segundos por paso hace que la investigación interactiva sea inviable. A 750 tokens por segundo, las orquestaciones de múltiples agentes completan sus cadenas de razonamiento de extremo a extremo en fracciones de segundo, convirtiendo la extracción de datos por lotes en un diálogo analítico continuo.
El cálculo económico de la inferencia a medida a escala de oblea
Si bien las cifras de rendimiento del modo Ultrafast representan un salto técnico innegable, también introducen complejas cuestiones infraestructurales y económicas. El mercado de IA a hiperescala se ha consolidado en gran medida en torno a arquitecturas de bastidor modulares estándar pobladas por GPU comerciales. La implementación de silicio a escala de oblea requiere una distribución de energía a medida, bucles de refrigeración líquida personalizados y cadenas de herramientas de compilación dedicadas capaces de mapear gráficos computacionales masivos a través de una oblea de silicio completa sin el enrutamiento de clúster estándar.
La ecuación de gasto de capital para ejecutar modelos de frontera a 14 veces la velocidad depende totalmente de la densidad de utilización. Los motores a escala de oblea conllevan una gran complejidad de empaquetado y fabricación en comparación con los troqueles modulares individuales cortados de lingotes estándar de 300 mm. Sin embargo, debido a que cada oblea puede reemplazar docenas de nodos de servidor discretos mientras consume menos vatios totales por token entregado, el gasto operativo de la inferencia de alta densidad puede volverse favorable a escala. Si una empresa paga un precio de nivel de API premium por Ultrafast, pero ese nivel elimina el tiempo de inactividad de los trabajadores, consolida la infraestructura informática y permite productos en tiempo real anteriormente imposibles, el costo total de propiedad se inclina bruscamente hacia el silicio de alto rendimiento.
Las limitaciones de capacidad dictarán la velocidad de despliegue. OpenAI está lanzando Ultrafast en un nivel de vista previa restringido precisamente porque la capacidad a escala de oblea no puede aumentarse de la noche a la mañana en instalaciones de colocación genéricas. A medida que la fabricación de Cerebras se escala y OpenAI construye clústeres dedicados de baja latencia, la disponibilidad de modelos de frontera de 750 tokens por segundo probará si el ecosistema tecnológico más amplio está preparado para reconstruir sus arquitecturas de software en torno a la inteligencia generativa instantánea.
El cambio hacia la inteligencia de máquina sincrónica
La transición de las velocidades de inferencia estándar a Ultrafast marca el fin de una era en la que la inteligencia de las máquinas se trataba como una capa de consultoría asincrónica. Durante la primera década del aprendizaje profundo comercial, los ingenieros de software trataban a las redes neuronales como consultas remotas a bases de datos: enviar una instrucción, esperar la serialización y estructurar el resto de la aplicación en torno al inevitable costo de latencia. Los diseños de sistemas se optimizaron para ocultar ese retraso mediante indicadores de carga, renderizado progresivo y pre-carga especulativa.
A 750 tokens por segundo, todo ese paradigma de diseño queda obsoleto. Los modelos de frontera ya no son procesadores por lotes distantes; son primitivas computacionales sincrónicas capaces de ejecutar un razonamiento simbólico complejo dentro de los ciclos de reloj operativos del software empresarial e industrial contemporáneo. A medida que OpenAI y Cerebras amplíen el acceso más allá del grupo de vista previa inicial, la ventaja competitiva se desplazará de quién tiene acceso a los pesos más inteligentes, a quién puede diseñar sistemas que aprovechen al máximo la velocidad computacional bruta y sin mitigaciones.



Comments
No comments yet. Be the first!