Dans le domaine de l'infrastructure d'apprentissage automatique, la tension entre la capacité de raisonnement d'un modèle et sa latence opérationnelle a longtemps fonctionné comme une loi de conservation : si vous aviez besoin de réponses déterministes en temps réel, vous deviez compresser, quantifier ou distiller vers des architectures légères. Si vous exigiez un raisonnement de niveau « frontière », vous deviez accepter la taxe de latence imposée par les clusters de GPU limités par la mémoire. L'aperçu par OpenAI du mode Ultrafast pour son modèle phare GPT-5.6 Sol s'attaque systématiquement à ce compromis. Fonctionnant jusqu'à 14 fois plus vite que les déploiements de production standard, ce nouveau niveau génère jusqu'à 750 jetons de sortie par seconde, comblant le fossé entre l'intelligence de pointe et l'exécution synchrone à la vitesse de la machine.
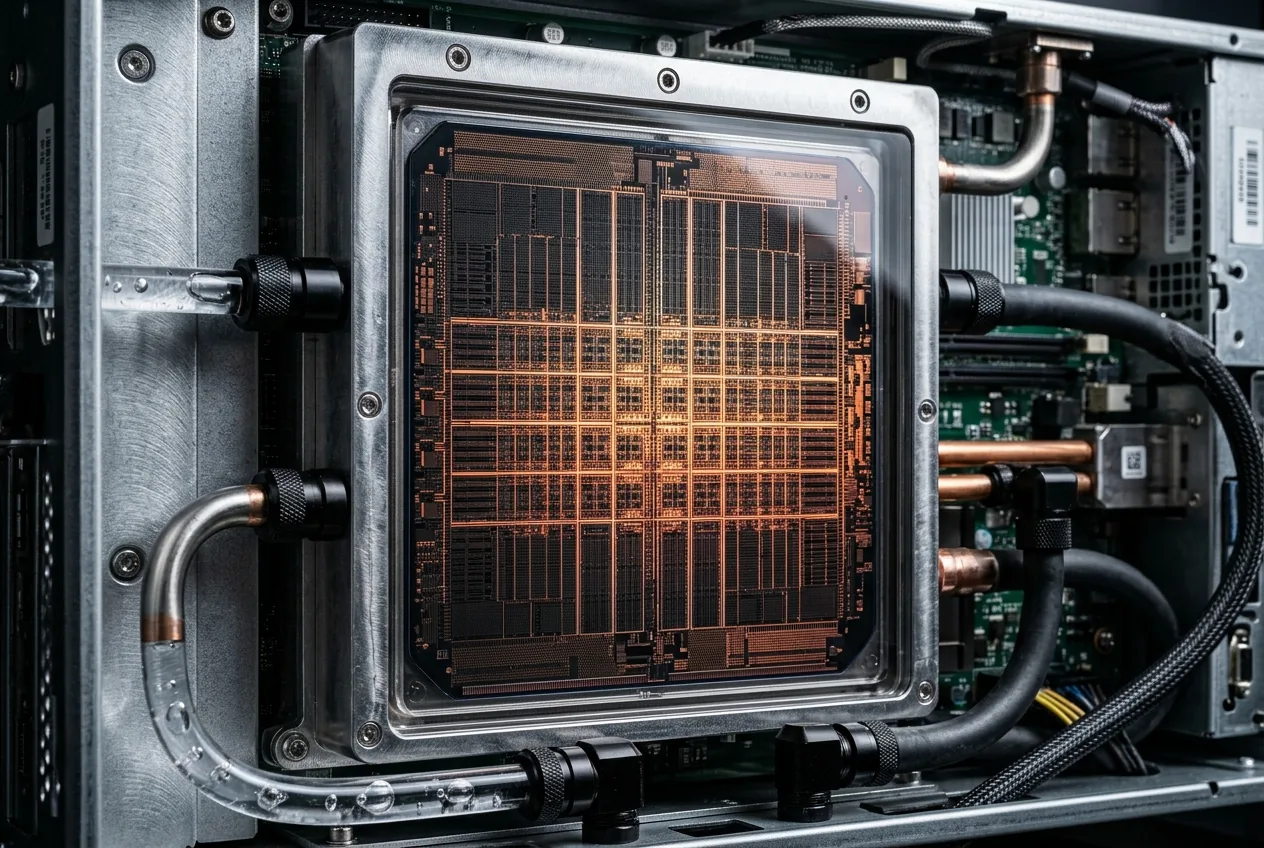
Cette annonce déplace le débat technique de l'échelle brute des paramètres vers la mécanique du débit d'inférence. Plutôt que de s'appuyer sur des optimisations incrémentales de baies de serveurs à parallélisme tensoriel existantes, cette classe de vitesse est propulsée par une intégration matérielle directe avec le fabricant de puces Cerebras. Délivrer 750 jetons par seconde transforme les modèles génératifs, passant de systèmes contemplatifs basés sur le tour par tour à des pipelines de données continus capables de suivre le rythme des dialogues humains à large bande passante, des environnements de trading quantitatif et des boucles de contrôle industriel autonomes.
Surmonter le mur de mémoire autorégressif
Pour comprendre pourquoi un bond de vitesse de 14 fois est significatif, il faut disséquer le goulot d'étranglement technique de la génération de jetons autorégressive. L'inférence des grands modèles de langage est notoirement limitée par la bande passante mémoire plutôt que par la capacité de calcul pendant la phase de génération. Alors que l'ingestion initiale de l'invite peut paralléliser les multiplications de matrices sur des milliers de cœurs tensoriels, la génération de jetons de sortie se produit séquentiellement : chaque nouveau jeton nécessite la lecture de l'intégralité des poids du modèle et du cache clé-valeur (KV) depuis la mémoire. Sur des clusters conventionnels composés de GPU discrets reliés via des bus PCIe et des commutateurs NVLink, le temps de transit physique entre les piles de mémoire à large bande passante (HBM) et la logique de calcul crée un seuil de latence incompressible.
Pour un modèle de la complexité de GPT-5.6 Sol, l'exécution sur cette architecture à l'échelle du wafer élimine les surcoûts de sérialisation. Le résultat est un environnement d'inférence où les vitesses de transfert de mémoire correspondent aux taux d'exécution arithmétique. Ce changement structurel permet à OpenAI de délivrer 750 jetons par seconde sans élaguer les couches du modèle, sans dégrader la précision en virgule flottante à des niveaux inexploitables, et sans sacrifier la compréhension contextuelle.
Fermer la boucle de contrôle dans les systèmes industriels et numériques
En ingénierie mécanique et dans les systèmes industriels, la latence dicte la fidélité du contrôle. Un système qui met cinq secondes à analyser la télémétrie ne peut pas participer au contrôle de supervision en boucle fermée ; il est relégué à une journalisation passive post-mortem. En réduisant la latence à une sortie quasi instantanée, OpenAI a démontré que le mode Ultrafast génère des simulations d'entrepôt 3D interactives et fonctionnelles directement à partir d'invites textuelles descriptives en temps réel. Les niveaux d'inférence standard construisent les environnements de manière incrémentale, bégayant à travers les calculs spatiaux et les déclarations d'actifs ; Ultrafast rend la logique programmatique et les géométries spatiales à des vitesses comparables à celles d'un pipeline graphique natif compilant du code.
Cette vélocité modifie la manière dont les logiciels autonomes interagissent avec les actifs physiques et numériques. Chez OpenAI, les équipes d'ingénierie ont déployé Ultrafast dans des flux de travail de réponse aux incidents automatisés. Lors de pannes de production complexes, lorsque la télémétrie distribuée, les traces mémoire et les journaux d'erreurs évoluent dynamiquement, les secondes déterminent le rayon de l'impact. Au lieu qu'un ingénieur attende la fin d'un cycle d'inférence de diagnostic prolongé, le moteur Ultrafast ingère la télémétrie multi-sources, formule des hypothèses, exécute des scripts de vérification et rédige des correctifs alors que l'anomalie se propage encore activement.
La même mécanique s'applique aux chaînes d'approvisionnement physiques et aux installations automatisées. Lorsque les flottes robotisées rencontrent des échecs de prélèvement ou des blocages spatiaux, la résolution du conflit de trajectoire nécessite la synthèse des entrées des capteurs, des contraintes cinématiques et des tables d'état de l'entrepôt. Un modèle fonctionnant à 750 jetons par seconde peut analyser le mode de défaillance non structuré, calculer des recalculs viables et émettre des commandes correctives bien dans les seuils de temporisation opérationnels standard des automates programmables industriels.
Tests de résistance en entreprise et élimination de la latence
Les tests d'accès anticipé parmi les partenaires commerciaux externes démontrent comment l'inférence à haut débit modifie la conception des logiciels commerciaux. La société de trading quantitatif Jane Street a intégré le niveau Ultrafast dans ses environnements de programmation destinés aux développeurs, faisant tomber la barrière de latence qui brise traditionnellement la concentration du programmeur lors de transformations de code complexes impliquant plusieurs fichiers. Lorsque les complétions de code et les refactorisations architecturales complètes sont générées plus vite qu'un ingénieur ne peut les parcourir, la boucle cognitive reste intacte.
Dans les applications vocales, les améliorations de latence résolvent une contrainte structurelle encore plus stricte. La plateforme de communication Podium a intégré GPT-5.6 Sol Ultrafast dans sa pile vocale de production. Historiquement, les agents vocaux conversationnels devaient s'appuyer sur de minuscules modèles hautement spécialisés pour maintenir des latences de réponse aller-retour inférieures à 500 millisecondes — le seuil au-delà duquel une conversation humaine semble brisée et artificielle. Ultrafast permet aux développeurs d'exécuter des modèles de raisonnement complets et profonds à l'intérieur de la boucle de streaming audio sans gigue conversationnelle, permettant aux agents d'analyser des requêtes complexes, de croiser des bases de données externes et de synthétiser des réponses orales sans pauses gênantes.
Les plateformes de recherche financière comme Rogo et les entreprises d'automatisation des flux de travail comme Basis signalent des changements structurels similaires. L'agrégation de documents en plusieurs étapes complexes, la modélisation financière et l'utilisation d'outils déterministes accumulent généralement de la latence à chaque invocation de sous-agent. Lorsqu'un agent analytique doit appeler une demi-douzaine d'outils séquentiellement, un délai de 10 secondes par étape rend la recherche interactive non viable. À 750 jetons par seconde, les orchestrations multi-agents terminent leurs chaînes de raisonnement de bout en bout en une fraction de seconde, convertissant l'extraction de données par lots en un dialogue analytique continu.
Le calcul économique de l'inférence sur mesure à l'échelle du wafer
Bien que les chiffres de performance du mode Ultrafast représentent un bond technique indéniable, ils introduisent également des questions infrastructurelles et économiques complexes. Le marché de l'IA à très grande échelle s'est largement consolidé autour d'architectures de racks modulaires standard équipées de GPU de commodité. Le déploiement de silicium à l'échelle du wafer nécessite une distribution d'énergie sur mesure, des boucles de refroidissement liquide personnalisées et des chaînes d'outils de compilation dédiées capables de mapper des graphes de calcul massifs sur une tranche de silicium entière sans routage de cluster standard.
L'équation des dépenses en capital pour exécuter des modèles de pointe à une vitesse 14x repose entièrement sur la densité d'utilisation. Les moteurs à l'échelle du wafer présentent une complexité de packaging et de fabrication élevée par rapport aux puces modulaires individuelles découpées à partir de lingots standard de 300 mm. Cependant, comme chaque wafer peut remplacer des dizaines de nœuds de serveur discrets tout en consommant moins de watts au total par jeton délivré, les dépenses opérationnelles de l'inférence à haute densité peuvent s'avérer avantageuses à grande échelle. Si une entreprise paie le prix fort pour un niveau API Ultrafast, mais que ce niveau élimine les temps d'inactivité des travailleurs, consolide l'infrastructure de calcul et permet des produits en temps réel auparavant impossibles, le coût total de possession bascule nettement en faveur du silicium à haut débit.
Les contraintes de capacité dicteront la vitesse de déploiement. OpenAI lance Ultrafast dans un niveau d'aperçu restreint précisément parce que la capacité à l'échelle du wafer ne peut pas être mise en place du jour au lendemain dans des installations de colocation génériques. À mesure que la fabrication de Cerebras montera en puissance et qu'OpenAI construira des clusters dédiés à faible latence, la disponibilité de modèles de pointe à 750 jetons par seconde testera si l'écosystème technologique au sens large est prêt à reconstruire ses architectures logicielles autour d'une intelligence générative instantanée.
Le passage à l'intelligence machine synchrone
La transition des vitesses d'inférence standard vers Ultrafast marque la fin d'une époque où l'intelligence machine était traitée comme une couche de consultation asynchrone. Pendant la première décennie de l'apprentissage profond commercial, les ingénieurs logiciels ont traité les réseaux neuronaux comme des requêtes de base de données à distance : soumettre une invite, attendre la sérialisation et structurer le reste de l'application autour de la pénalité de latence inévitable. Les conceptions de systèmes étaient optimisées pour masquer ce délai par des indicateurs de chargement, un rendu progressif et une pré-extraction spéculative.
À 750 jetons par seconde, tout ce paradigme de conception devient obsolète. Les modèles de pointe ne sont plus des processeurs par lots distants ; ils sont des primitives de calcul synchrones capables d'exécuter un raisonnement symbolique complexe dans les cycles d'horloge opérationnels des logiciels industriels et commerciaux contemporains. À mesure qu'OpenAI et Cerebras élargissent l'accès au-delà du groupe d'aperçu initial, l'avantage concurrentiel passera de celui qui a accès aux poids les plus intelligents à celui qui peut concevoir des systèmes exploitant pleinement une vélocité computationnelle brute et sans compromis.



Comments
No comments yet. Be the first!