In un tentativo aggressivo di difendere la propria presenza nel mercato consumer contro una competizione internazionale in rapida ascesa, OpenAI ha ufficialmente ricalibrato l'economia della propria piattaforma. L'azienda ha annunciato che il suo nuovo modello GPT-5.6 Luna fungerà ora da motore predefinito per tutti i livelli gratuiti e base, eliminando i tradizionali limiti di frequenza dei messaggi nelle conversazioni testuali standard. Parallelamente, ChatGPT ha superato il traguardo di un miliardo di utenti attivi settimanali, trasformando quella che un tempo era un'interfaccia consumer sperimentale in una delle utility di calcolo distribuito più trafficate della storia.
Distinzioni architettoniche nella generazione GPT-5.6
La famiglia di modelli GPT-5.6 si biforca in rami operativi distinti, progettati per ottimizzare la spesa di calcolo lato server rispetto alla complessità del compito. GPT-5.6 Sol funge da motore per i carichi di lavoro più intensi, dedicato a ChatGPT Plus e ai livelli aziendali, vantando una riduzione del 68 percento delle allucinazioni fattuali rispetto al precedente standard GPT-5.5 Instant. Sol incorpora una gestione granulare del calcolo tramite un cursore di interfaccia, che consente agli utenti aziendali e di ricerca di scalare il budget di ragionamento latente assegnato a un determinato prompt.
La meccanica del calcolo on-demand in fase di test
Forse l'aggiunta meccanica più significativa per l'esperienza utente gratuita è l'introduzione di un controllo di interfaccia dedicato, etichettato semplicemente come pulsante Pensiero. Storicamente, le moderne architetture di ragionamento hanno attivato automaticamente lunghe tracce di ragionamento interno — consumando enormi quantità di capacità dei cluster GPU — o si sono affidate a un campionamento autoregressivo standard che spesso fallisce su problemi spaziali, matematici o algoritmici complessi. Il nuovo controllo trasferisce l'interruttore di pianificazione direttamente all'utente.
Quando un operatore attiva il meccanismo di Pensiero, GPT-5.6 Luna passa a un ciclo di inferenza dinamico, impiegando cicli di calcolo extra misurabili per generare, criticare e potare alberi di ricerca interni di tipo "chain-of-thought" prima di emettere i token di output. Questo disaccoppiamento dell'inferenza di base dalla risoluzione intensiva di problemi risolve un dilemma logistico critico per i provider cloud. Lasciando che siano gli utenti a stabilire quando è realmente necessario un ragionamento profondo, OpenAI impedisce ai propri cluster di sprecare cicli di calcolo per ragionare su query banali, come la stesura di email o traduzioni di base.
Dal punto di vista algoritmico, ciò rappresenta un'estensione dello scaling in fase di test fino agli account consumer a costo zero. La telemetria di sistema può instradare dinamicamente le query che richiedono una deliberazione più profonda verso pool di server specializzati dotati di una maggiore larghezza di banda della memoria, mentre le query quotidiane sensibili alla latenza rimangono bloccate su nodi di inferenza ad alto throughput e bassa precisione. Questo tiering flessibile è fondamentale per mantenere la reattività in tempo reale su migliaia di carichi di lavoro aziendali simultanei che condividono le risorse fisiche dei data center.
La brutale fisica di un miliardo di utenti attivi settimanali
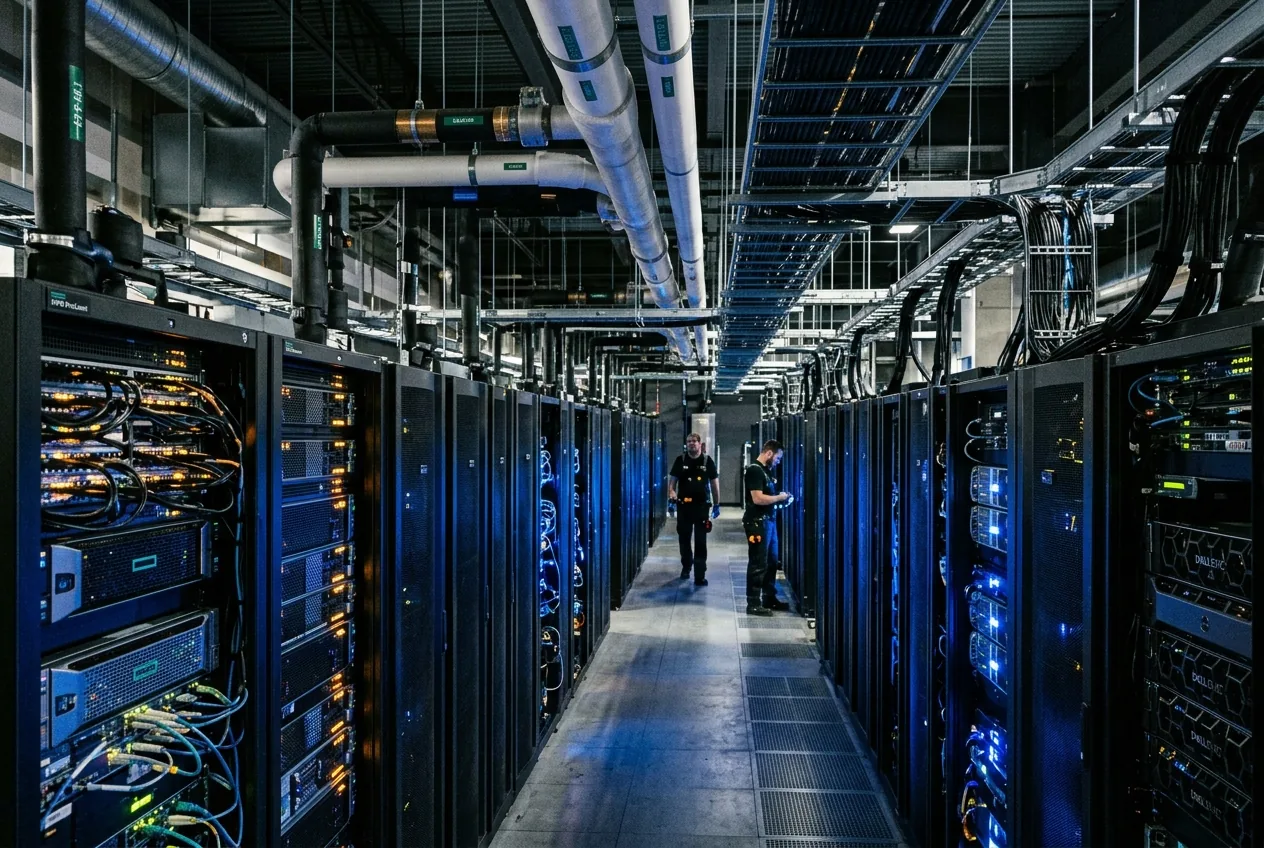
Gestire una piattaforma conversazionale che serve una base di utenti a dieci cifre ogni settimana introduce colli di bottiglia meccanici e termici che eclissano le architetture web-scale convenzionali. I servizi software tradizionali consumano cicli CPU nominali per visualizzazione di pagina, gestendo principalmente transazioni di database e caching periferico. L'inferenza dei modelli linguistici di grandi dimensioni richiede invece moltiplicazioni di matrici continue e altamente sincronizzate tra array di elaborazione tensoriale interconnessi, che esigono un'energia elettrica incessante e sistemi avanzati di scambio termico da liquido ad aria.
Rimuovere completamente i limiti di chat suggerisce che OpenAI e i suoi partner cloud abbiano ottenuto efficienze operative rivoluzionarie nella loro implementazione del silicio. La transizione comporta un'aggressiva adozione di formati di quantizzazione a bassa precisione, come l'FP8 e la matematica a virgola mobile sub-8-bit, senza destabilizzare i meccanismi di attenzione. Inoltre, i miglioramenti nella decodifica speculativa — in cui un modello di bozza iper-efficiente ipotizza diversi token in anticipo mentre il modello primario li verifica in parallelo — hanno drasticamente ridotto il tempo necessario per generare ogni risposta dell'utente.
Senza queste ottimizzazioni a livello hardware e di runtime, la spesa in conto capitale necessaria per assorbire cicli conversazionali infiniti da centinaia di milioni di utenti non monetizzati sarebbe rovinosa. L'impronta hardware necessaria per servire un miliardo di utenti settimanali non può essere sostenuta solo dai ricavi delle licenze software commerciali. Richiede un ammortamento senza precedenti delle infrastrutture in silicio, facendo affidamento sulla pura scala per ridurre i costi unitari su ogni milione di token consegnati.
Le piattaforme chiuse possono resistere alla pressione dei modelli open-weights?
Il catalizzatore principale dietro l'improvvisa generosità di OpenAI è il cambiamento tettonico delle catene di approvvigionamento globali dell'IA generativa. Negli ultimi dodici mesi, i conglomerati tecnologici cinesi e gli agili laboratori di ricerca hanno sistematicamente mercificato l'intelligenza conversazionale di base. Modelli operanti con centinaia di miliardi di parametri sono stati rilasciati con licenze open-source permissive, fornendo capacità di programmazione, matematica e traduzione di livello aziendale su macchine locali e cloud privati a una frazione dei prezzi delle API commerciali occidentali.
Questa ondata di modelli aperti ha alterato radicalmente il potere contrattuale delle imprese. Le piccole e medie aziende di software, le imprese manifatturiere e gli ingegneri dell'automazione non sono più costretti a integrare API proprietarie americane quando alternative self-hosted ad alte prestazioni possono girare all'interno di cluster hardware on-premise. Nelle regioni al di fuori del Nord America, dove la conformità normativa, la sovranità dei dati e le restrizioni all'importazione di hardware dettano le roadmap tecnologiche, i modelli open-source locali hanno ottenuto una rapida adozione aziendale.
Utilità industriale e percorso verso l'automazione fisica
Mentre l'attenzione dei consumatori si concentra sulle interfacce testuali, il vero campo di battaglia per i modelli che vantano un calo dal 62 al 68 percento degli errori fattuali risiede nei pipeline industriali automatizzati. Nella robotica industriale, nel coordinamento della visione artificiale e nelle reti logistiche automatizzate, l'intelligenza sintetica è stata a lungo limitata da latenza, imprevedibilità e allucinazioni catastrofiche. Un errore in un documento amministrativo è un inconveniente; un errore in un programma di pianificazione dei percorsi robotici o in uno script di fornitura dell'inventario può bloccare una linea di produzione o danneggiare asset meccanici.
Il perfezionamento delle architetture di ragionamento alimenta direttamente l'esecuzione dei flussi di lavoro agentici. Quando ci si può fidare che i modelli di base ragionino attraverso istruzioni di assemblaggio meccanico in più fasi, analizzino progetti complessi o traducano flussi di sensori strutturati in input di controllo deterministici, il confine tra elaborazione del testo generativo e automazione cyber-fisica svanisce. I miglioramenti operativi dimostrati nella generazione GPT-5.6 forniscono l'affidabilità di base necessaria per l'integrazione in controllori a logica programmabile, software di gestione del magazzino e nodi di edge computing operanti nelle fabbriche.
In definitiva, la transizione di OpenAI verso un framework ad accesso illimitato segna la fine della fase iniziale di scarsità dell'intelligenza artificiale. Mentre la corsa globale tra i laboratori commerciali occidentali e lo sviluppo open-source internazionale si intensifica, la principale barriera all'ingresso non è più la capacità di eseguire un modello, ma la capacità ingegneristica di scalare il calcolo distribuito in modo affidabile, conveniente e preciso su un intero pianeta di utenti che richiedono intelligenza continua.




Comments
No comments yet. Be the first!