Dans une volonté agressive de défendre son empreinte commerciale face à une concurrence internationale en pleine accélération, OpenAI a officiellement recalibré l'économie de sa plateforme. L'entreprise a annoncé que son nouveau modèle GPT-5.6 Luna servira désormais de moteur par défaut pour tous les niveaux d'accès gratuits et d'entrée de gamme, éliminant les limites traditionnelles de fréquence de messages pour les conversations textuelles standard. Parallèlement, ChatGPT a franchi le cap du milliard d'utilisateurs actifs hebdomadaires, transformant ce qui n'était autrefois qu'une interface grand public expérimentale en l'un des services d'informatique distribuée les plus fréquentés de l'histoire.
Distinctions architecturales de la génération GPT-5.6
La famille de modèles GPT-5.6 se divise en branches opérationnelles distinctes conçues pour optimiser les dépenses de calcul côté serveur en fonction de la complexité des tâches. GPT-5.6 Sol fait office de moteur de haute performance dédié aux offres ChatGPT Plus et aux entreprises, affichant une réduction de 68 % des hallucinations factuelles par rapport à la base de référence précédente, GPT-5.5 Instant. Sol intègre un pilotage granulaire du calcul via un curseur d'interface, permettant aux entreprises et aux chercheurs d'ajuster le budget de raisonnement latent alloué à une requête donnée.
La mécanique du calcul à la demande en temps de test
L'ajout mécanique le plus significatif à l'expérience utilisateur gratuite est sans doute l'introduction d'une commande d'interface dédiée, baptisée simplement bouton « Réfléchir » (Think). Historiquement, les architectures de raisonnement modernes engageaient soit automatiquement de longues traces de raisonnement interne — consommant d'énormes capacités de clusters GPU — soit s'appuyaient sur un échantillonnage autorégressif standard, souvent défaillant face à des problèmes spatiaux, mathématiques ou algorithmiques complexes. Cette nouvelle commande transfère le contrôle de la planification directement à l'utilisateur.
Lorsqu'un opérateur active le mécanisme « Réfléchir », GPT-5.6 Luna bascule dans une boucle d'inférence dynamique, consacrant des cycles de calcul supplémentaires mesurables à la génération, à la critique et à l'élagage d'arbres de recherche internes basés sur la chaîne de pensée avant d'émettre des jetons de sortie. Ce découplage entre l'inférence de base et la résolution intensive de problèmes résout un dilemme logistique critique pour les fournisseurs de cloud. En laissant les utilisateurs dicter quand un raisonnement approfondi est réellement nécessaire, OpenAI évite que ses clusters ne gaspillent des cycles de calcul à raisonner sur des requêtes triviales comme la rédaction d'e-mails ou la traduction basique.
D'un point de vue algorithmique, cela représente une extension de la mise à l'échelle en temps de test jusqu'aux comptes utilisateurs à zéro dollar. La télémétrie système peut acheminer dynamiquement les requêtes nécessitant une réflexion plus approfondie vers des pools de serveurs spécialisés dotés d'une bande passante mémoire plus élevée, tandis que les requêtes quotidiennes sensibles à la latence restent traitées par des nœuds d'inférence à haut débit et faible précision. Ce cloisonnement flexible est crucial pour maintenir une réactivité en temps réel sur des milliers de charges de travail d'entreprise simultanées partageant des ressources de centre de données physiques.
La physique brutale du milliard d'utilisateurs actifs hebdomadaires
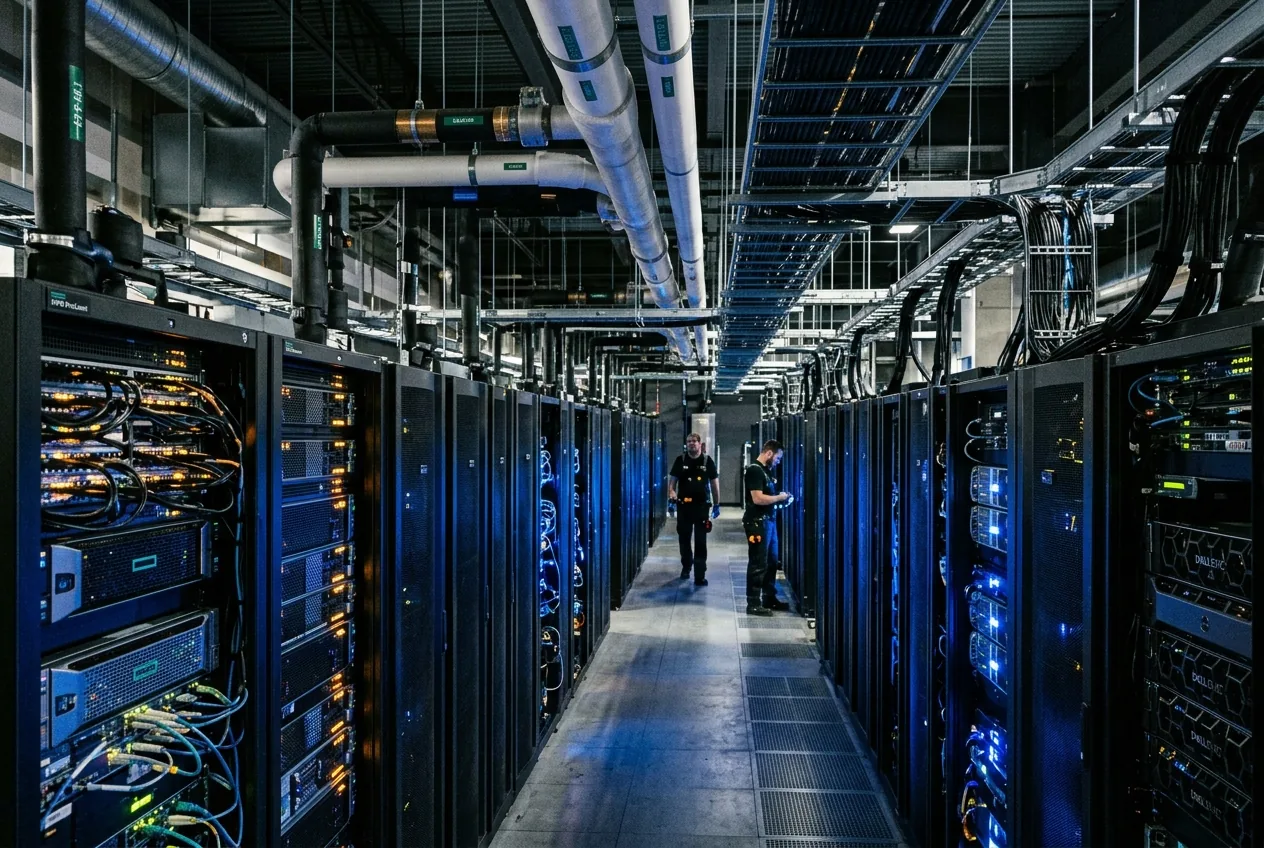
L'exploitation d'une plateforme conversationnelle desservant une base d'utilisateurs à dix chiffres chaque semaine introduit des goulots d'étranglement mécaniques et thermiques qui éclipsent les architectures web conventionnelles. Les services logiciels traditionnels consomment des cycles CPU nominaux par page vue, gérant principalement des transactions de base de données et de la mise en cache en périphérie. L'inférence de grands modèles de langage nécessite cependant des multiplications de matrices continues et hautement synchronisées sur des réseaux de traitement tensoriel interconnectés, exigeant une puissance électrique incessante et des systèmes d'échange thermique liquide-air avancés.
La levée totale des limites de chat suggère qu'OpenAI et ses partenaires cloud ont réalisé des percées en matière d'efficacité opérationnelle dans leur déploiement de silicium. Cette transition implique le déploiement agressif de formats de quantification à faible précision, tels que le FP8 et les calculs matriciels en virgule flottante inférieurs à 8 bits, sans déstabiliser les mécanismes d'attention. De plus, les améliorations du décodage spéculatif — où un modèle de brouillon hyper-efficace spécule sur plusieurs jetons à l'avance tandis que le modèle primaire les vérifie en parallèle — ont considérablement réduit le temps d'horloge nécessaire pour générer chaque réponse utilisateur.
Sans ces optimisations au niveau matériel et du runtime, les dépenses d'investissement nécessaires pour absorber des boucles conversationnelles infinies provenant de centaines de millions d'utilisateurs non monétisés seraient ruineuses. L'empreinte matérielle nécessaire pour servir un milliard d'utilisateurs hebdomadaires ne peut être soutenue par les seuls revenus des licences logicielles commerciales. Elle exige une amortisation sans précédent de l'infrastructure de silicium, s'appuyant sur l'échelle pure pour faire baisser les coûts unitaires pour chaque million de jetons délivrés.
Les plateformes fermées peuvent-elles résister à la pression des poids ouverts ?
Le catalyseur plus large derrière la soudaine générosité d'OpenAI est le changement tectonique des chaînes d'approvisionnement mondiales en IA générative. Au cours des douze derniers mois, les conglomérats technologiques chinois et les laboratoires de recherche agiles ont systématiquement banalisé l'intelligence conversationnelle de base. Des modèles fonctionnant avec des centaines de milliards de paramètres ont été publiés sous des licences open source permissives, offrant des capacités de codage, de mathématiques et de traduction de niveau entreprise à des machines locales et à des clouds privés, pour une fraction des prix des API commerciales occidentales.
Cette vague de modèles ouverts a fondamentalement modifié le levier des entreprises. Les petites et moyennes entreprises de logiciels, les firmes manufacturières et les ingénieurs en automatisation ne sont plus contraints d'intégrer des API américaines propriétaires lorsque des alternatives auto-hébergées et hautement performantes peuvent fonctionner au sein de clusters matériels sur site. Dans les régions hors Amérique du Nord, où la conformité réglementaire, la souveraineté des données et les restrictions sur l'importation de matériel dictent les feuilles de route technologiques, les modèles open source locaux ont gagné une adoption rapide en entreprise.
Utilité industrielle et voie vers l'automatisation physique
Alors que l'attention des consommateurs se concentre sur les interfaces textuelles, le véritable champ de bataille pour les modèles affichant une baisse de 62 à 68 % des erreurs factuelles se situe dans les processus industriels automatisés. En robotique industrielle, en coordination par vision par ordinateur et dans les réseaux logistiques automatisés, l'intelligence synthétique a longtemps été limitée par la latence, l'imprévisibilité et les hallucinations catastrophiques. Une erreur dans un document administratif est un inconvénient ; une erreur dans un programme de planification de trajectoire robotique ou un script d'approvisionnement d'inventaire peut paralyser une chaîne de fabrication ou endommager des actifs mécaniques.
Le perfectionnement des architectures de raisonnement alimente directement l'exécution de flux de travail agentiques. Lorsque l'on peut faire confiance aux modèles de base pour raisonner sur des instructions d'assemblage mécanique en plusieurs étapes, analyser des plans complexes ou traduire des flux de capteurs structurés en entrées de contrôle déterministes, la frontière entre le traitement de texte génératif et l'automatisation cyber-physique disparaît. Les améliorations opérationnelles démontrées par la génération GPT-5.6 fournissent la fiabilité de base nécessaire à l'intégration dans les automates programmables industriels, les logiciels de gestion d'entrepôt et les nœuds d'informatique en périphérie opérant dans les usines.
En fin de compte, la transition d'OpenAI vers un cadre d'accès illimité marque la fin de la phase initiale de rareté de l'intelligence artificielle. À mesure que la course mondiale entre les laboratoires commerciaux occidentaux et le développement open source international s'intensifie, la principale barrière à l'entrée n'est plus la capacité à exécuter un modèle — c'est la capacité technique à mettre à l'échelle le calcul distribué de manière fiable, abordable et précise sur toute une planète d'utilisateurs exigeant une intelligence continue.




Comments
No comments yet. Be the first!