In einem aggressiven Versuch, seine Nutzerbasis gegen den schnell eskalierenden internationalen Wettbewerb zu verteidigen, hat OpenAI seine Plattformökonomie offiziell neu kalibriert. Das Unternehmen kündigte an, dass sein neu vorgestelltes Modell GPT-5.6 Luna nun als Standard-Engine für alle kostenlosen und Einsteiger-Tarife dienen wird, wodurch die herkömmlichen Begrenzungen der Nachrichtenanzahl bei Standard-Textkonversationen entfallen. Gleichzeitig hat ChatGPT die Marke von einer Milliarde wöchentlich aktiver Nutzer überschritten und damit das, was einst eine experimentelle Verbraucherschnittstelle war, in einen der am stärksten frequentierten verteilten Computing-Dienste der Geschichte verwandelt.
Architektonische Unterschiede in der GPT-5.6-Generation
Die GPT-5.6-Modellfamilie gliedert sich in verschiedene operative Zweige, die darauf ausgelegt sind, den serverseitigen Rechenaufwand im Verhältnis zur Aufgabenkomplexität zu optimieren. GPT-5.6 Sol fungiert als die leistungsstarke Engine für ChatGPT Plus und Enterprise-Tarife und bietet eine um 68 Prozent geringere Rate an faktischen Halluzinationen im Vergleich zur vorherigen GPT-5.5-Instant-Basislinie. Sol integriert eine granulare Rechensteuerung über einen Interface-Schieberegler, der es Unternehmens- und Forschungsnutzern ermöglicht, das für einen bestimmten Prompt zugewiesene latente Denkbudget zu skalieren.
Die Mechanik des On-Demand-Test-Time-Compute
Die wohl bedeutendste mechanische Neuerung für das kostenlose Nutzererlebnis ist die Einführung eines dedizierten Interface-Steuerelements, das schlicht als „Think“-Button (Denk-Button) bezeichnet wird. In der Vergangenheit haben moderne Reasoning-Architekturen entweder automatisch lange interne Denkprozesse eingeleitet – was enorme Kapazitäten von GPU-Clustern verbrauchte – oder sich auf standardmäßige autoregressive Stichproben verlassen, die bei komplexen räumlichen, mathematischen oder algorithmischen Problemen häufig scheitern. Das neue Steuerelement überträgt den Planungsschalter direkt an den Benutzer.
Wenn ein Anwender den „Think“-Mechanismus aktiviert, schaltet GPT-5.6 Luna in eine dynamische Inferenzschleife. Dabei werden messbare zusätzliche Rechenzyklen aufgewendet, um interne Gedankenkettensuchbäume zu erstellen, zu bewerten und zu beschneiden, bevor Ausgabetoken generiert werden. Diese Entkopplung der Basis-Inferenz von der intensiven Problemlösung löst ein kritisches logistisches Rätsel für Cloud-Anbieter. Indem OpenAI die Nutzer entscheiden lässt, wann tiefgreifendes Schlussfolgern tatsächlich erforderlich ist, verhindert das Unternehmen, dass seine Cluster Rechenzyklen für das Durchdenken trivialer Anfragen wie das Entwerfen von E-Mails oder einfache Übersetzungen verschwenden.
Aus algorithmischer Sicht stellt dies eine Ausweitung der Test-Time-Skalierung auf kostenlose Nutzerkonten dar. System-Telemetrie kann Anfragen, die eine tiefergehende Überlegung erfordern, dynamisch an spezialisierte Server-Pools mit höherer Speicherbandbreite weiterleiten, während alltägliche, latenzempfindliche Abfragen auf Inferenzknoten mit hohem Durchsatz und geringer Präzision verbleiben. Diese flexible Staffelung ist entscheidend, um die Echtzeit-Reaktionsfähigkeit bei Tausenden gleichzeitiger Unternehmens-Workloads aufrechtzuerhalten, die sich physische Rechenzentrumsressourcen teilen.
Die brutale Physik von einer Milliarde wöchentlich aktiver Nutzer
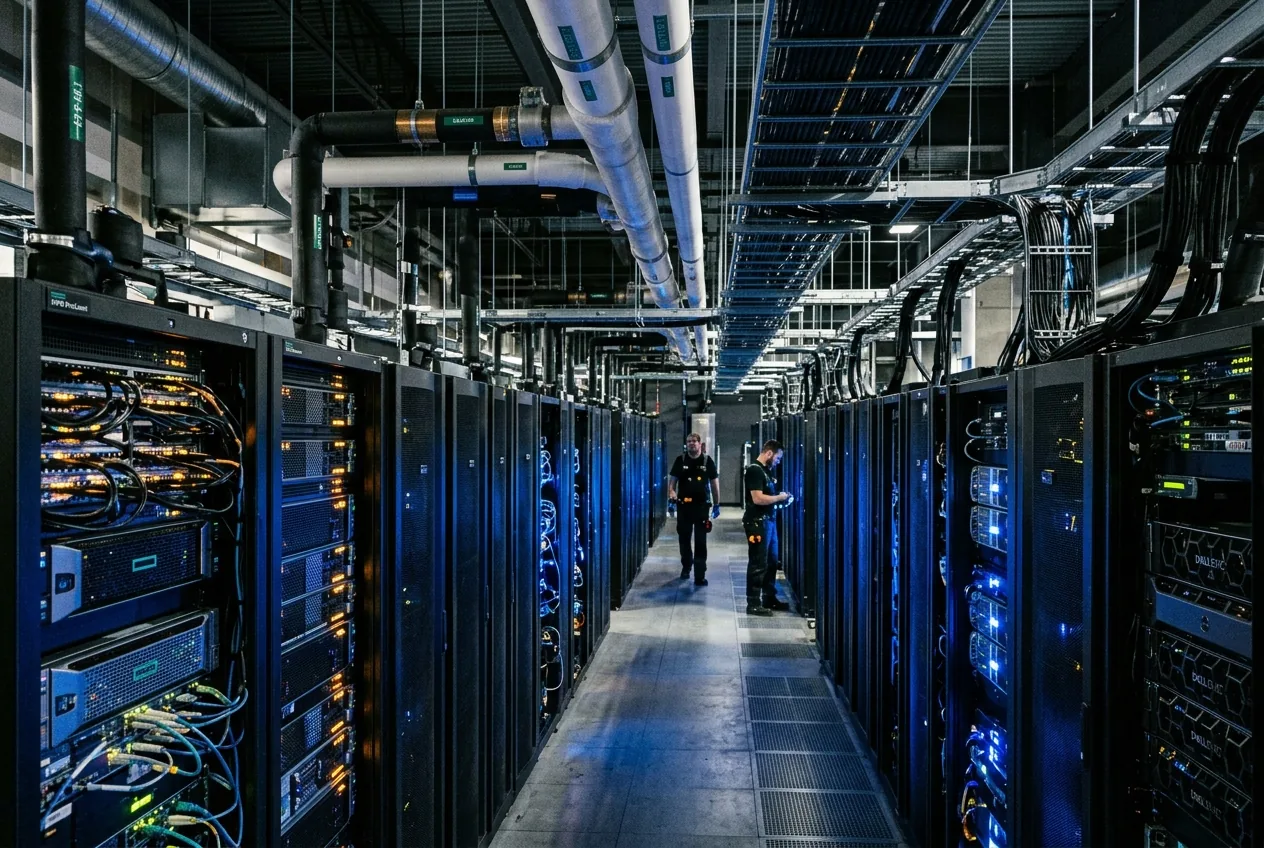
Der Betrieb einer Konversationsplattform, die wöchentlich eine zehnstellige Nutzerbasis bedient, führt zu mechanischen und thermischen Engpässen, die herkömmliche Web-Skalen-Architekturen in den Schatten stellen. Traditionelle Software-Dienste verbrauchen pro Seitenaufruf nur minimale CPU-Zyklen und verwalten hauptsächlich Datenbanktransaktionen und Edge-Caching. Die Inferenz von großen Sprachmodellen erfordert hingegen kontinuierliche, hochgradig synchronisierte Matrixmultiplikationen über miteinander verbundene Tensor-Processing-Arrays, was unaufhörlichen elektrischen Strom und fortschrittliche Flüssigkeits-Luft-Wärmeaustauschsysteme erfordert.
Das vollständige Aufheben von Chat-Limits deutet darauf hin, dass OpenAI und seine Cloud-Partner bahnbrechende betriebliche Effizienzen bei ihrem Silizium-Einsatz erreicht haben. Der Übergang beinhaltet den aggressiven Einsatz von Quantisierungsformaten mit niedriger Präzision, wie etwa FP8 und Sub-8-Bit-Fließkomma-Matrixmathematik, ohne die Aufmerksamkeitsmechanismen zu destabilisieren. Darüber hinaus haben Verbesserungen beim spekulativen Decoding – bei dem ein hocheffizientes Entwurfsmodell mehrere Token im Voraus spekuliert, während das Primärmodell diese parallel verifiziert – die Zeit, die zur Generierung jeder Nutzerantwort benötigt wird, drastisch verkürzt.
Ohne diese Optimierungen auf Hardware- und Laufzeitebene wären die Investitionskosten, um unendliche Konversationsschleifen von Hunderten Millionen nicht monetarisierter Nutzer aufzufangen, ruinös. Der Hardware-Fußabdruck, der erforderlich ist, um eine Milliarde wöchentliche Nutzer zu bedienen, lässt sich nicht allein durch kommerzielle Software-Lizenzgebühren aufrechterhalten. Er erfordert eine beispiellose Amortisation der Silizium-Infrastruktur, die auf reiner Skalierung basiert, um die Stückkosten über jede Million gelieferter Token zu senken.
Können geschlossene Plattformen dem Druck der offenen Gewichte standhalten?
Der breitere Katalysator für die plötzliche Großzügigkeit von OpenAI ist die Verschiebung der tektonischen Platten in den globalen Lieferketten für generative KI. In den letzten zwölf Monaten haben chinesische Technologiekonzerne und agile Forschungslabore die grundlegende Konversationsintelligenz systematisch zur Massenware gemacht. Modelle mit Hunderten Milliarden von Parametern wurden mit permissiven Open-Source-Lizenzen veröffentlicht und bieten Unternehmens-Coding, Mathematik und Übersetzungsfähigkeiten für lokale Maschinen und private Clouds zu einem Bruchteil der Preise westlicher kommerzieller APIs.
Dieser Anstieg offener Modelle hat die Verhandlungsmacht von Unternehmen grundlegend verändert. Kleine bis mittelständische Softwarebetriebe, Fertigungsfirmen und Automatisierungsingenieure sind nicht mehr gezwungen, proprietäre amerikanische APIs zu integrieren, wenn selbst gehostete, leistungsstarke Alternativen auf lokalen Hardware-Clustern laufen können. In Regionen außerhalb Nordamerikas, in denen regulatorische Compliance, Datensouveränität und Hardware-Importbeschränkungen die Technologie-Roadmaps bestimmen, haben lokale Open-Source-Modelle schnell an Bedeutung in Unternehmen gewonnen.
Industrieller Nutzen und der Weg zur physischen Automatisierung
Während sich die Aufmerksamkeit der Verbraucher auf Textoberflächen konzentriert, liegt das wahre Schlachtfeld für Modelle, die mit einem Rückgang der faktischen Fehler um 62 bis 68 Prozent aufwarten können, in automatisierten industriellen Pipelines. In der industriellen Robotik, der Koordination durch Computer Vision und in automatisierten Logistiknetzwerken war die synthetische Intelligenz lange Zeit durch Latenz, Unvorhersehbarkeit und katastrophale Halluzinationen eingeschränkt. Ein Fehler in einem Verwaltungsdokument ist unbequem; ein Fehler in einem Roboterprogramm zur Pfadplanung oder einem Skript für die Bestandsversorgung kann eine Fertigungslinie stilllegen oder mechanische Anlagen beschädigen.
Die Verfeinerung von Reasoning-Architekturen fließt direkt in die Ausführung von agentischen Workflows ein. Wenn grundlegende Modelle darauf vertraut werden können, mehrstufige mechanische Montageanleitungen zu durchdenken, komplexe Baupläne zu analysieren oder strukturierte Sensorströme in deterministische Steuereingaben zu übersetzen, verschwindet die Grenze zwischen generativer Textverarbeitung und cyber-physischer Automatisierung. Die operativen Verbesserungen, die in der GPT-5.6-Generation demonstriert werden, bieten die grundlegende Zuverlässigkeit, die für die Integration in speicherprogrammierbare Steuerungen (SPS), Lagerverwaltungssoftware und Edge-Computing-Knoten in Fabrikhallen erforderlich ist.
Letztendlich markiert der Übergang von OpenAI zu einem Rahmenwerk mit unbegrenztem Zugang das Ende der anfänglichen Knappheitsphase der künstlichen Intelligenz. Da sich das globale Rennen zwischen westlichen kommerziellen Laboren und der internationalen Open-Source-Entwicklung intensiviert, ist die Haupteintrittsbarriere nicht mehr die Fähigkeit, ein Modell auszuführen – es ist die technische Fähigkeit, verteilte Rechenleistung zuverlässig, erschwinglich und präzise über einen ganzen Planeten von Nutzern hinweg zu skalieren, die kontinuierliche Intelligenz fordern.




Kommentare
Noch keine Kommentare. Seien Sie der Erste!