En un intento agresivo por defender su cuota de mercado frente a una competencia internacional que se intensifica rápidamente, OpenAI ha recalibrado oficialmente la economía de su plataforma. La compañía anunció que su recién presentado modelo GPT-5.6 Luna será ahora el motor predeterminado para todos los niveles gratuitos y de entrada, eliminando los límites tradicionales de frecuencia de mensajes en las conversaciones de texto estándar. Simultáneamente, ChatGPT superó el hito de los mil millones de usuarios activos semanales, transformando lo que alguna vez fue una interfaz de consumo experimental en una de las utilidades de computación distribuida con mayor tráfico de la historia.
Distinciones arquitectónicas en la generación GPT-5.6
La familia de modelos GPT-5.6 se bifurca en ramas operativas distintas diseñadas para optimizar el gasto en computación del lado del servidor frente a la complejidad de las tareas. GPT-5.6 Sol funciona como el motor de alto rendimiento dedicado a ChatGPT Plus y a los niveles empresariales, alardeando de una reducción del 68 por ciento en alucinaciones factuales en comparación con la base previa de GPT-5.5 Instant. Sol incorpora una dirección de computación granular mediante un control deslizante en la interfaz, lo que permite a los usuarios corporativos y de investigación ajustar el presupuesto de razonamiento latente asignado a un prompt determinado.
La mecánica de la computación bajo demanda en tiempo de prueba
Quizás la adición mecánica más significativa para la experiencia del usuario gratuito es la introducción de un control de interfaz dedicado etiquetado simplemente como el botón Think. Históricamente, las arquitecturas de razonamiento modernas han activado automáticamente trazas de razonamiento interno largas —consumiendo cantidades masivas de capacidad de clúster de GPU— o se han basado en muestreos autorregresivos estándar que frecuentemente fallan en problemas espaciales, matemáticos o algorítmicos complejos. El nuevo control transfiere el interruptor de programación directamente al usuario.
Cuando un operador activa el mecanismo Think, GPT-5.6 Luna cambia a un bucle de inferencia dinámico, dedicando ciclos de computación extra medibles a generar, criticar y podar árboles de búsqueda de cadena de pensamiento internos antes de emitir los tokens de salida. Este desacoplamiento de la inferencia base del razonamiento intensivo resuelve un dilema logístico crítico para los proveedores de la nube. Al permitir que los usuarios dicten cuándo es realmente necesario un razonamiento profundo, OpenAI evita que sus clústeres gasten ciclos de computación razonando a través de consultas triviales como la redacción de correos electrónicos o la traducción básica.
Desde un punto de vista algorítmico, esto representa una expansión del escalado en tiempo de prueba a las cuentas de usuario de cero dólares. La telemetría del sistema puede enrutar dinámicamente las consultas que solicitan una deliberación más profunda a grupos de servidores especializados equipados con un mayor ancho de banda de memoria, mientras que las consultas cotidianas sensibles a la latencia permanecen fijadas en nodos de inferencia de alto rendimiento y baja precisión. Este escalonamiento flexible es crucial para mantener la capacidad de respuesta en tiempo real a través de miles de cargas de trabajo empresariales simultáneas que comparten recursos físicos de centros de datos.
La brutal física de mil millones de usuarios activos semanales
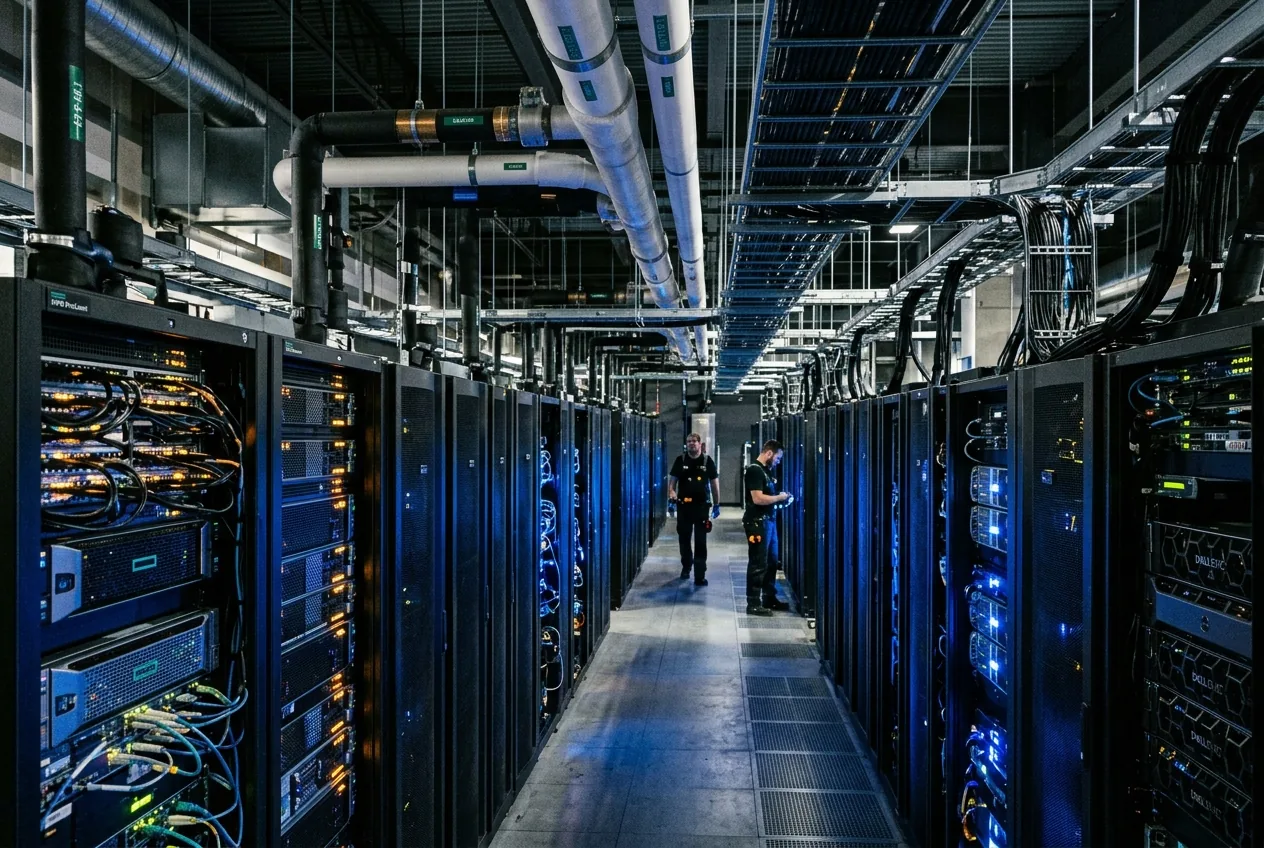
Operar una plataforma conversacional que sirve a una base de usuarios de diez cifras semanalmente introduce cuellos de botella mecánicos y térmicos que empequeñecen las arquitecturas web convencionales. Los servicios de software tradicionales consumen ciclos de CPU nominales por visita a la página, gestionando principalmente transacciones de bases de datos y caché de borde. La inferencia de modelos de lenguaje de gran tamaño, sin embargo, requiere multiplicaciones de matrices continuas y altamente sincronizadas a través de matrices de procesamiento de tensores interconectadas, exigiendo una energía eléctrica implacable y sistemas avanzados de intercambio térmico de líquido a aire.
Eliminar los límites de chat por completo sugiere que OpenAI y sus socios de nube han logrado eficiencias operativas innovadoras en su despliegue de silicio. La transición implica un despliegue agresivo de formatos de cuantización de baja precisión, como FP8 y matemáticas de matriz de punto flotante de menos de 8 bits, sin desestabilizar los mecanismos de atención. Además, las mejoras en la decodificación especulativa —en la que un modelo de borrador hiper eficiente especula varios tokens por delante mientras el modelo principal los verifica en paralelo— han comprimido drásticamente el tiempo de reloj necesario para generar cada respuesta del usuario.
Sin estas optimizaciones a nivel de hardware y tiempo de ejecución, el gasto de capital necesario para absorber bucles de conversación infinitos de cientos de millones de usuarios no monetizados sería ruinoso. La huella de hardware necesaria para atender a mil millones de usuarios semanales no puede sostenerse solo con los ingresos por licencias de software comercial. Exige una amortización sin precedentes de la infraestructura de silicio, confiando en la mera escala para reducir los costos unitarios por cada millón de tokens entregados.
¿Pueden las plataformas cerradas resistir la presión de los pesos abiertos?
El catalizador más amplio detrás de la repentina generosidad de OpenAI es el cambio de placa tectónica de las cadenas de suministro globales de IA generativa. En los últimos doce meses, los conglomerados tecnológicos chinos y los laboratorios de investigación ágiles han mercantilizado sistemáticamente la inteligencia conversacional base. Se han lanzado modelos que operan con cientos de miles de millones de parámetros bajo licencias de código abierto permisivas, proporcionando capacidades de codificación, matemáticas y traducción de grado empresarial a máquinas locales y nubes privadas a una fracción de los precios de las API comerciales occidentales.
Este aumento de modelos abiertos ha alterado fundamentalmente el apalancamiento empresarial. Las operaciones de software pequeñas y medianas, las empresas de fabricación y los ingenieros de automatización ya no están obligados a integrar API estadounidenses propietarias cuando existen alternativas autohospedadas de alto rendimiento que pueden ejecutarse dentro de clústeres de hardware locales. En regiones fuera de Norteamérica, donde el cumplimiento normativo, la soberanía de los datos y las restricciones a la importación de hardware dictan las hojas de ruta tecnológicas, los modelos locales de código abierto han ganado una rápida adopción empresarial.
Utilidad industrial y el camino hacia la automatización física
Aunque la atención del consumidor se centra en las interfaces de texto, el verdadero campo de batalla para los modelos que presumen de una caída del 62 al 68 por ciento en errores factuales se encuentra en los procesos industriales automatizados. En la robótica industrial, la coordinación mediante visión artificial y las redes logísticas automatizadas, la inteligencia sintética ha estado restringida durante mucho tiempo por la latencia, la imprevisibilidad y las alucinaciones catastróficas. Un error en un documento administrativo es un inconveniente; un error en un programa de planificación de rutas robóticas o en un script de suministro de inventario puede detener una línea de fabricación o dañar activos mecánicos.
El refinamiento de las arquitecturas de razonamiento alimenta directamente la ejecución de flujos de trabajo agentes. Cuando se puede confiar en que los modelos fundamentales razonarán a través de instrucciones de ensamblaje mecánico de varios pasos, analizarán planos complejos o traducirán flujos de sensores estructurados en entradas de control deterministas, el límite entre el procesamiento de texto generativo y la automatización ciberfísica desaparece. Las mejoras operativas demostradas en la generación GPT-5.6 proporcionan la fiabilidad base requerida para la integración en controladores lógicos programables, software de gestión de almacenes y nodos de computación de borde que operan en plantas de fabricación.
En última instancia, la transición de OpenAI hacia un marco de acceso ilimitado marca el fin de la fase inicial de escasez de la inteligencia artificial. A medida que se intensifica la carrera global entre los laboratorios comerciales occidentales y el desarrollo internacional de código abierto, la principal barrera de entrada ya no es la capacidad de ejecutar un modelo, sino la capacidad de ingeniería para escalar la computación distribuida de manera confiable, asequible y precisa en todo un planeta de usuarios que demandan inteligencia continua.




Comments
No comments yet. Be the first!